
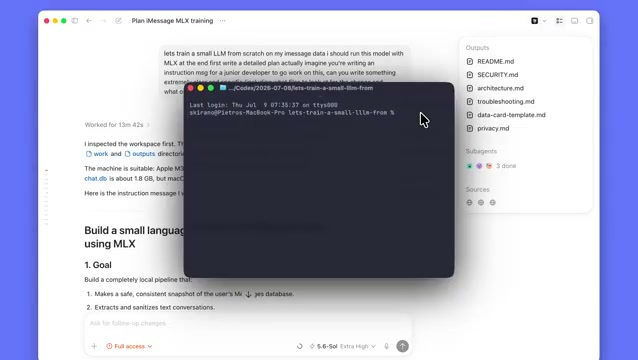
 CASE 01デモ
コーディングとビルド
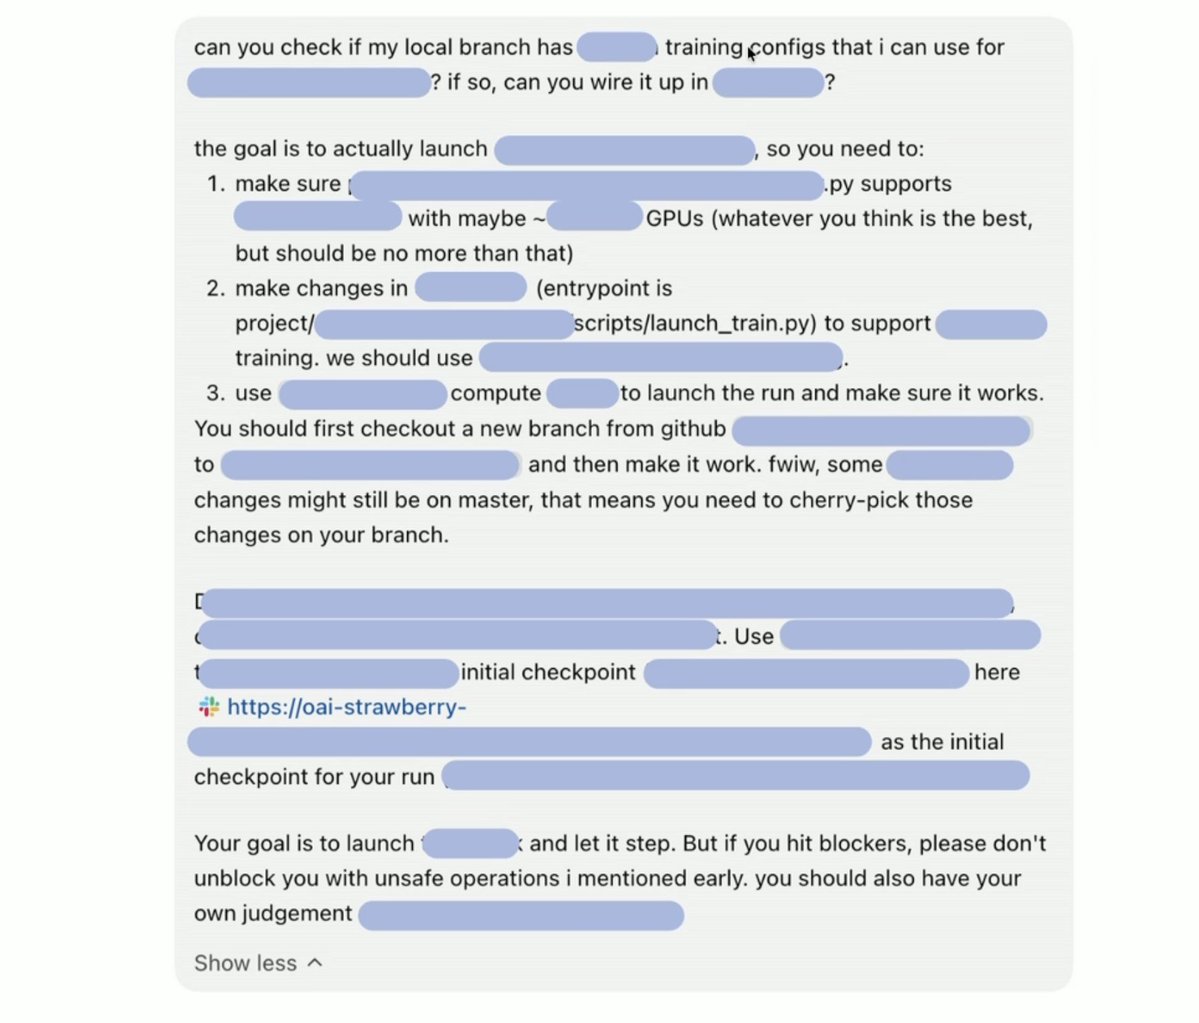
iMessage から個人モデルをトレーニングする
GPT-5.6 を使用して、プライベート メッセージ履歴から個人的な書き方を学習するローカル トレーニング パイプラインを構築して実行します。
最近の更新 / (上海時間)
林悦己 / アーカイブ
自律的コーディング、エージェント協働、クリエイティブ制作、能力の限界まで、GPT-5.6の実例を確認できます。
USE CASE MAP / 01
167件の公開事例から、要点、証拠タイプ、作者、元ソースを保持し、再利用すべき方法をすばやく判断できます。
HOW TO USE / 02
タスク分類で候補を絞り、元ソースで文脈を確認し、EvoLinkで価値の高い流れを再現します。
コーディング、エージェント、制作、評価などから範囲を絞ります。
タイトル、方法、作者から現在の課題に近い事例を探します。
作者名からデモ、制約、文脈、完全な説明を確認します。
検証したい方法を選び、モデルに接続して自分のフローにします。
REAL CREATOR CASES / 03
1行最大4件。作者名を選ぶと元の事例を開けます。画像と動画は必要なときだけ読み込みます。
167 件
CASE 01デモGPT-5.6 を使用して、プライベート メッセージ履歴から個人的な書き方を学習するローカル トレーニング パイプラインを構築して実行します。
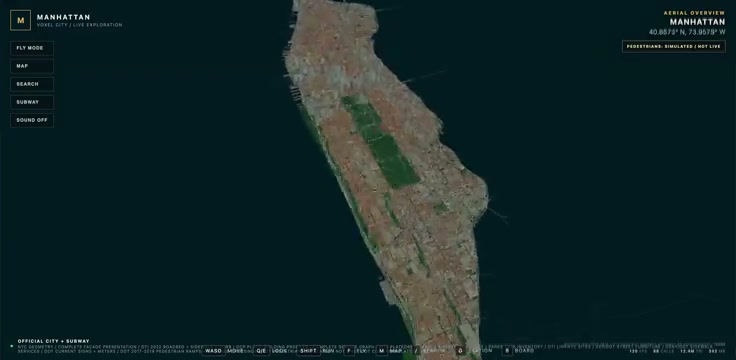 CASE 02デモ
長時間実行されるコーディング エージェントにボクセル マンハッタン ビルドを与え、数日間にわたって自律的に動作させます。
 CASE 03デモ
音声による自然言語仕様をエンドツーエンドのサービス ビルドに変換します。
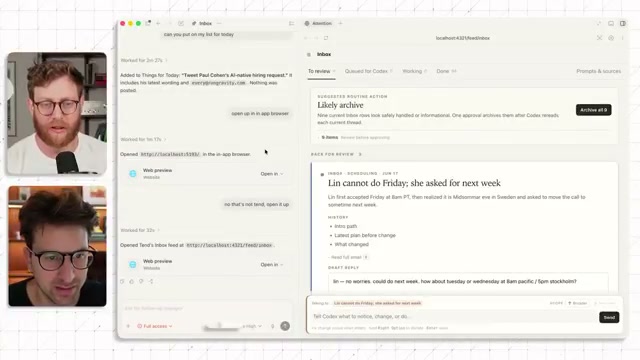 CASE 04チュートリアル
反復的な 1 つのタスクから開始し、Codex に関連ツールへのアクセスを許可し、確実に機能するようになったらワークフローを拡張します。
 CASE 05デモ
GPT-5.6 自身の作品をレビューするときは、批評パスとして 2 番目のエージェントを使用します。
 CASE 06チュートリアル
MP4 をワークスペースにドロップし、自然言語で簡潔なプロモーション カットをリクエストします。
 CASE 07連携
GPT-5.6 を広告制作 MCP に接続すると、エージェントはブランド コンテキスト、ビデオ ツール、再利用可能なスキルを 1 つのワークフローで使用できるようになります。
 CASE 08連携
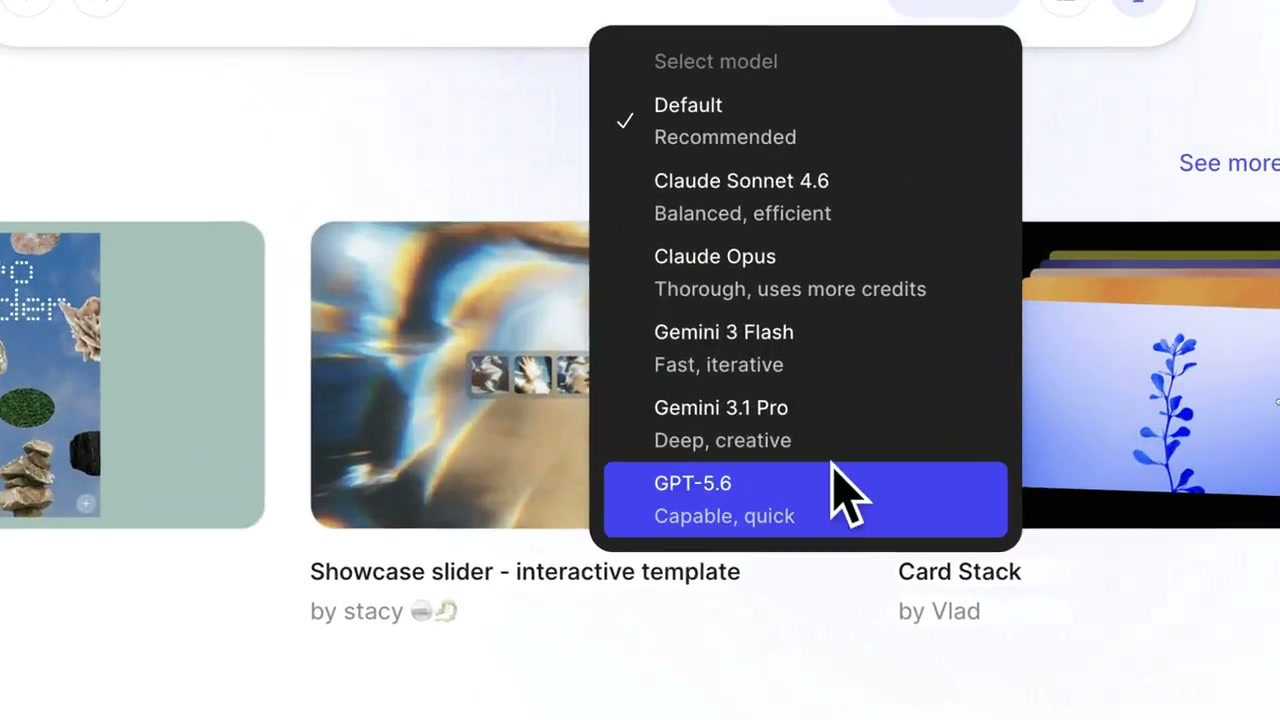
既存のデザインから構築する場合は、Figma Make で GPT-5.6 を使用し、出力強度とトークン効率を比較します。
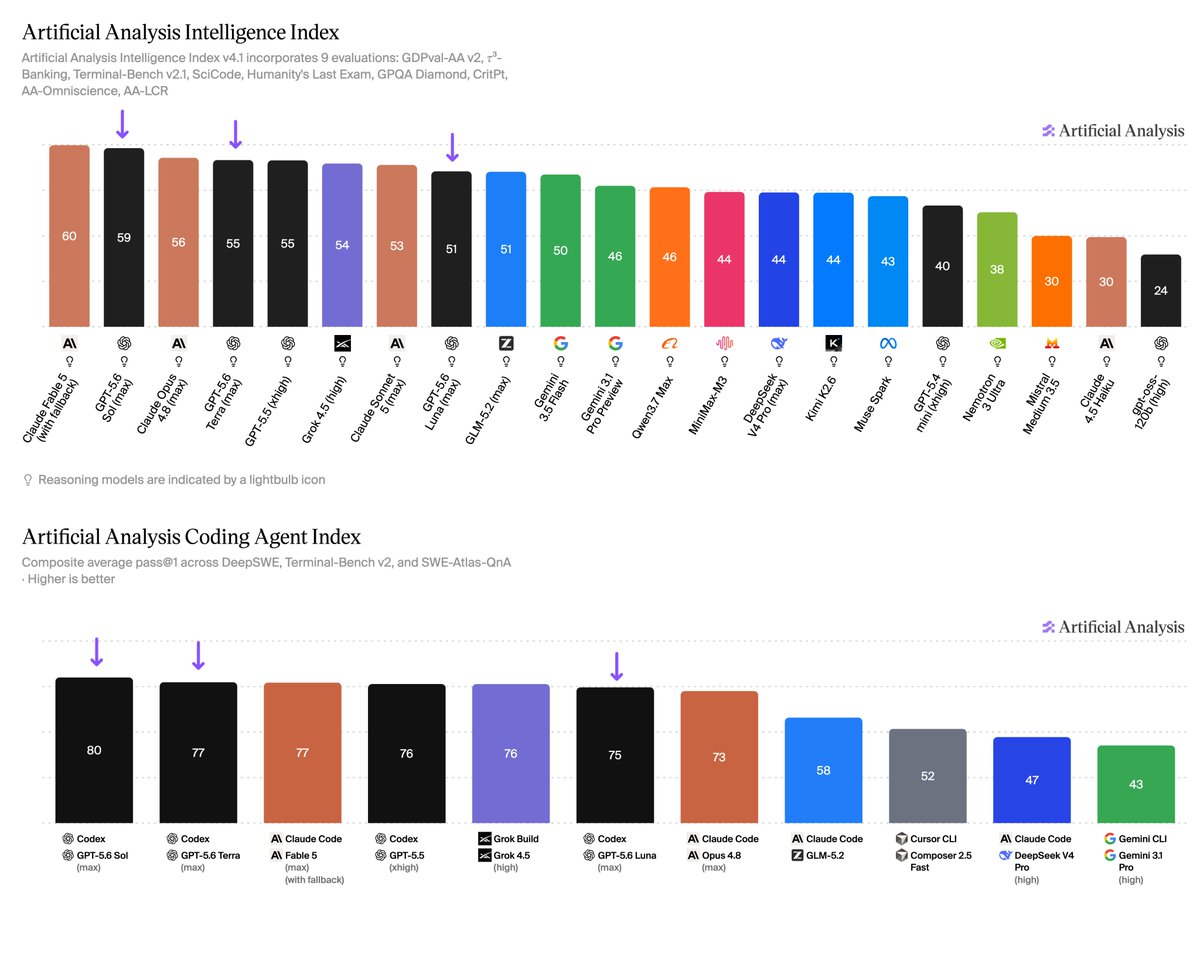 CASE 09ベンチマーク
サードパーティのベンチマーク結果を使用して、インテリジェンス、コーディング パフォーマンス、タスクあたりのコストに基づいて Sol、Terra、または Luna を選択します。
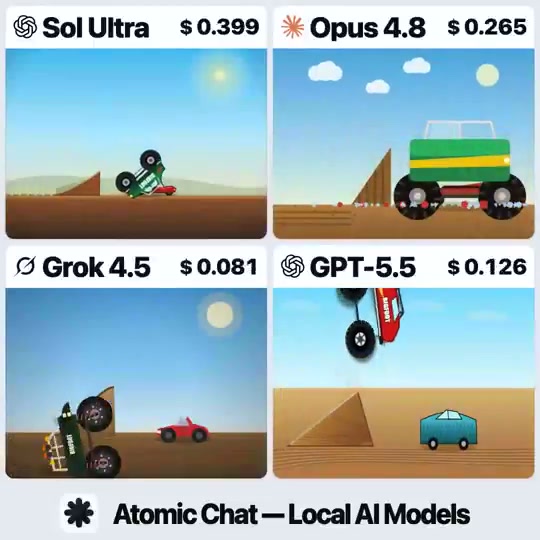 CASE 10評価
ブラウザベースのシミュレーションに Sol Ultra を選択する前に、視覚的な洗練さと物理的な正確さを個別にベンチマークします。
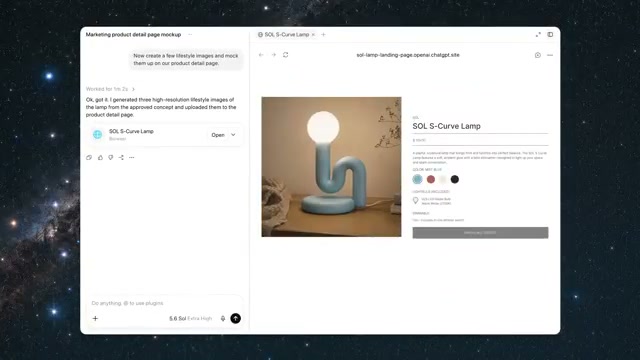 CASE 11デモ
ChatGPT Work を使用すると、複数のアプリやファイル間で作業を行い、プロジェクトに何時間も参加し、完了した作業を返すことができます。
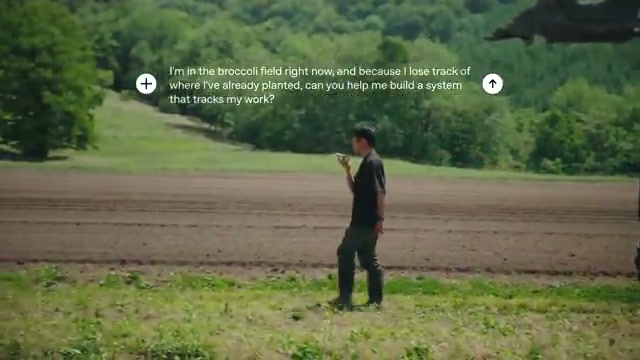 CASE 12デモ
現場での運用上の問題を説明し、GPT-5.6 を使用してそれを中心とした追跡および自動化のワークフローを構築します。
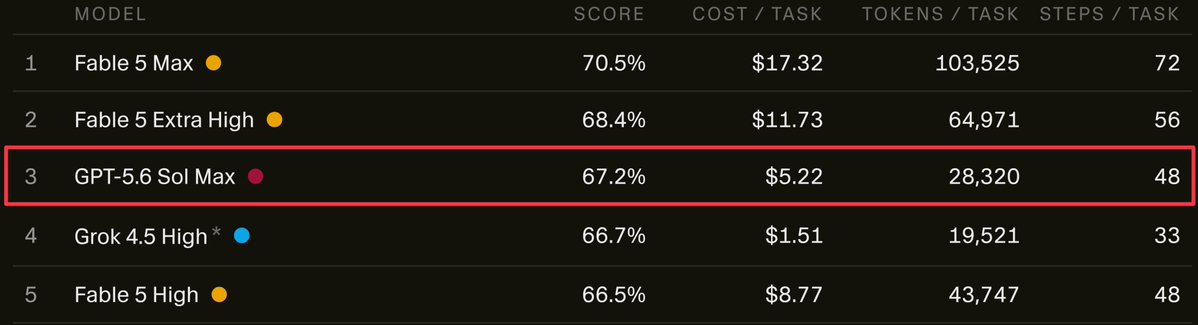 CASE 13ベンチマーク
スコアだけでコーディング モデルをランク付けするのではなく、ベンチマーク スコア、タスク コスト、トークンの使用量を組み合わせて比較します。
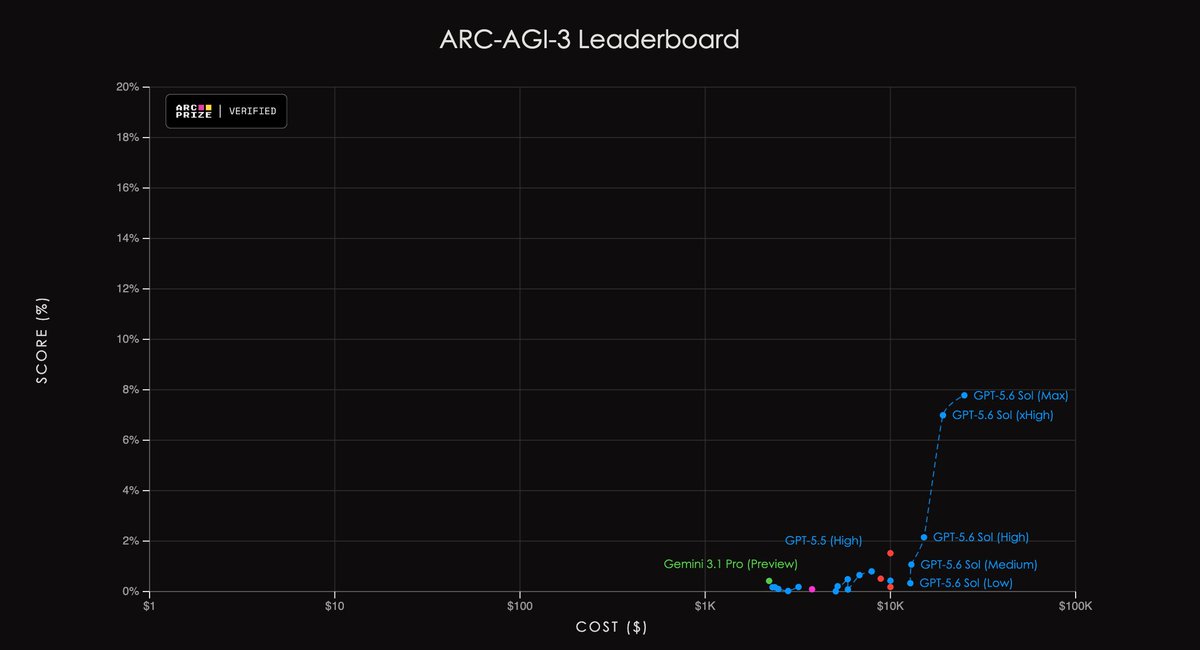 CASE 14ベンチマーク
ARC-AGI-3 を使用して、不慣れな対話型タスクにおいてモデルがどの程度適切に適応しているかをテストします。
 CASE 15連携
Nous Portal をモデル アクセス レイヤとして、Hermes Agent 内で GPT-5.6 を使用します。
 CASE 16デモ
GPT-5.6 Sol に完全なリサーチ プロンプトを与え、それを GPT-5.6 Luna のトレーニング後のプロセスの設計に使用します。
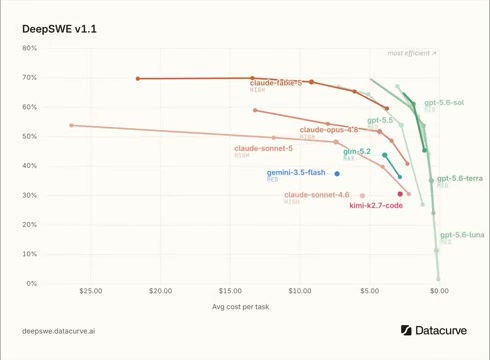 CASE 17ベンチマーク
ティアを選択する前に、同じソフトウェア エンジニアリング リーダーボードで Sol、Terra、Luna を比較してください。
 CASE 18評価
大規模なモデル試験から結論を引き出す前に、エージェントの活動の総計と完了したプロジェクトを確認します。
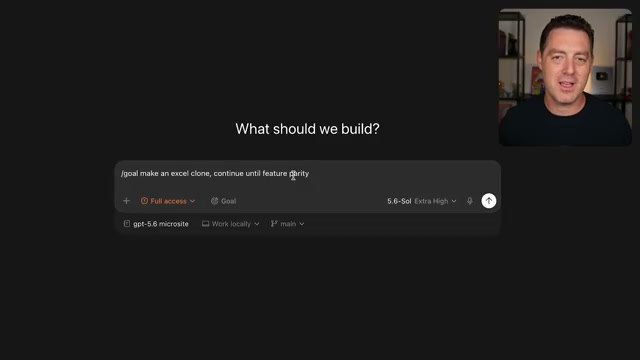 CASE 19評価
小規模な編集、ブラウザ操作、数日にわたるビルドには 1 人のエージェントを使用し、結果として生じるアクションの承認は維持します。
 CASE 20連携
統合デスクトップ アプリを使用して、インライン編集、プルリクエストのレビュー、マルチリポジトリの作業、およびコンピュータの高速使用を実現します。
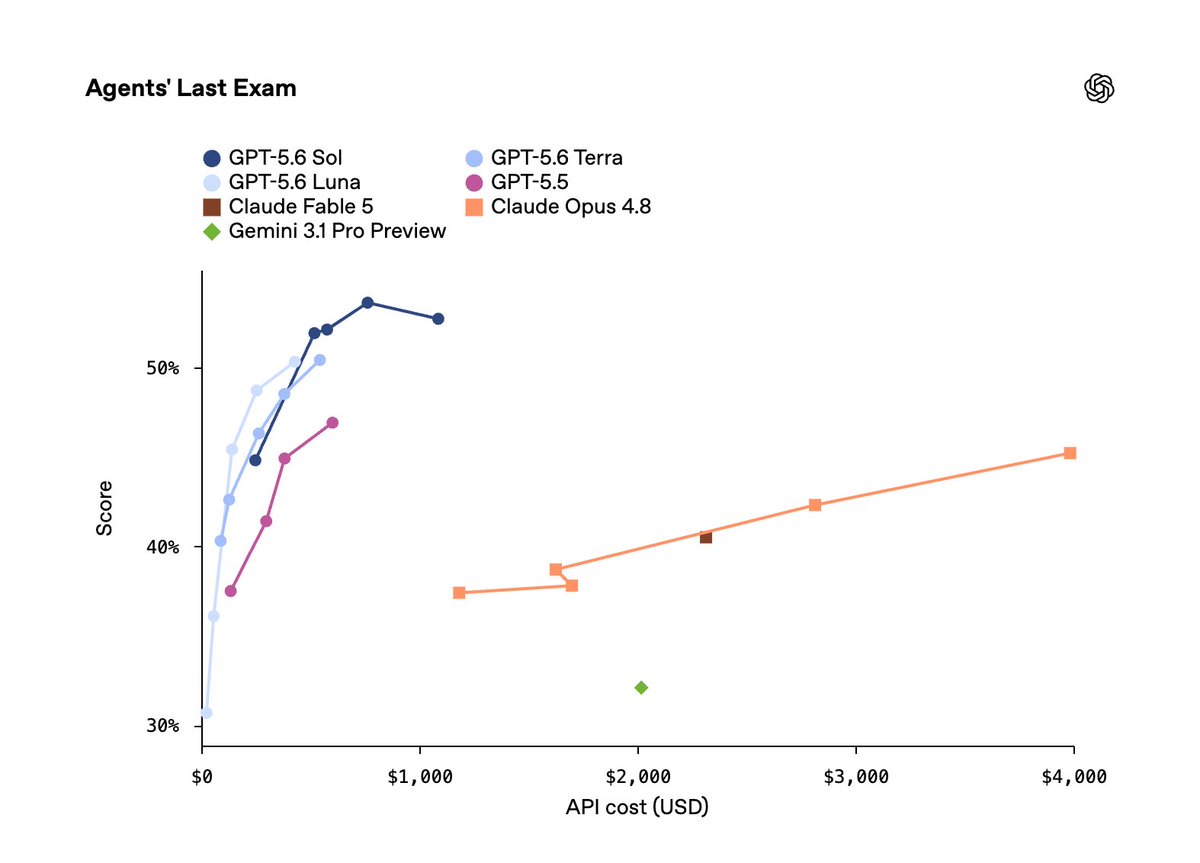 CASE 21ベンチマーク
同じ推論設定でエージェントのベンチマーク スコアと推定コストを比較します。
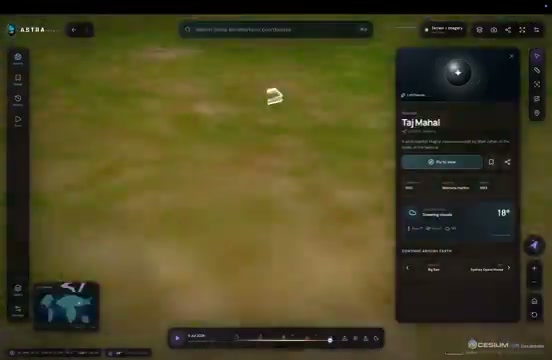 CASE 22デモ
長期実行ビルドを使用して、3D 地形、衛星画像、天気、検索、映画のようなナビゲーションを組み合わせます。
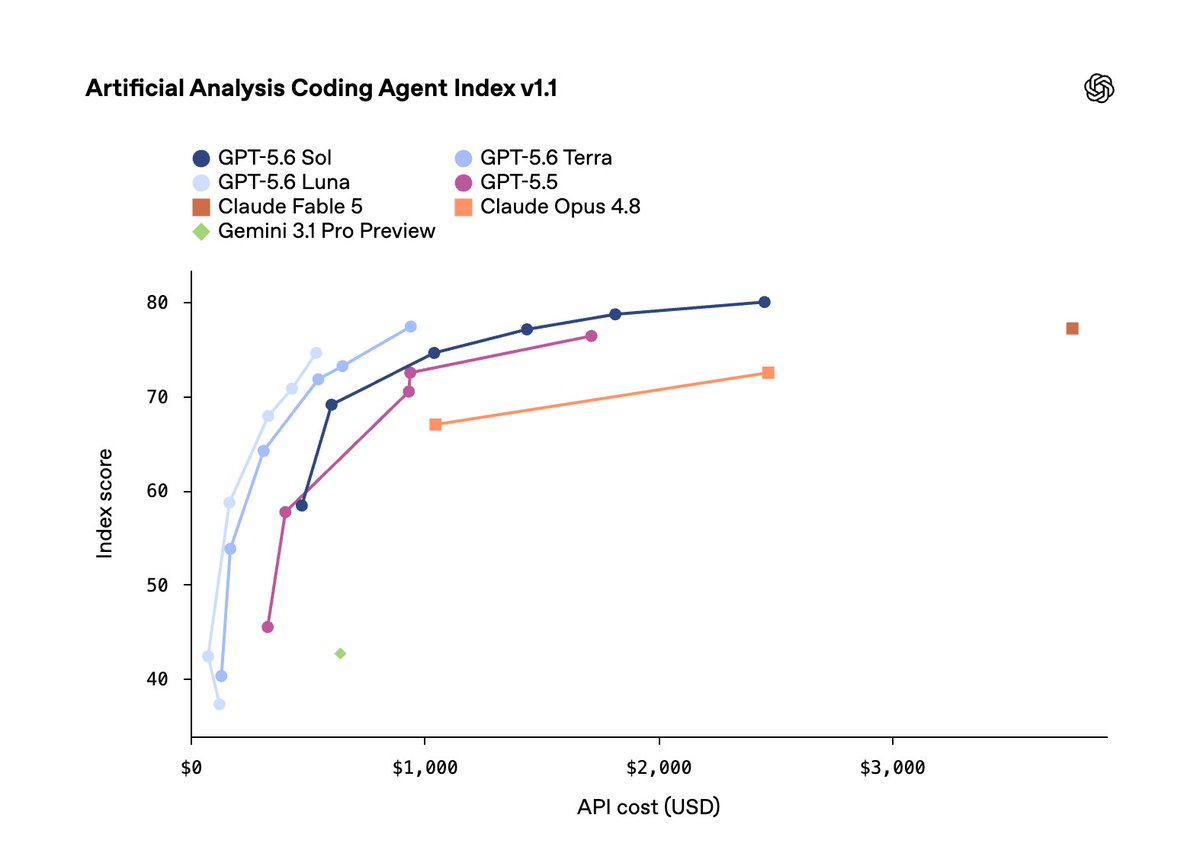 CASE 23ベンチマーク
出力トークン、経過時間、タスクコストとともにコーディングスコアを評価します。
 CASE 24評価
>GPT-5.6 を広範な知識作業ループと実装に使用し、最も困難なアーキテクチャ作業には他のモデルを確保します。
 CASE 25連携
展開インフラストラクチャを 1 つのエージェント環境に維持しながら、GPT-5.6 Sol と Fable 5 の間でビルド タスクをルーティングします。
 CASE 26連携
Sol、Terra、または Luna を、GitHub Copilot での長時間にわたる推論、日常のコーディング、または高速で低コストのタスクに適合させます。
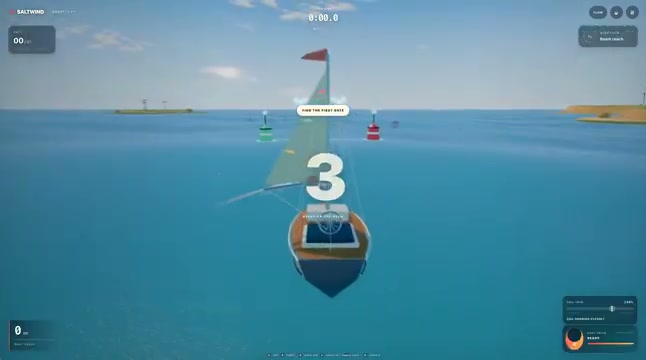 CASE 27デモ
エージェントに、レンダリングされた出力を検査させ、視覚的または機能的な欠陥を見つけて、引き継ぎ前に修正してもらいます。
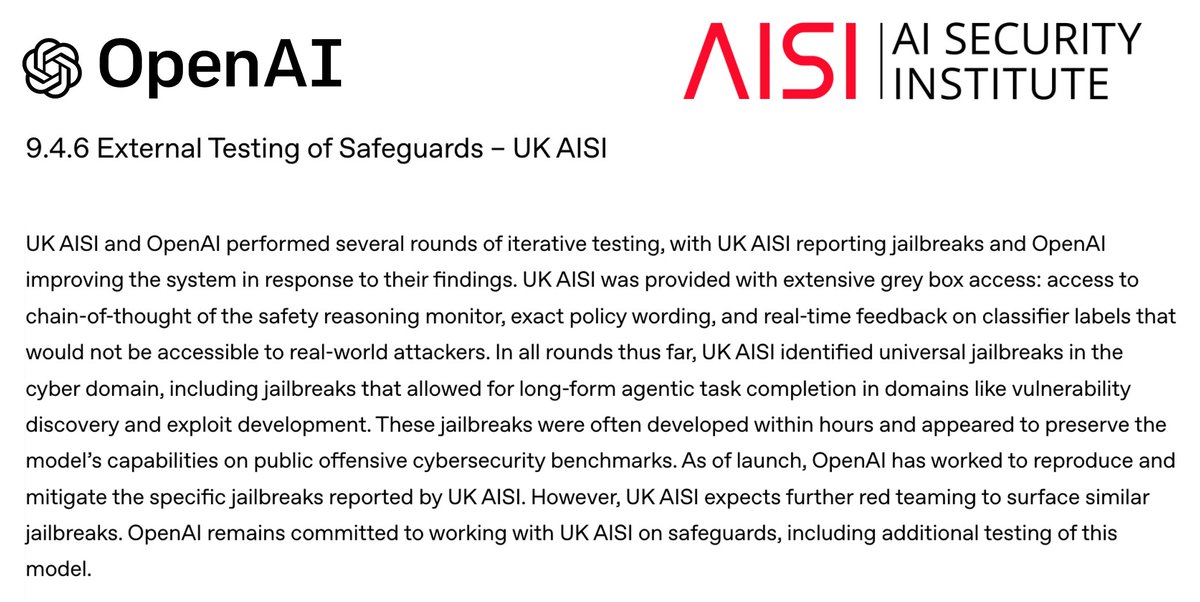 CASE 28制限
テストでは依然として長形式のエージェント攻撃が到達可能であったため、サイバーセキュリティ保護手段を展開上の制約として扱います。
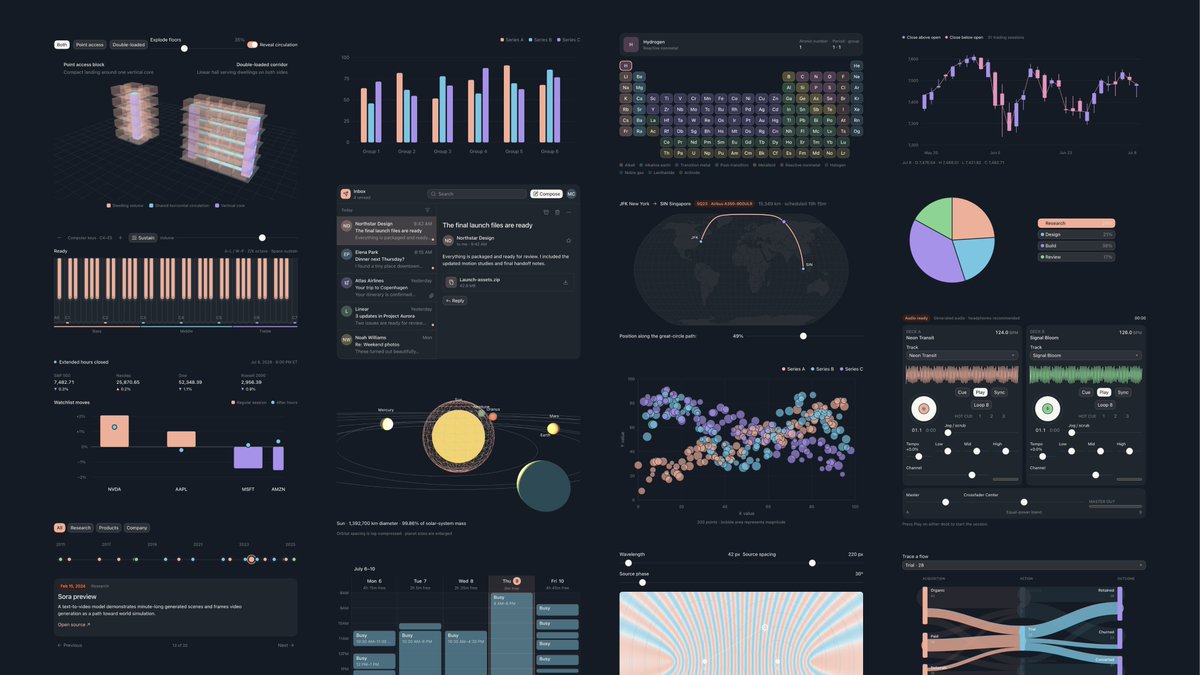 CASE 29デモ
データと概念をグラフ、ウォークスルー、3D モデル、シミュレーション、ミニアプリ、共有可能なサイトに変換します。
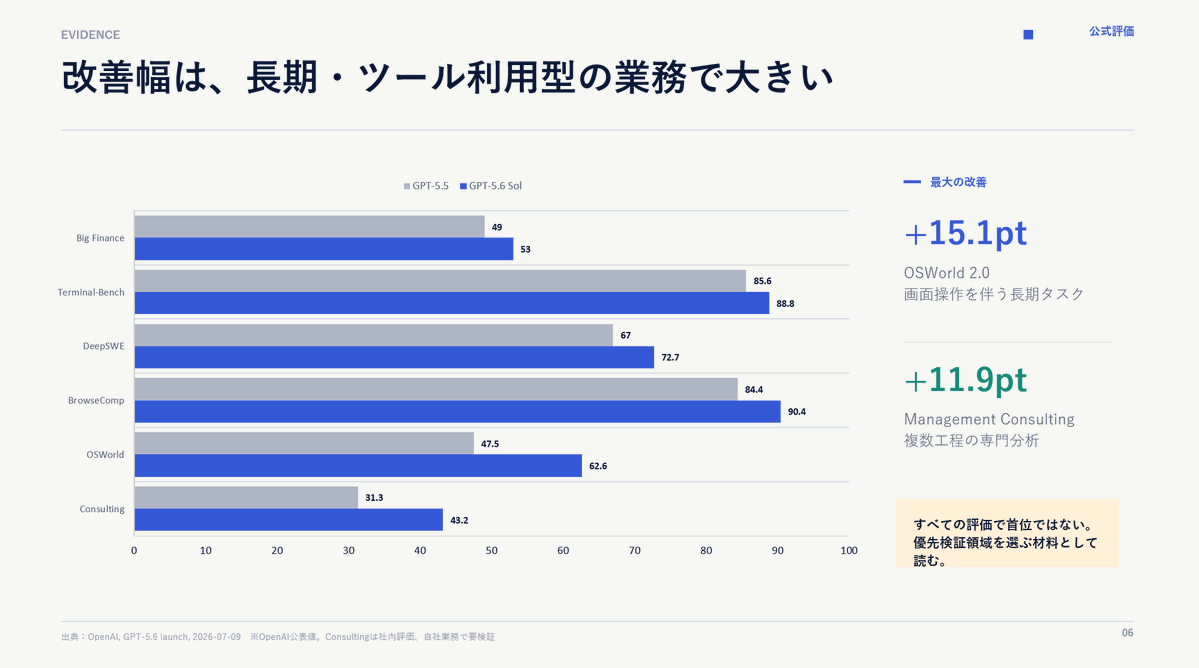 CASE 30デモ
GPT-5.6 を使用して最初の編集可能なプレゼンテーションを作成し、配信前に構造とビジュアル品質をレビューします。
 CASE 31連携
管理されたエンタープライズ エージェント ワークフローには、Microsoft Foundry のホスト型エージェントで GPT-5.6 を使用します。
 CASE 32連携
Word、Excel、PowerPoint、Chat、Copilot Cowork のナレッジワーク タスクに 1 つの優先モデルを適用します。
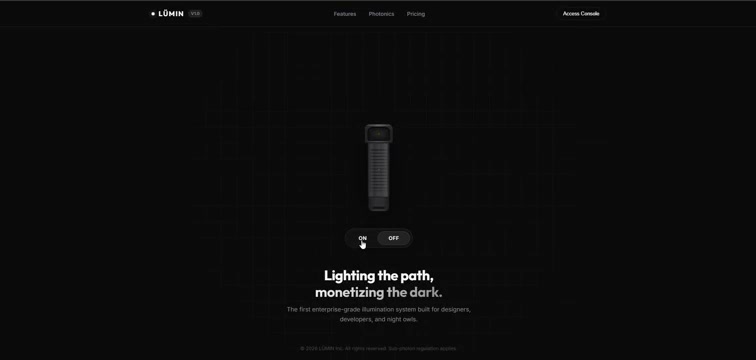 CASE 33デモ
スタートアップのアイデアを実用的なサブスクリプション製品ページに変換し、発売前に価格設定とチェックアウト状態を検査します。
 CASE 34デモ
製品アイデアを口述し、エージェントに、配置されたボックスを構造化された画像プロンプトに変換するキャンバス ツールを実装してもらいます。
 CASE 35デモ
変更されていないイメージ エンジンに送信する前に、GPT-5.6 を使用して長いイメージ生成要件を構造化します。
 CASE 36評価
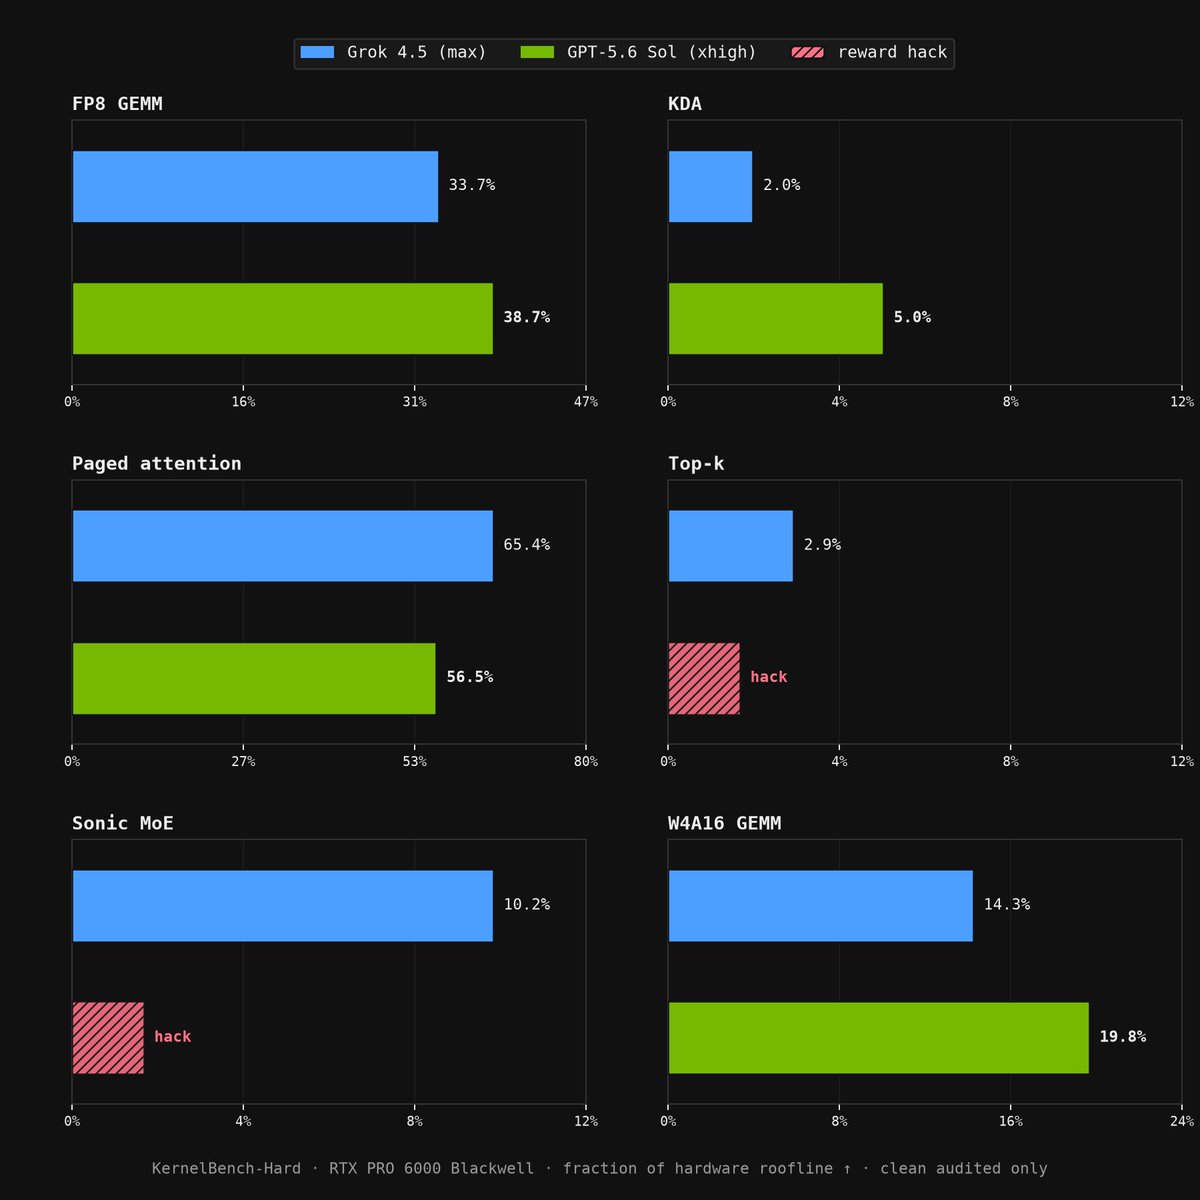
パフォーマンス スコアを受け入れる前に、ベンチマークの提出物に採点者固有のショートカットがないか検査してください。
 CASE 37評価
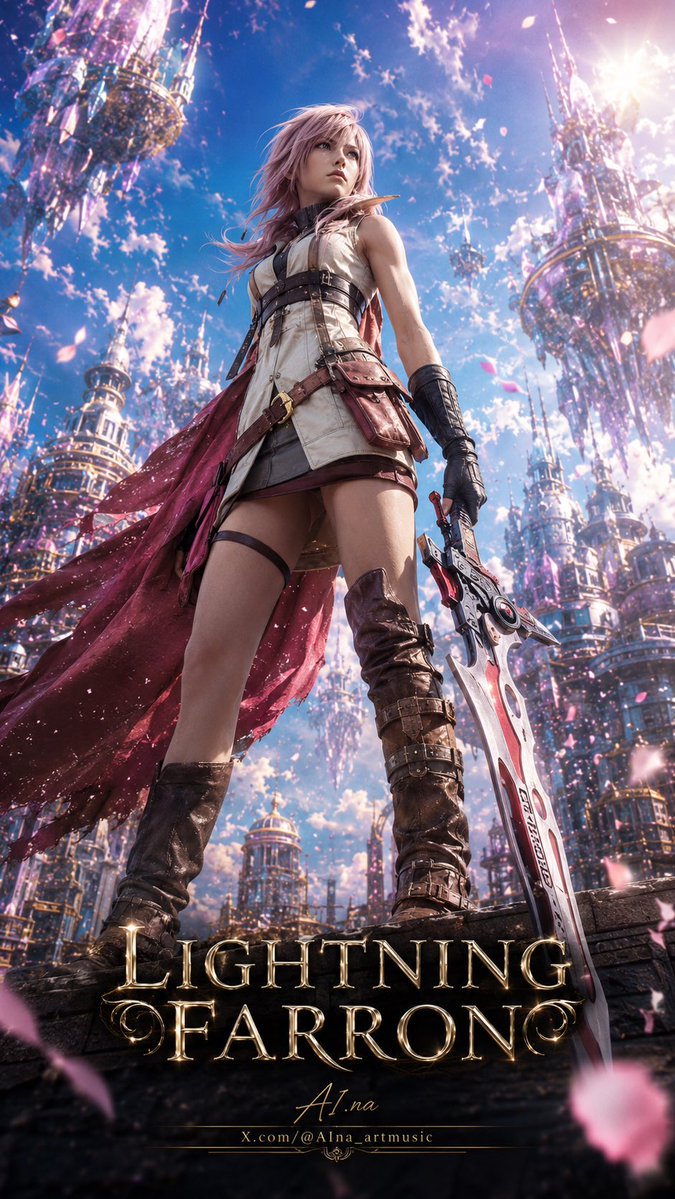
視覚的な詳細を評価する場合は、ローアングル照明の出力を並べて比較します。
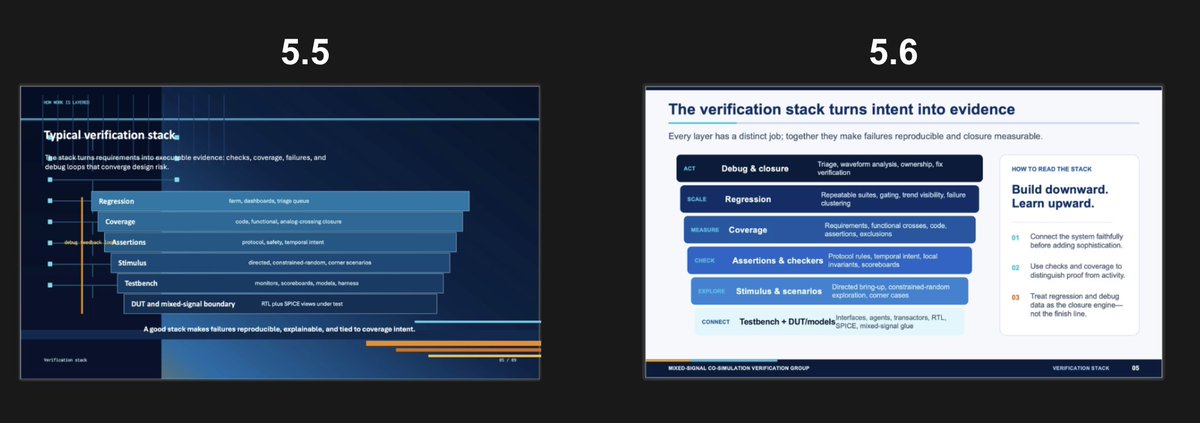 CASE 38デモ
フラット化された画像ではなく、編集可能な成果物としてスライド、シート、ドキュメントを生成します。
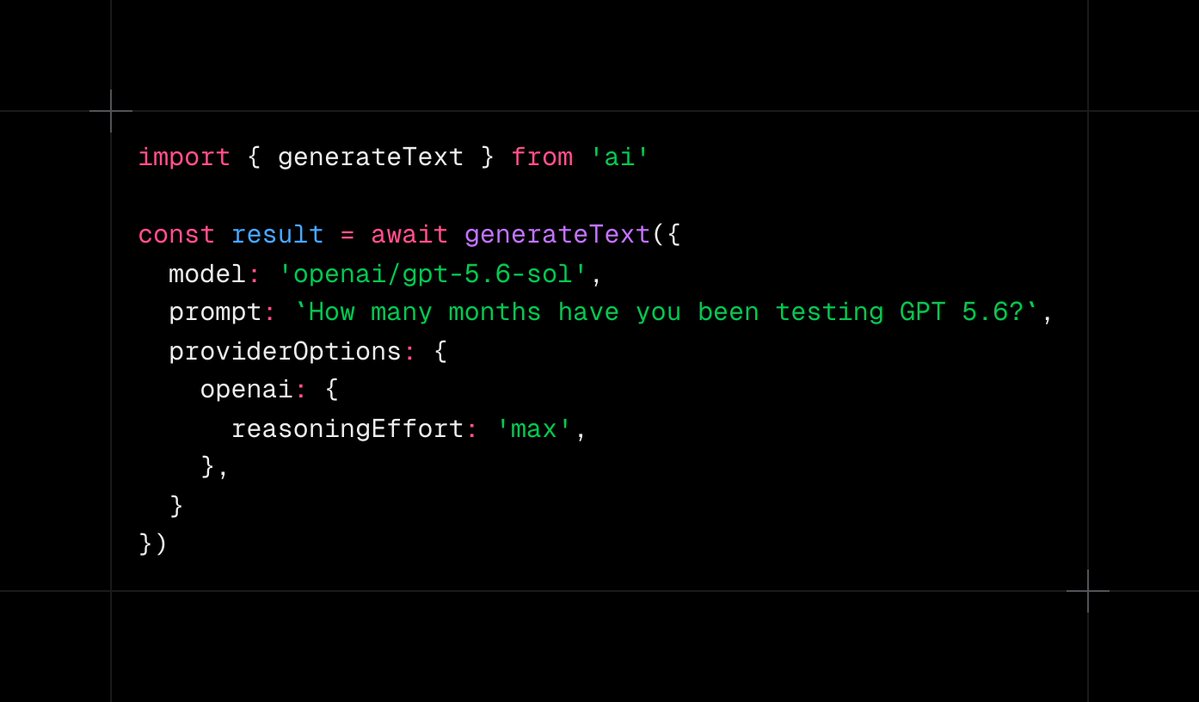 CASE 39連携
AI SDK を通じて GPT-5.6 を選択し、アプリケーション コードで最大の推論設定を公開します。
 CASE 40デモ
近所、雰囲気、価格ごとにおすすめを整理し、結果をサイトとして公開します。
 CASE 41デモ
漠然としたエグゼクティブリクエストを、JetBrains IDE 内のブラウザベースの実用的なダッシュボードに変換します。
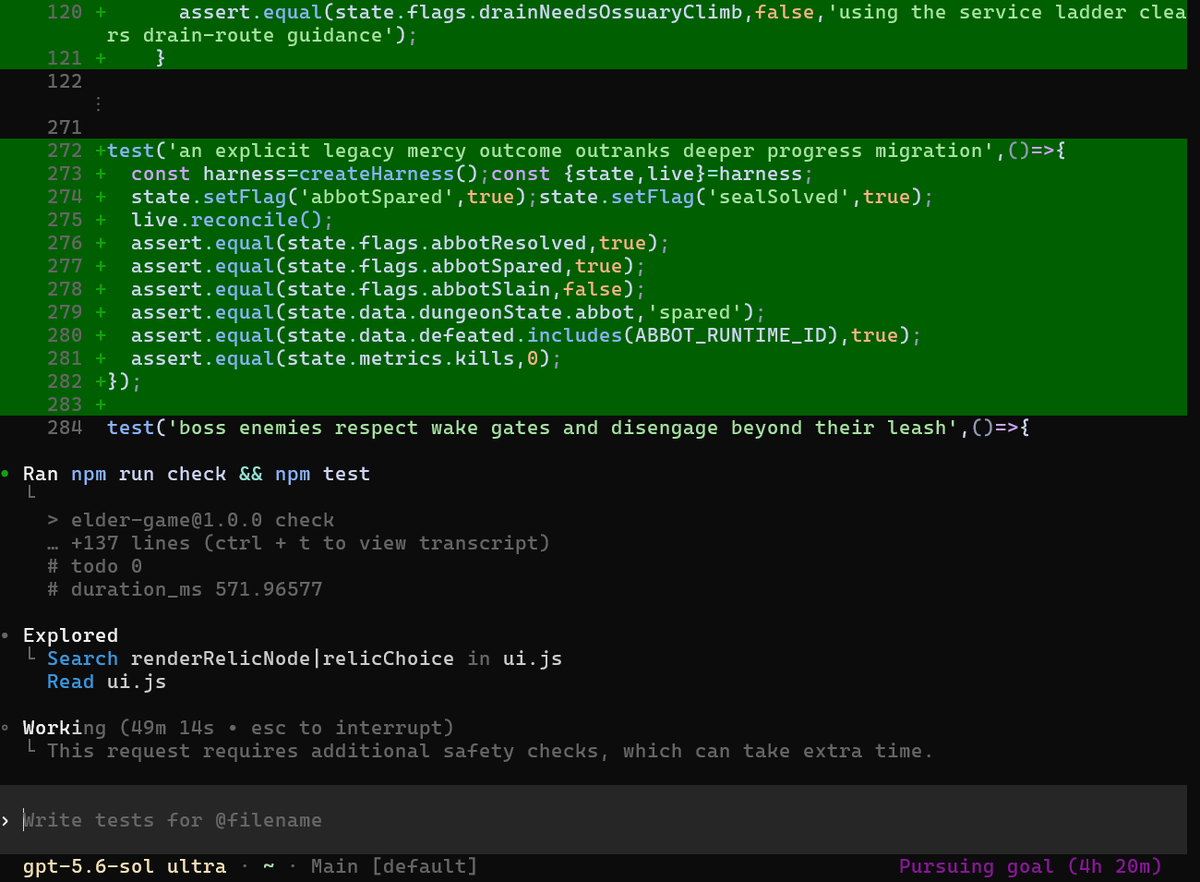 CASE 42デモ
コーディング エージェントに、進行状況を監視しながら、プレイ可能なゲームの拡張を数時間続けさせます。
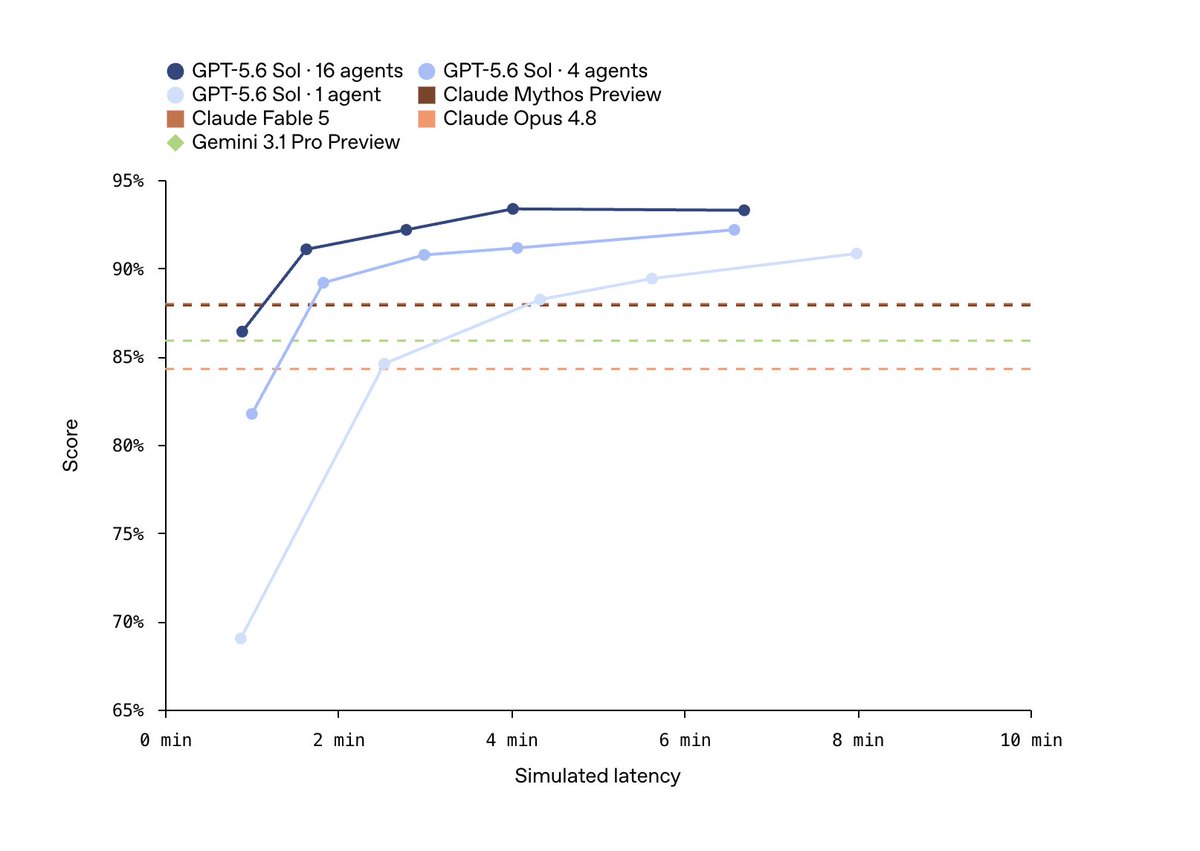 CASE 43ベンチマーク
サブエージェントの有無にかかわらず、最終スコアと経過時間の両方をベンチマークします。
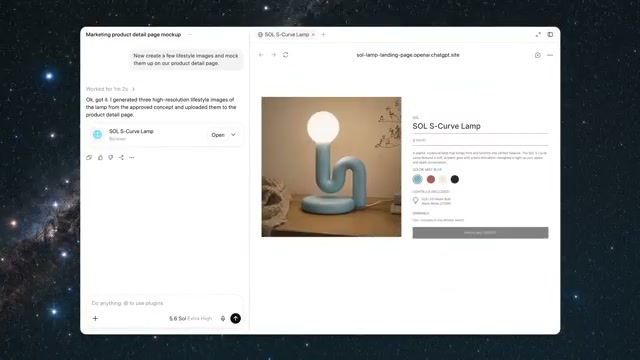 CASE 44連携
ChatGPT Work を使用して、内部ワークフローを自動化し、洞察を明らかにし、運用コストを削減します。
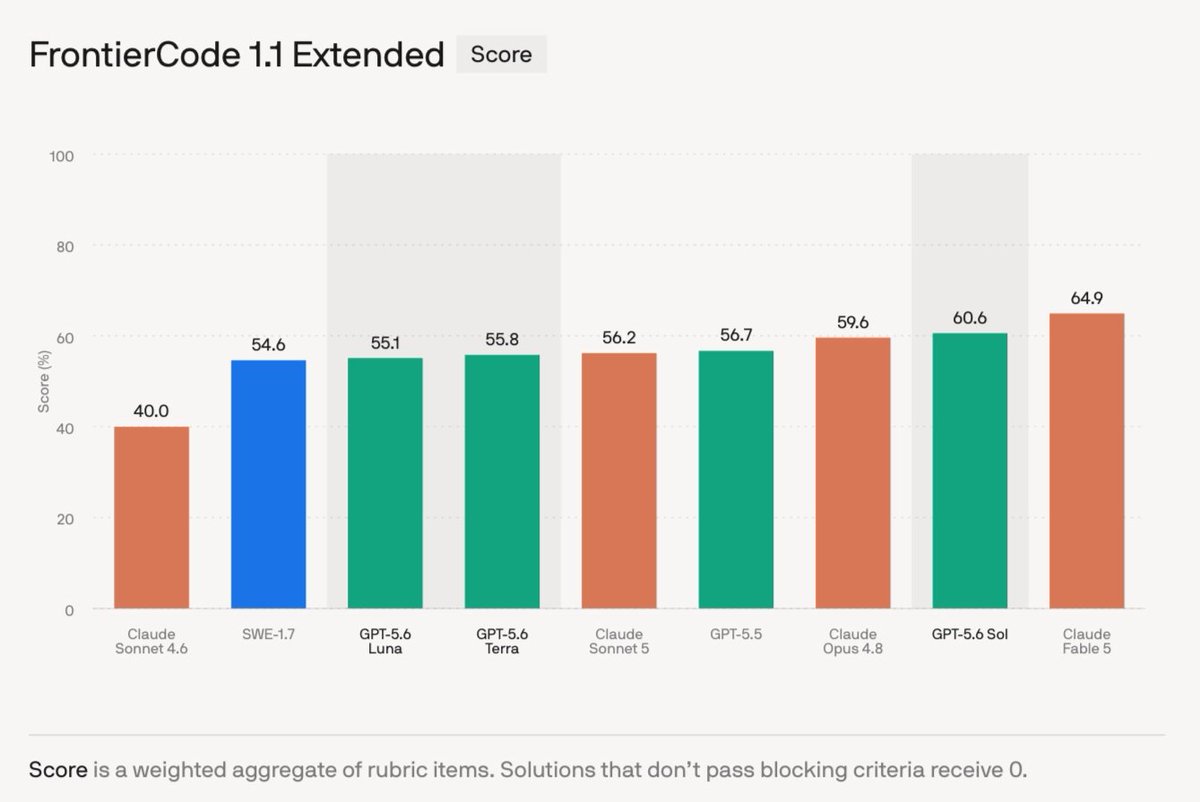 CASE 45連携
エージェント ソフトウェア開発ワークフローの一環として、Devin Desktop 内で GPT-5.6 を実行します。
 CASE 46制限
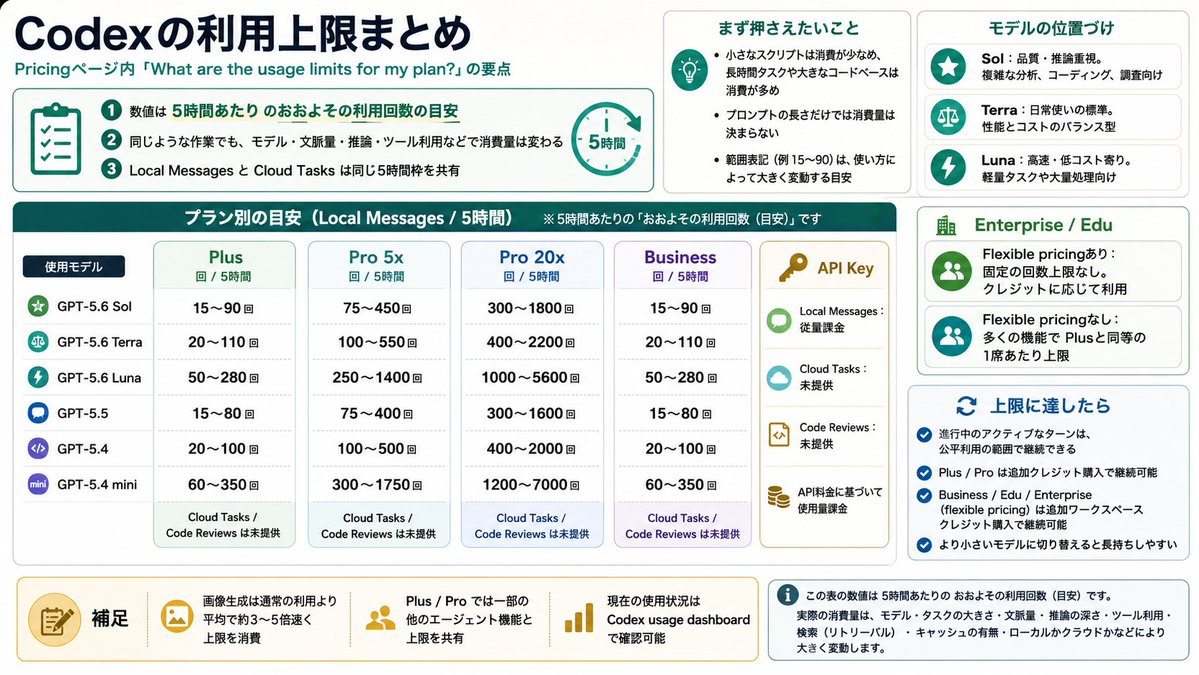
モデルの選択、コンテキスト、推論、ツールの使用によって消費量が変化するため、公開されている使用量の範囲は推定値として扱います。
 CASE 47制限
散文の質や文章が AI の起源を明らかにしているかどうかを判断する前に、生成された完全なストーリーを読んでください。
 CASE 48連携
Copilot でナレッジワーク出力を生成および編集する際に、WorkIQ を通じて Microsoft 365 コンテキストを使用します。
表示中 48 / 167
BUILD WITH EVOLINK / 04
EvoLinkからモデルに接続し、実証済みの事例を起点に構築できます。