
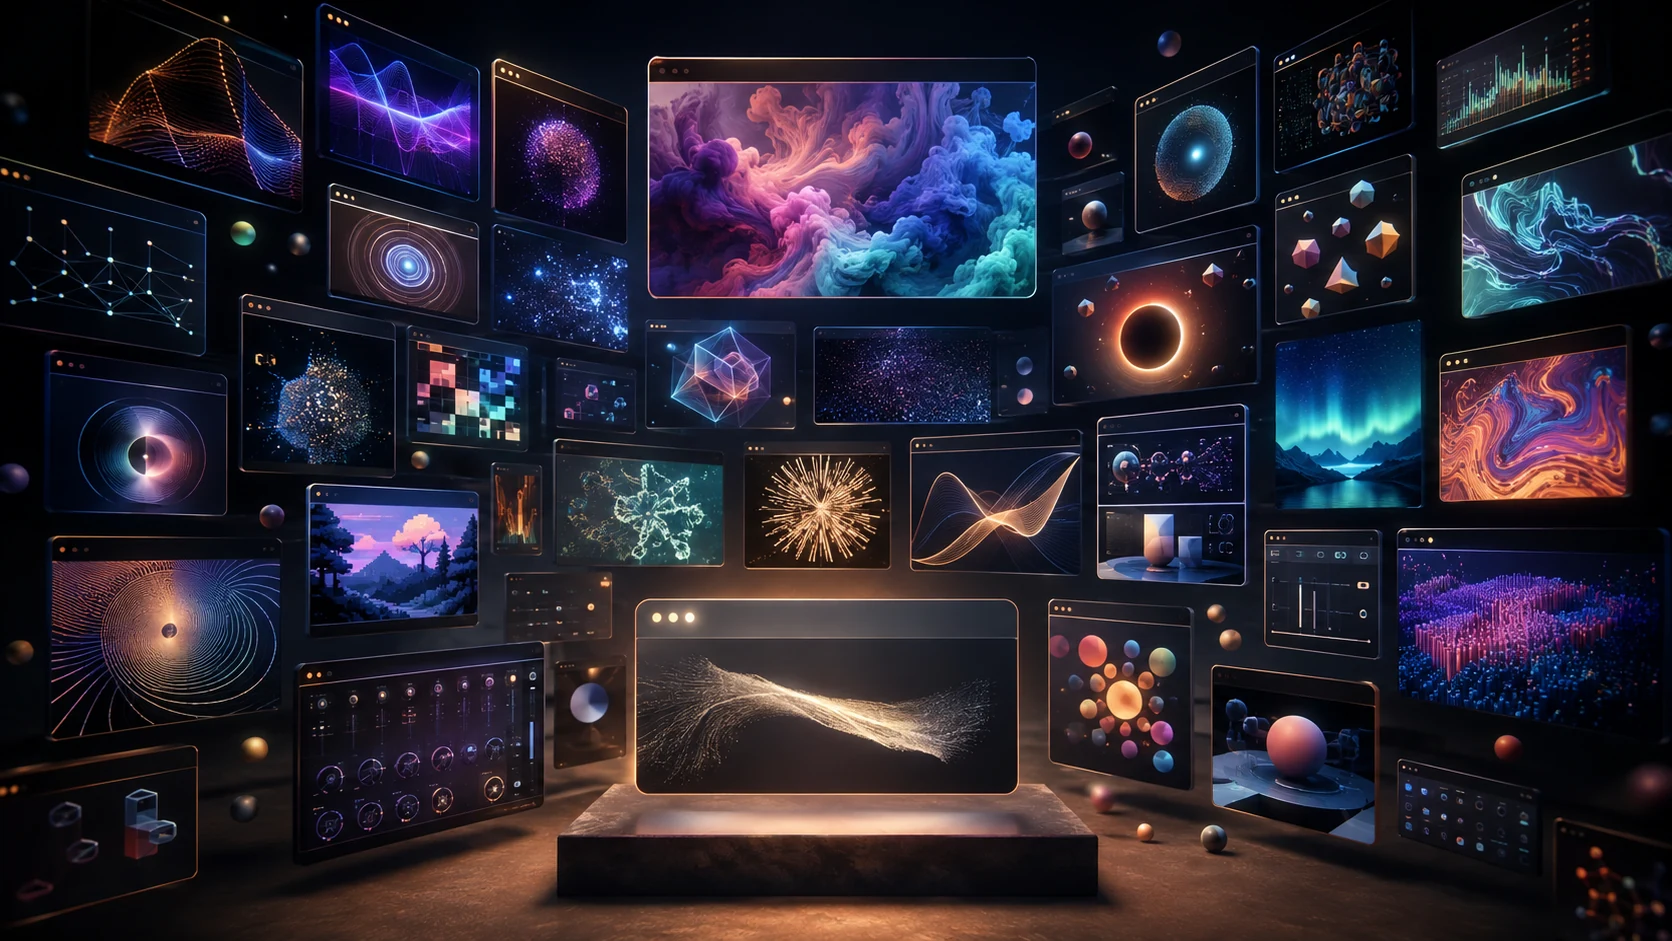
 案例 07演示
产品与前端
一条提示词生成 100 个 HTML
一条提示词生成了 100 个不同的 HTML 实验。原帖称前端质量突出且几乎没有损坏文件;本合集把整组作品视为一个实验,不把 100 个作品拆成独立验收案例。
内容最近更新 / (上海时间)
USE CASE MAP / 01
这套合集保留 116 个公开案例的核心结论、证据类型、作者和原始出处,便于快速判断哪些方法值得复用。
HOW TO USE / 02
先按任务类别缩小范围,再回到原贴核对上下文,最后用 EvoLink 复现最有价值的路径。
从编码、Agent、创意或评测等任务入口缩小范围。
按标题、方法或作者找到与你当前问题最接近的案例。
点击作者核对演示、限制、上下文和创作者的完整说明。
选择值得验证的方法,通过 EvoLink 接入模型并形成自己的流程。
REAL CREATOR CASES / 03
每行最多四个案例;点击作者可打开该案例的原始出处。图片与视频按需加载。
116 个案例
案例 07演示一条提示词生成了 100 个不同的 HTML 实验。原帖称前端质量突出且几乎没有损坏文件;本合集把整组作品视为一个实验,不把 100 个作品拆成独立验收案例。
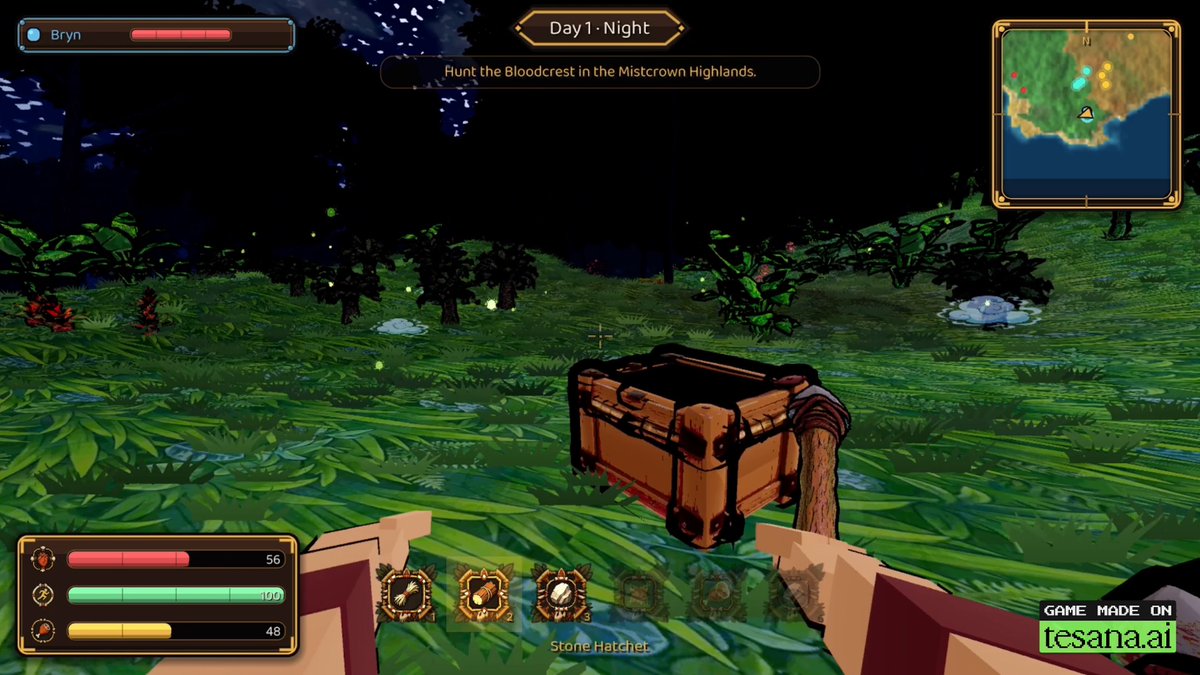 案例 12演示
创作者展示了一款由单条提示词生成的多人联机生存游戏,包含烹饪、制作、狩猎和驯服恐龙。联机稳定性以及 20 小时以上玩法的说法尚未独立验收。
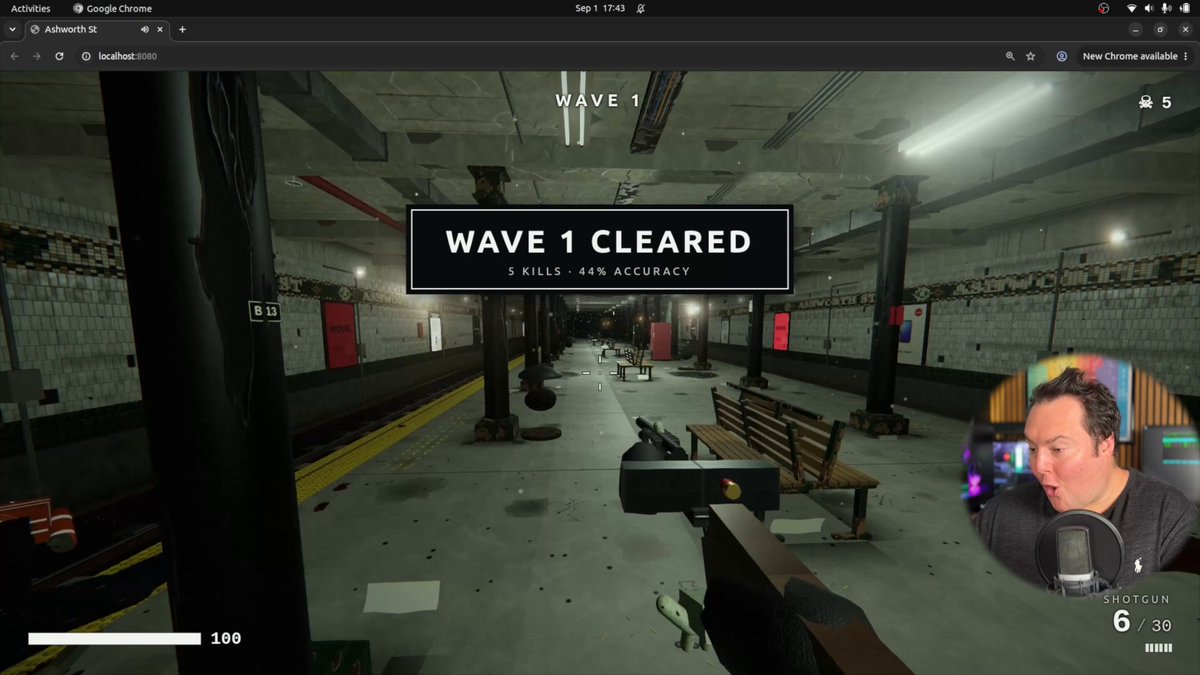 案例 33演示
同一创作者展示了 Ultracode 地铁 FPS,并在另一条帖子中称 Fable 5.1 花了两小时编写 design.md。演示能证明游戏产出可见,但不能证明规划过程高效。
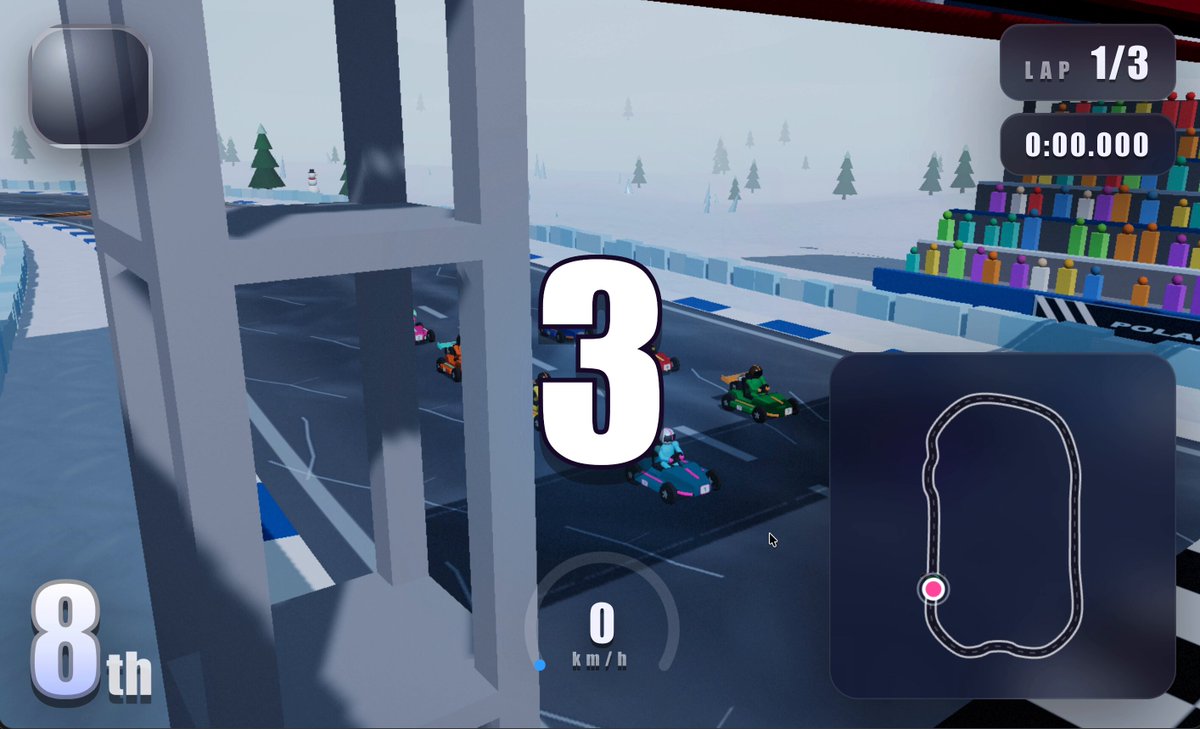 案例 48演示
BridgeMind 展示了一款据称一次生成的卡丁车游戏。视频呈现了可游玩的结果,但未披露完整提示词和验收标准。
 案例 66演示
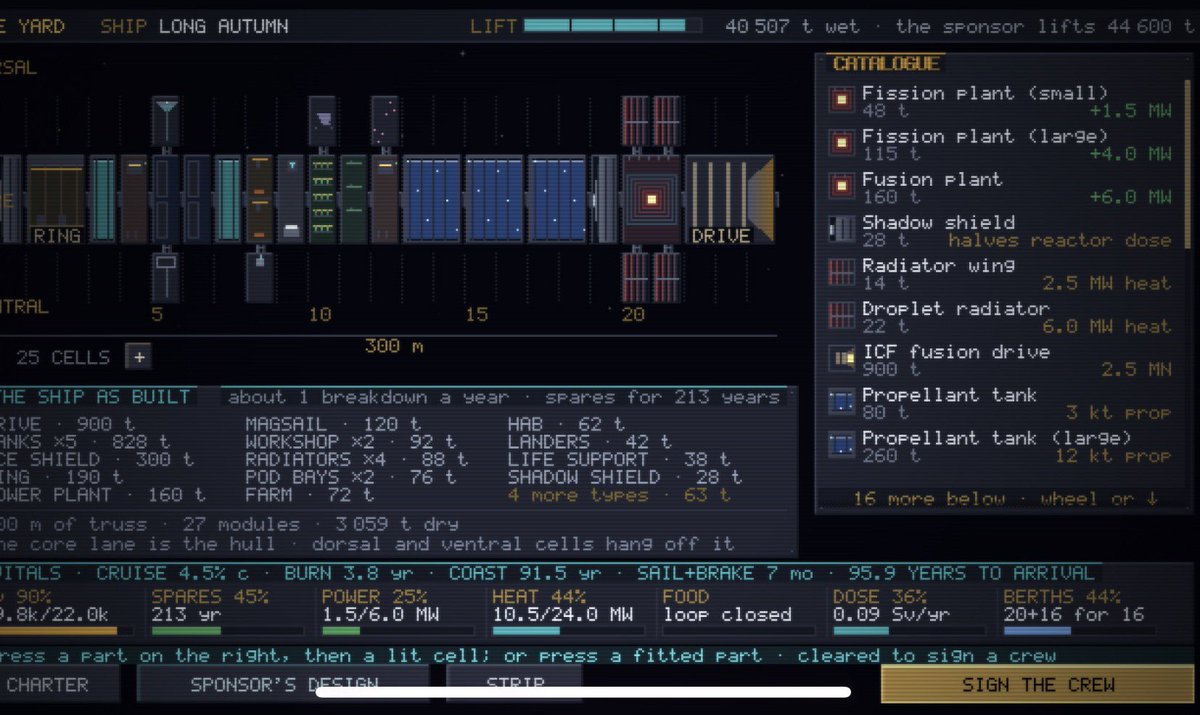
一位提前体验用户分享了受 FTL 启发的复古太空船游戏,用它说明需要判断力与审美的长时间任务能力。这是已披露的 early access 演示,不是独立盲测。
 案例 15演示
团队称 Fable 5.1 从一张地块照片出发,设计并渲染房屋,再通过代码生成电影式漫游。具体工具和尺寸准确性未披露。
 案例 53演示
创作者称这段 motion video 用时 19 分钟,并做了两次修改。由于存在修改,不应把它描述成零修改的 one-shot 结果。
 案例 56评测
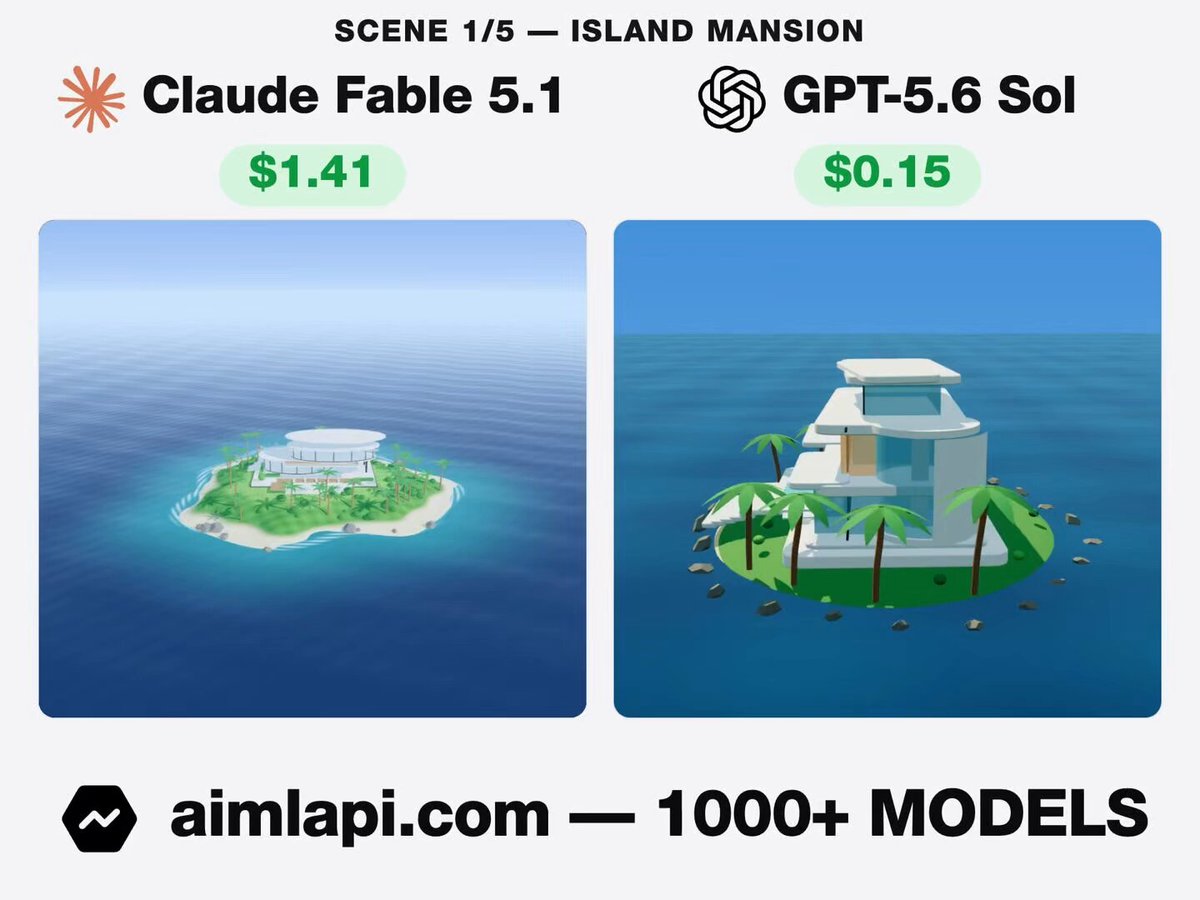
AI/ML API 用五个连续 Three.js 场景对比 Fable 5.1 的 $5.69 与 GPT-5.6 Sol 的 $0.88。Fable 细节更丰富,但也生成了没有水的泳池;发布方本身销售 API 服务。
 案例 62评测
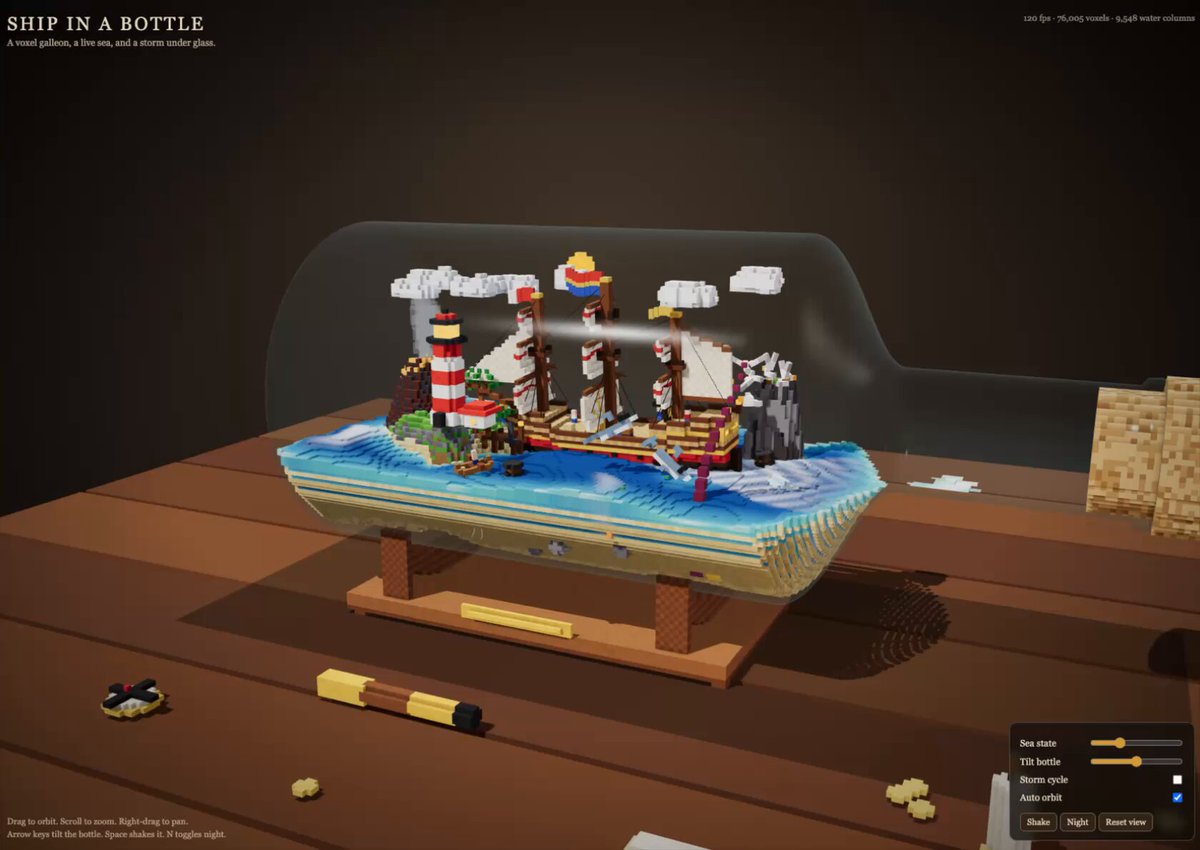
Fable 5.1 主帖称使用同一提示词生成了差异明显的瓶中船可视化。旧模型原帖确认了对象,但旧模型的运行配置不能转嫁给 Fable 5.1。
 案例 19案例
作者称 Fable 5.1 在七小时内重做旧论文、修正近似、推导另一种可解模型并扩展未来工作。结果尚未独立复核;同帖中的 GPU kernel 成果属于 Mythos,不计入 Fable 5.1。
 案例 79案例
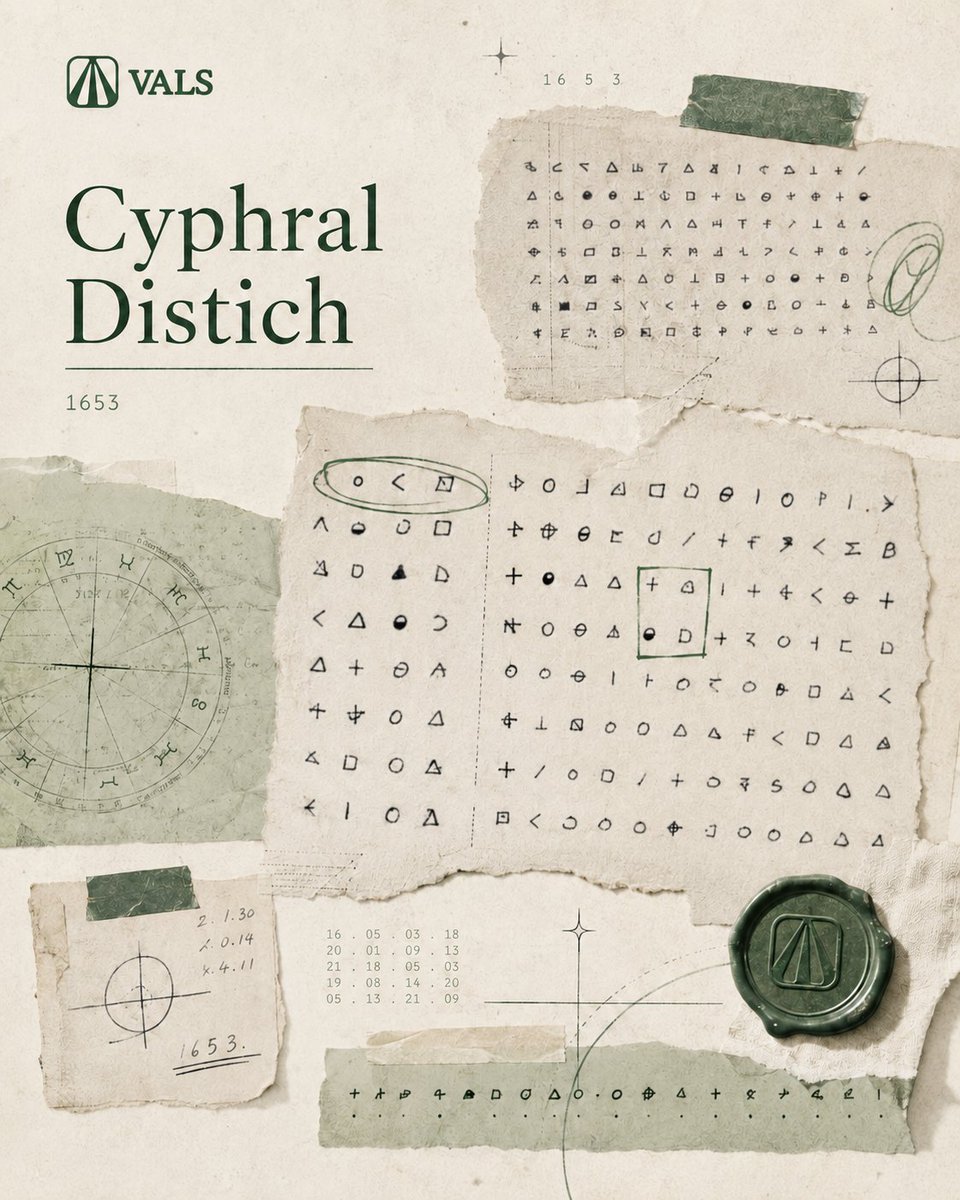
Vals AI 称通过 Fable 5.1 得到了对 373 年历史的 Cyphral Distich 密码的候选解码。这是第一人称测试自述,正确性尚未独立验证,不能写成公认破解。
 案例 24案例
创作者建议对已有 Skill 批量运行 prompt-audit,并称它能发现冗余规则。原帖描述的是正在执行的批处理,并未披露完成后的修改清单。
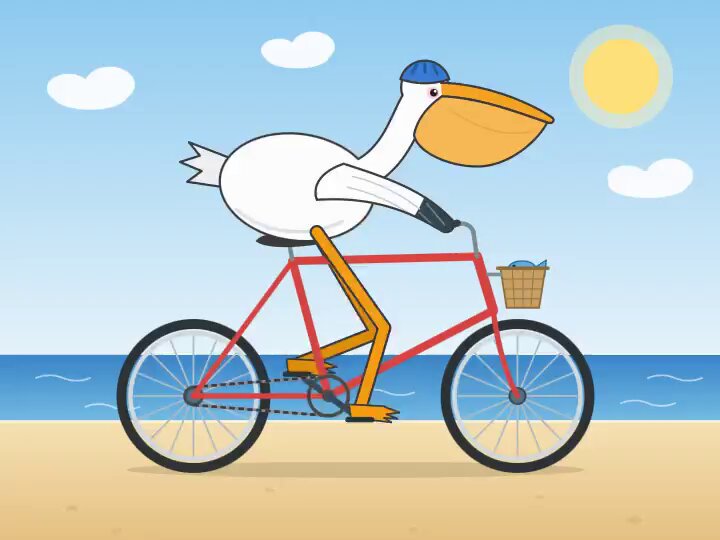 案例 80演示
Max 档产出鹈鹕 SVG,再单独动画化;费用和分步过程有披露,不是一步 one-shot
 案例 81评测
作者报告删除 3.3 万行代码,但未在本清单中独立验收删除的正确性
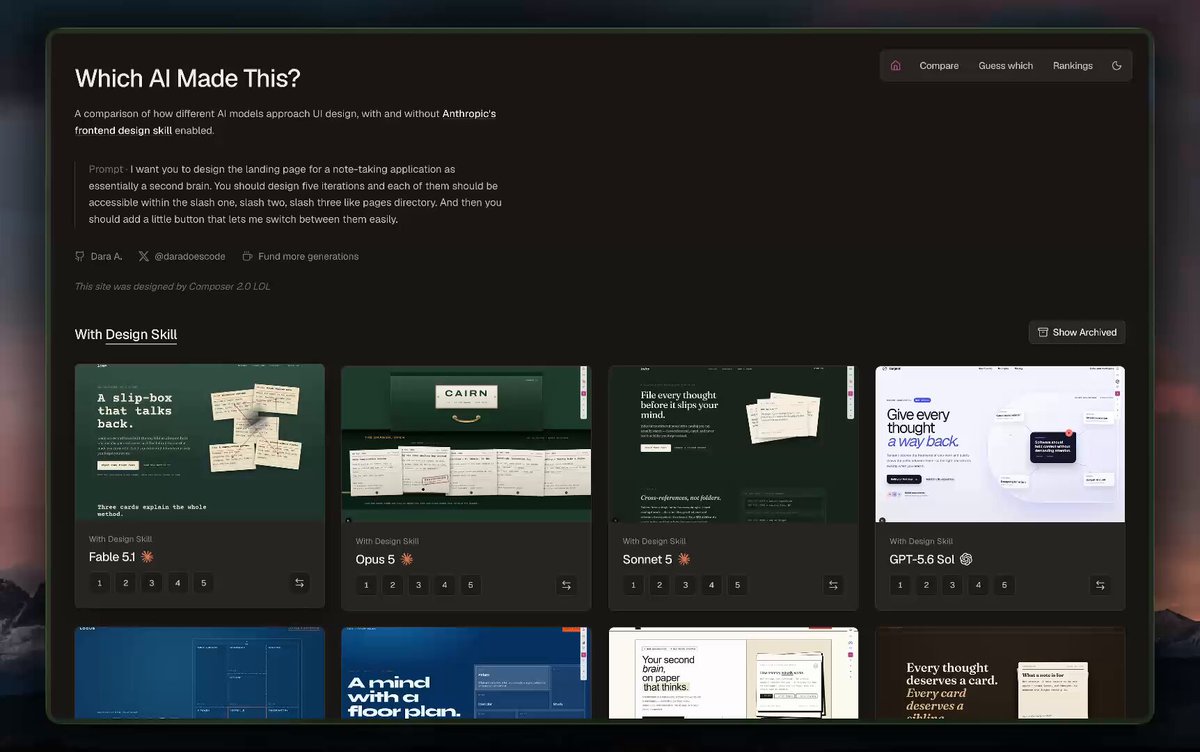 案例 82演示
作者展示可访问的前端动画产物,未披露完整 prompt、修改轮次和验收清单
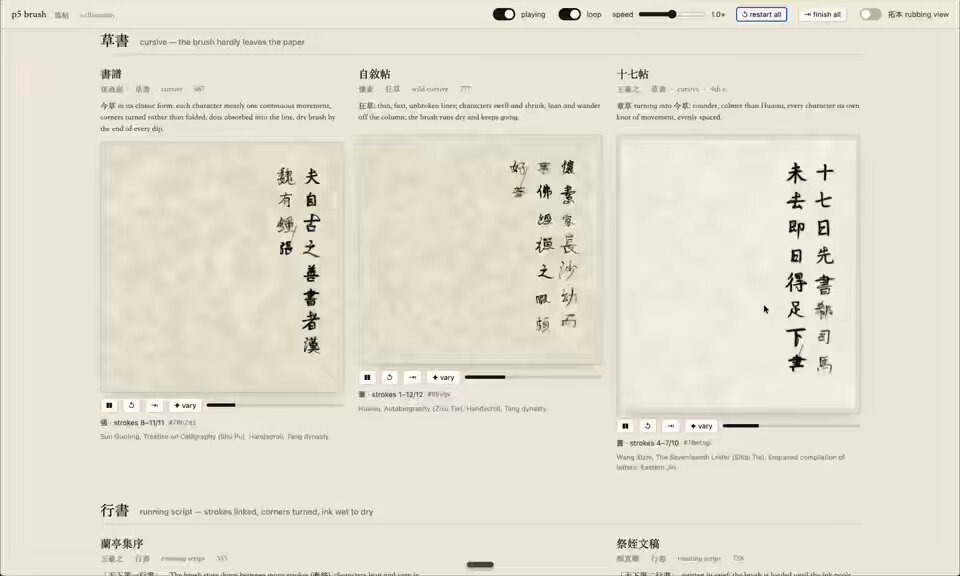 案例 83演示
有书法产物展示,字形和书法质量未经专业评审
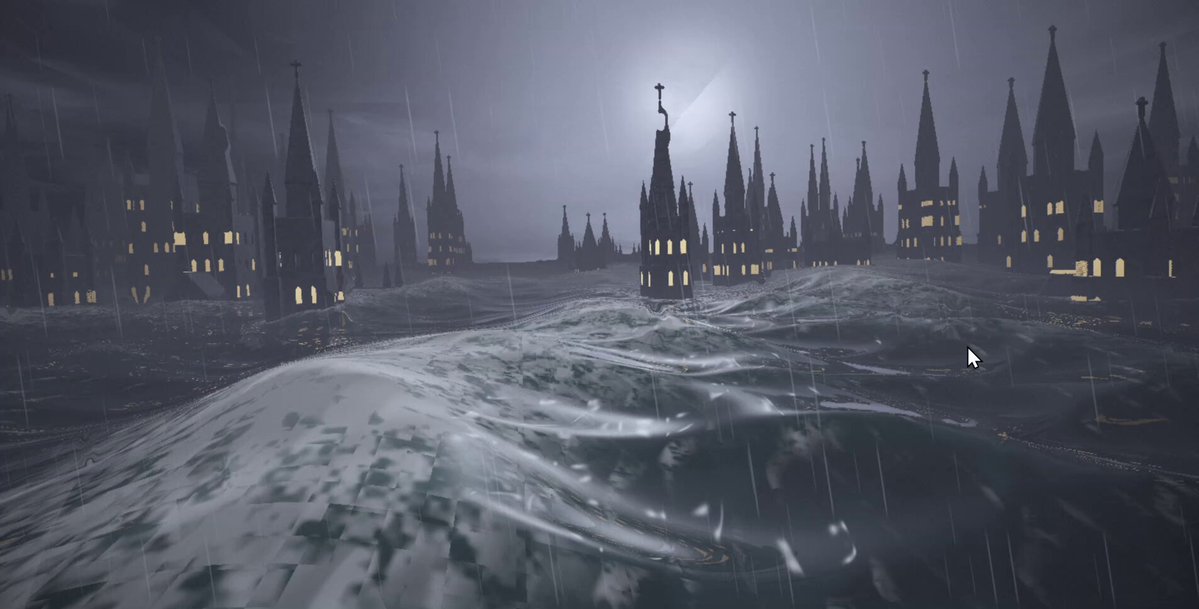 案例 84评测
使用与旧模型相同的 prompt 生成 twigl shader,属作者对比演示
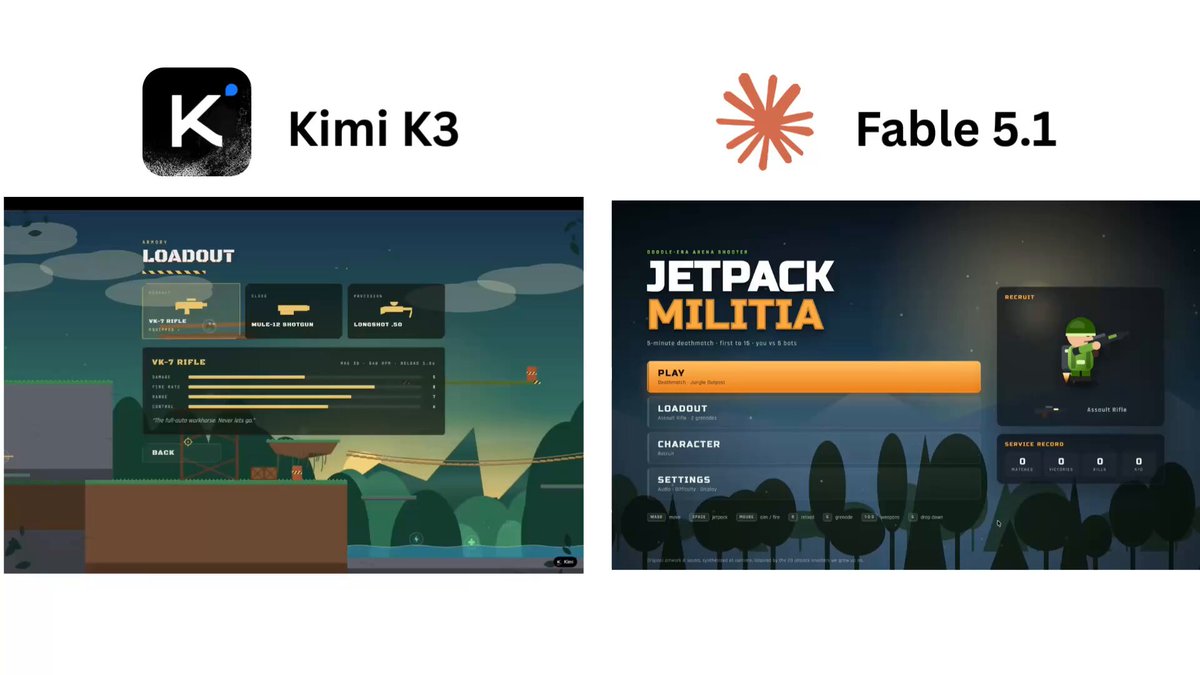 案例 85评测
同一游戏任务下展示 UI、玩法、成本和稳定性差异;仍是作者自评
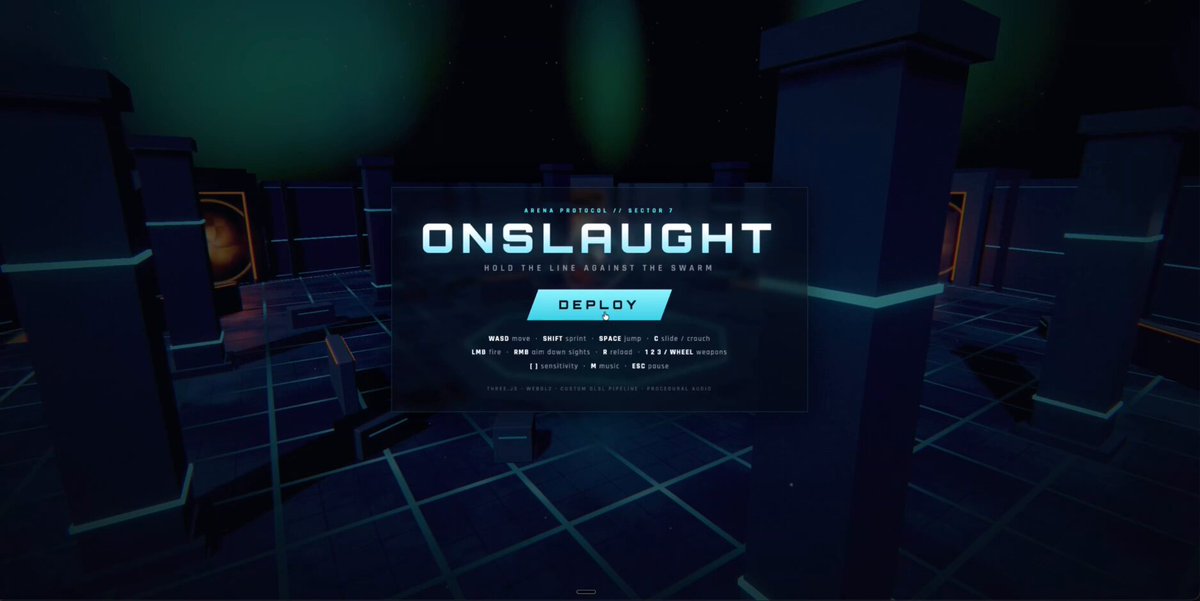 案例 86演示
原帖给出射击手感、后坐力、ADS 和三类枪械等 prompt;试玩链接在回复中,未完整验收
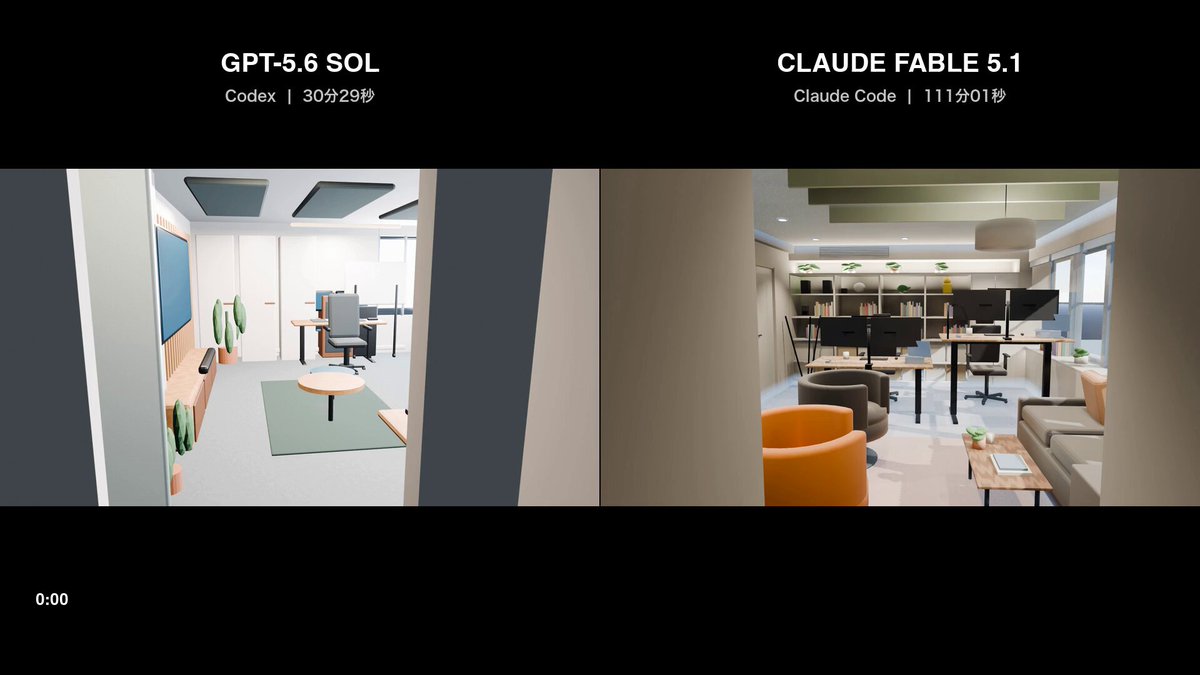 案例 87评测
同 prompt 对比中,5.1 用时 111 分钟并产出 14 张图和 44 秒视频;更多产物不等于更高准确度
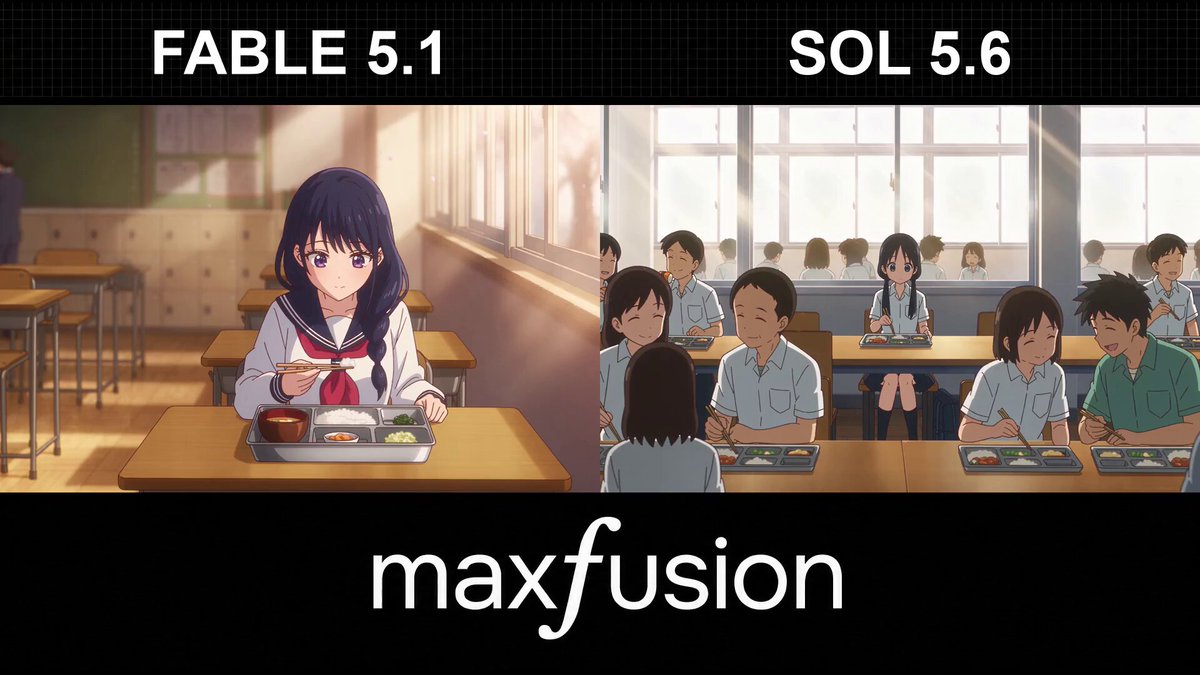 案例 88评测
与 GPT-5.6 Sol 执行同类动漫场景任务,原帖展示对比结果,缺少统一评分标准
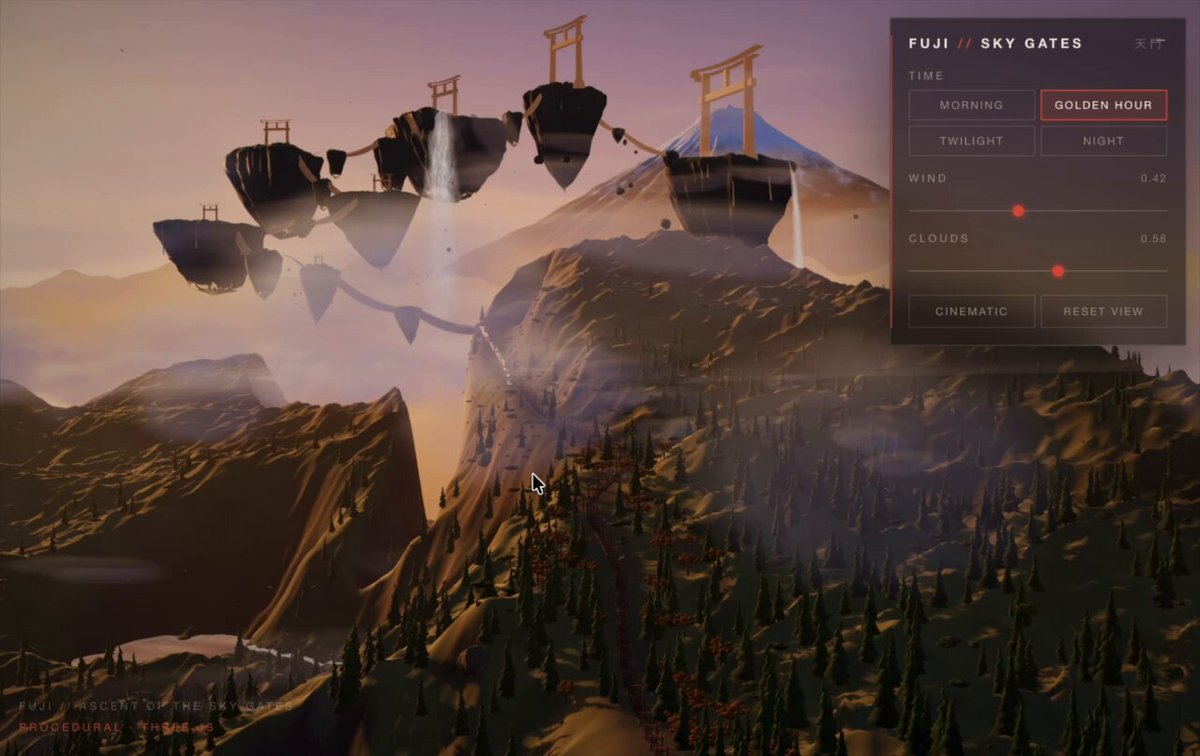 案例 89演示
作者称全部由代码 one-shot 生成,有可视产物,未披露完整运行与修改记录
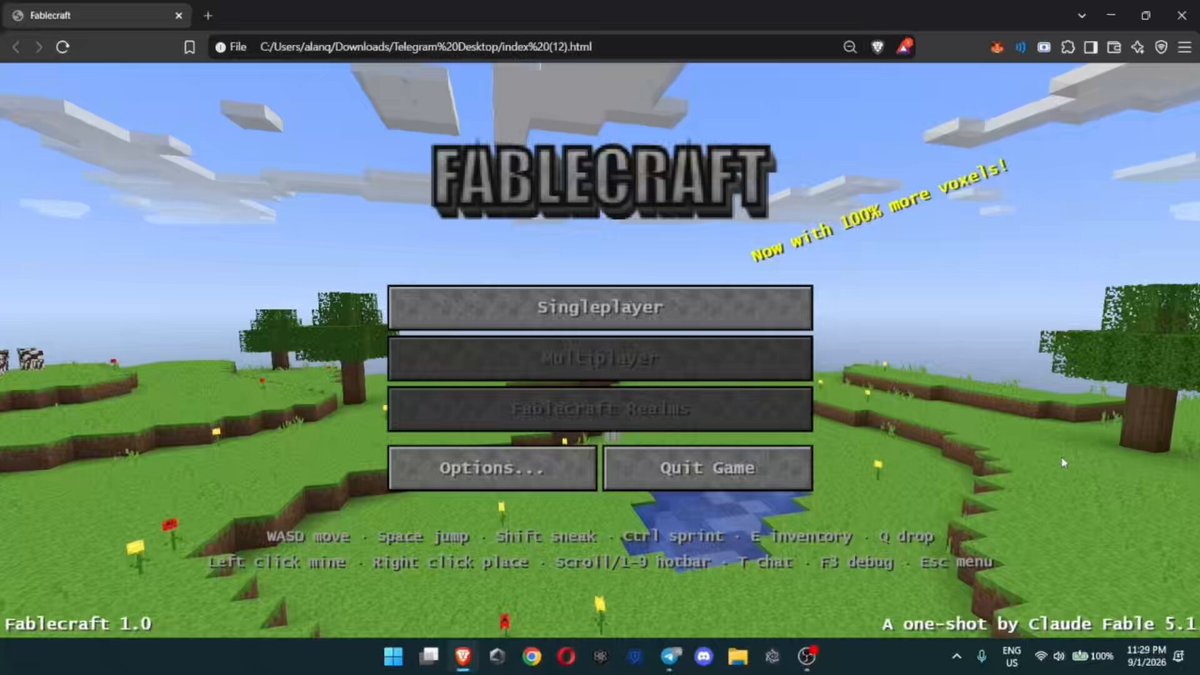 案例 90评测
一条 prompt 生成地形、背包、洞穴和 TNT 爆炸;作者实测了爆炸坑,未检查长时运行
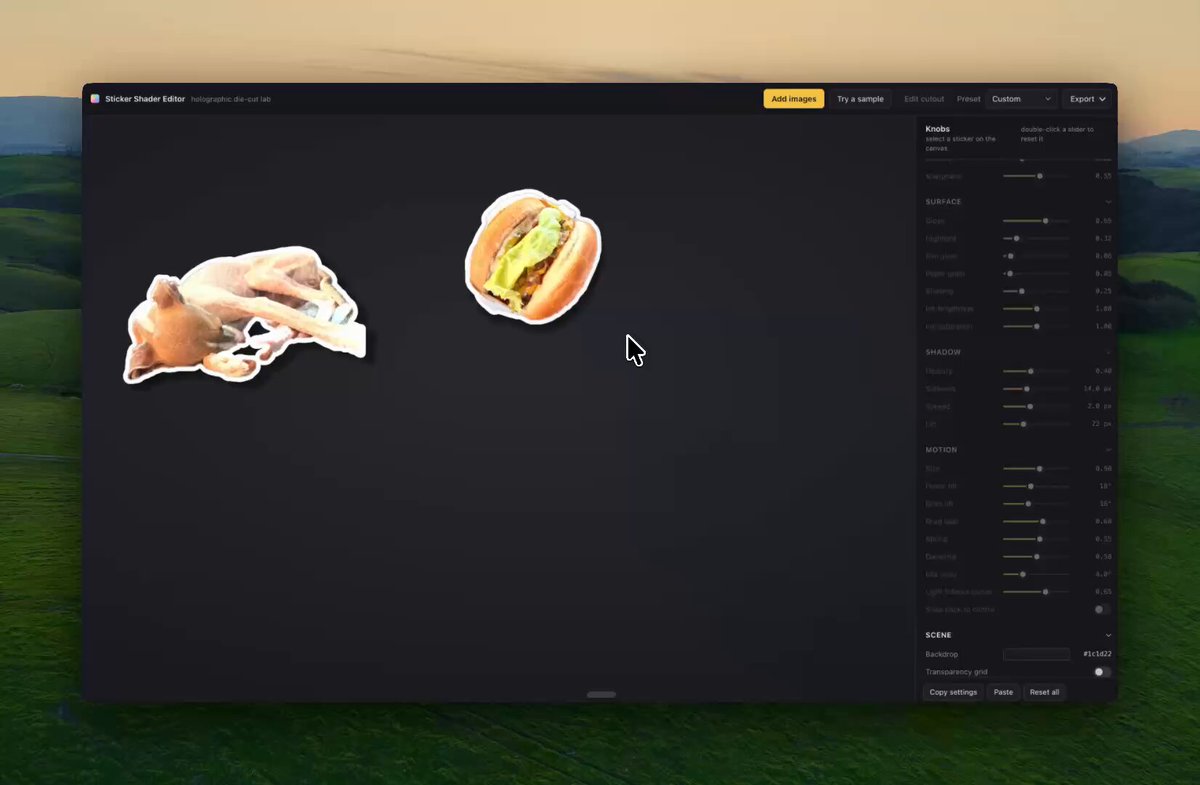 案例 91演示
作者称一次生成将小狗照片制作成数字贴纸的工具,未披露完整代码与成本
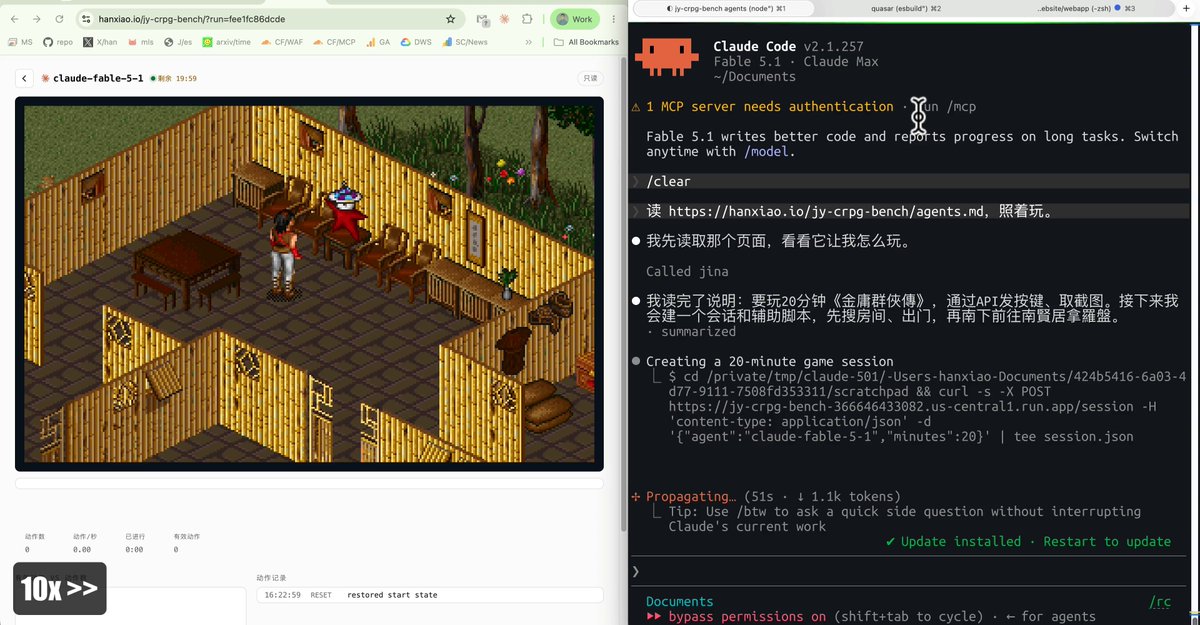 案例 92评测
20 分钟沙盒中 5.1 用 4 分钟走出出生地,比 Fable 5 慢 1 分钟;所有模型均未找到南贤居
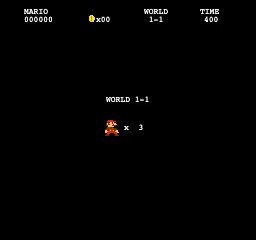 案例 93演示
转述朋友的单轮运行,展示音乐、音效、火球、蘑菇和角色机制;非操作者本人直接发布
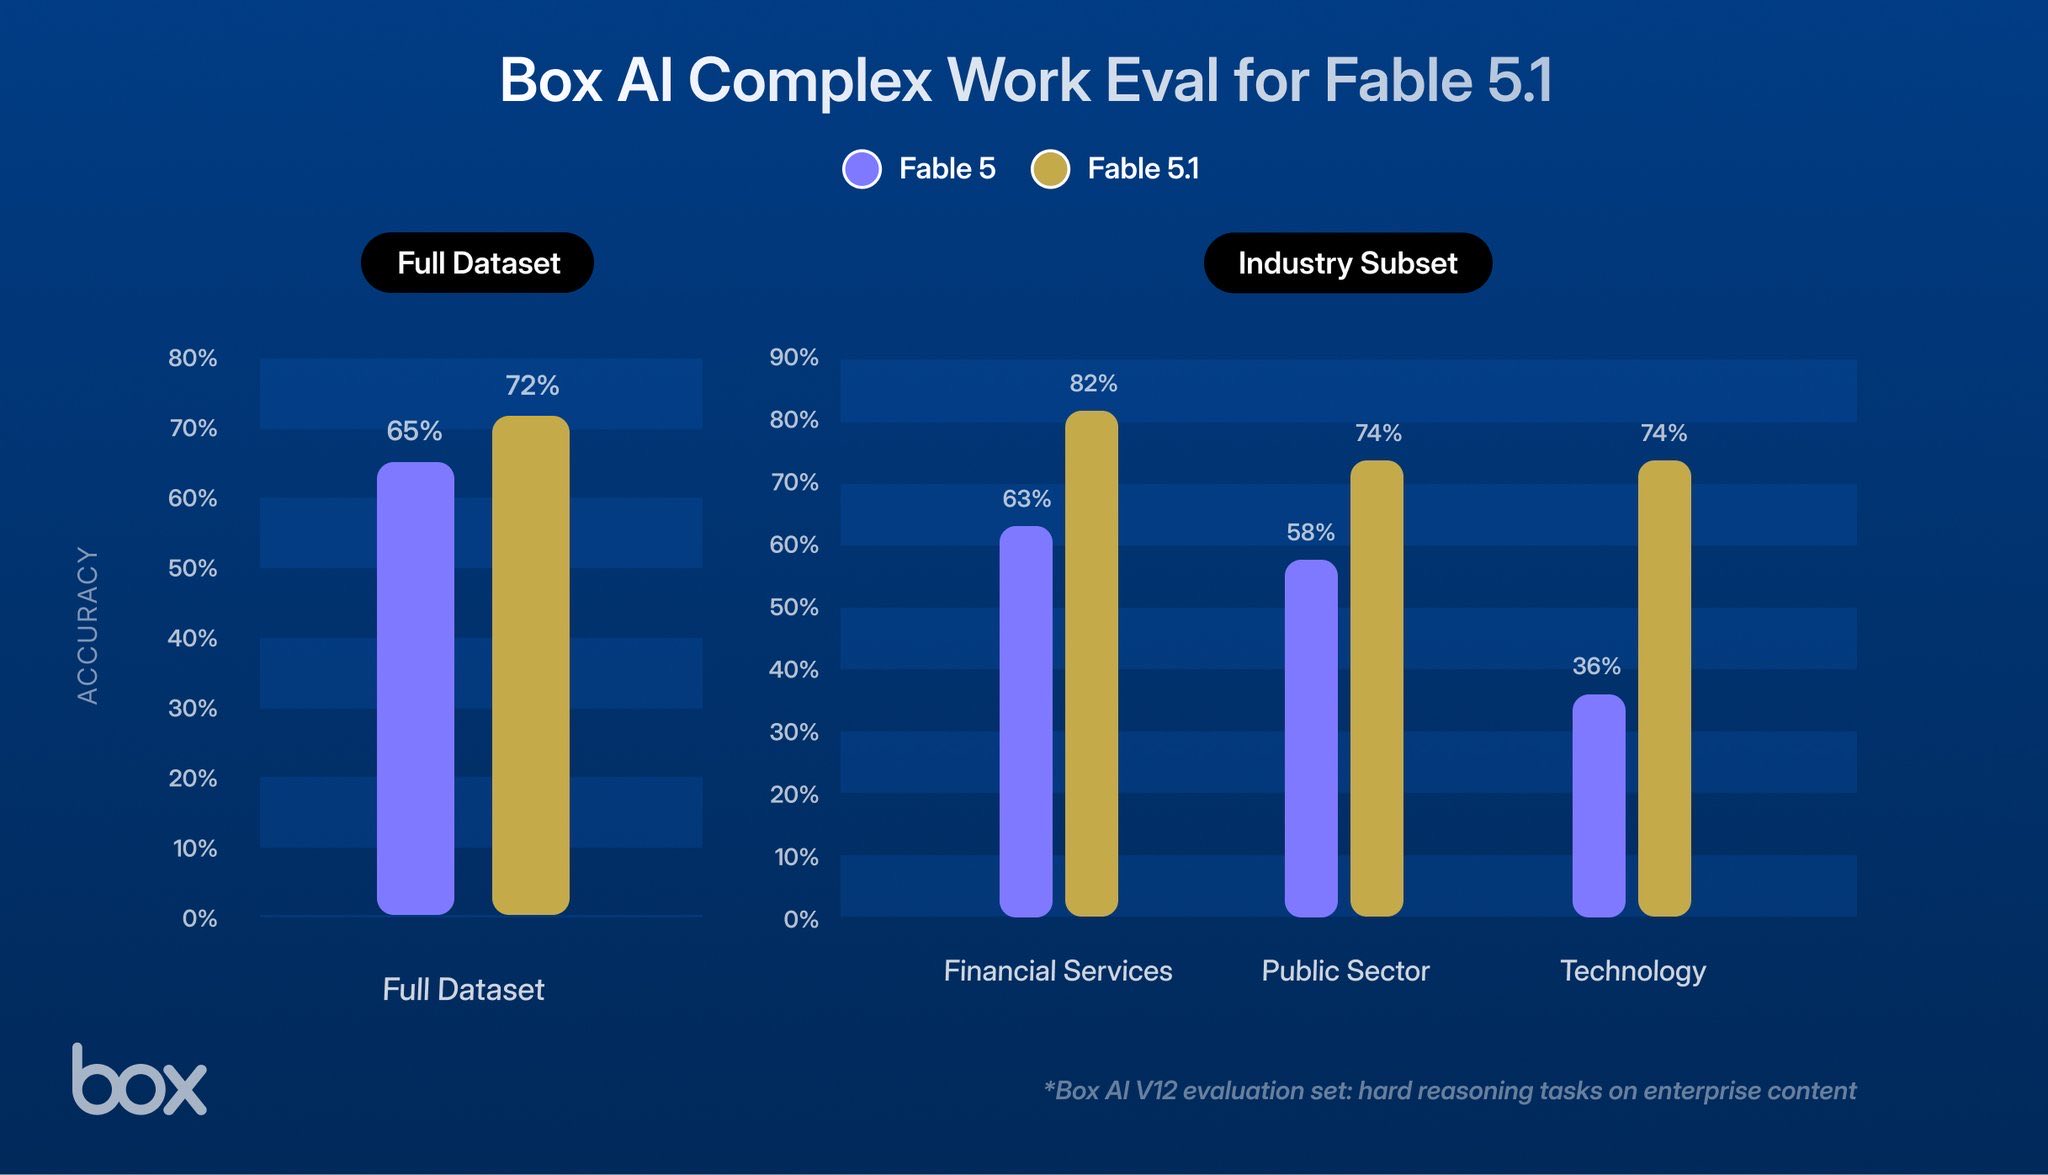 案例 94评测
前置测试披露金融、技术和公共部门的具体分析任务;属 Box 早期测试,不是独立客户证言
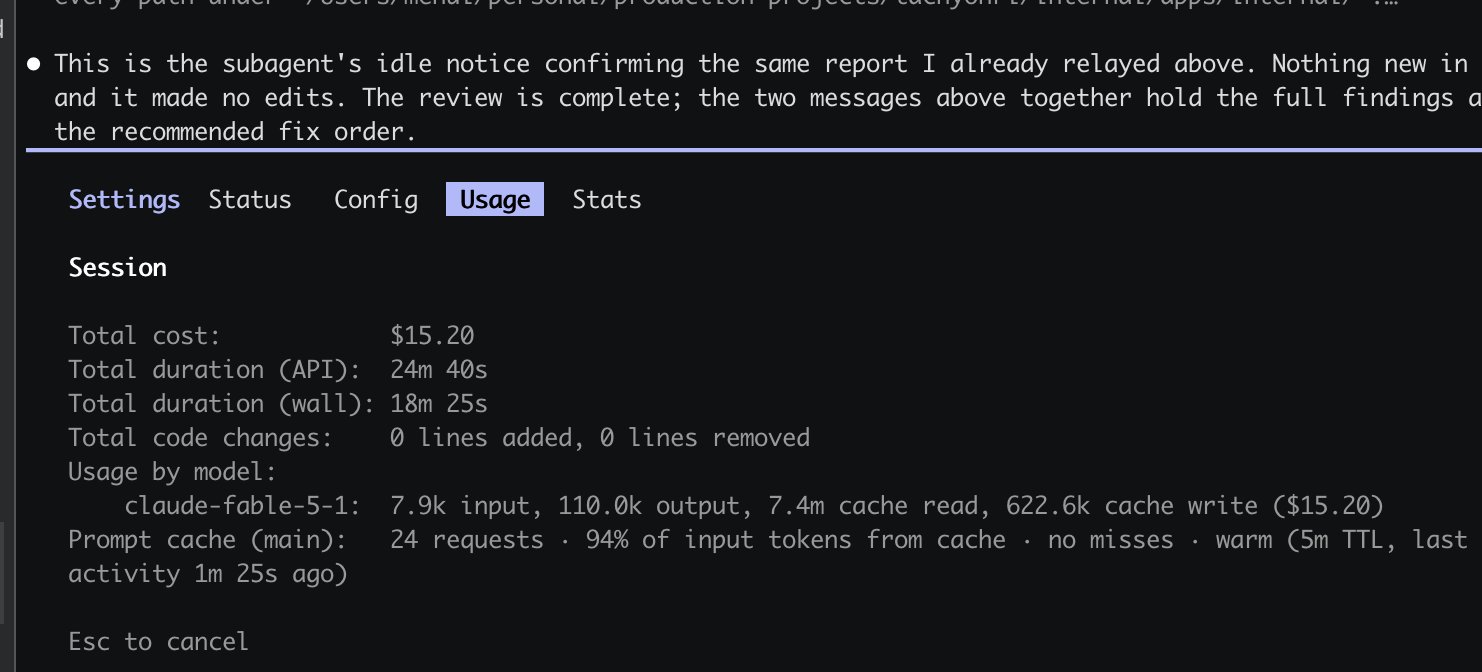 案例 95评测
作者报告 Fable 5 花费 $20.76、5.1 花费 $15.20;未披露统一审查范围和发现质量
 案例 96演示
原帖称一条 prompt 生成 240 万体素、1500 名士兵和 160 个 NPC;规模与玩法未独立验收
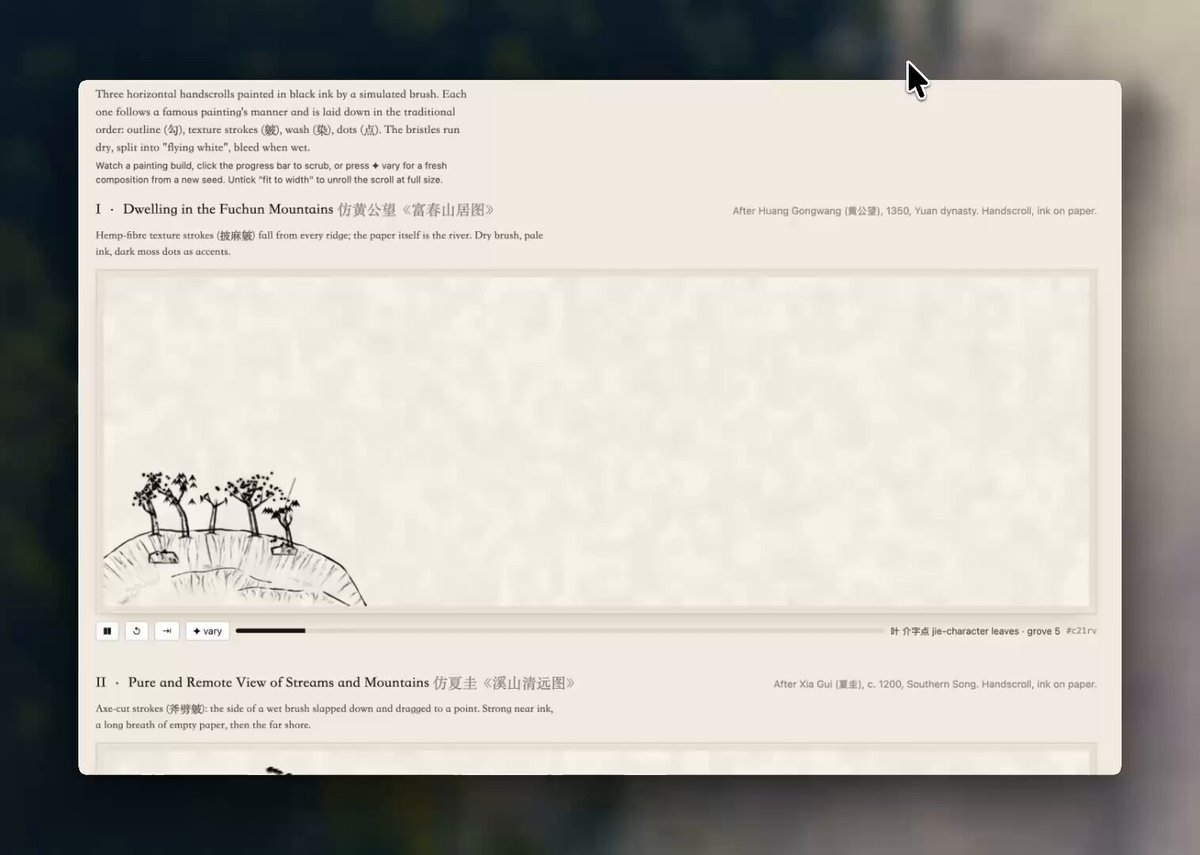 案例 97演示
有可视产物,未披露 prompt、生成轮次和审美验收标准
 案例 98教程
原帖给出 2–4 人、LAN Web 服务和 RCE 对抗规则;属安全游戏设计,未披露完整运行结果
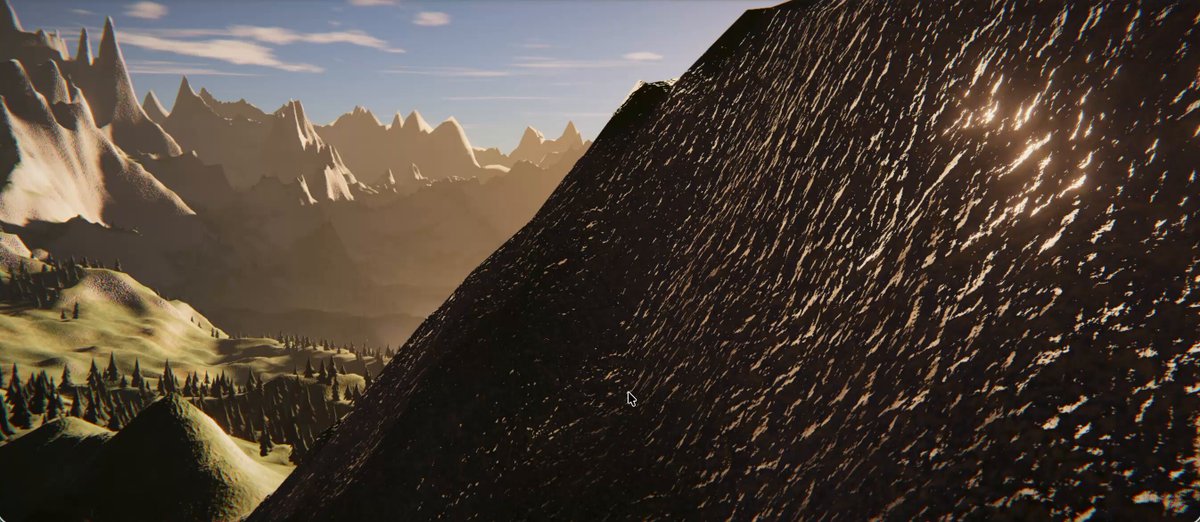 案例 99演示
作者称用时 26 分钟生成照片级地景,有结果展示,未披露完整 prompt 和费用
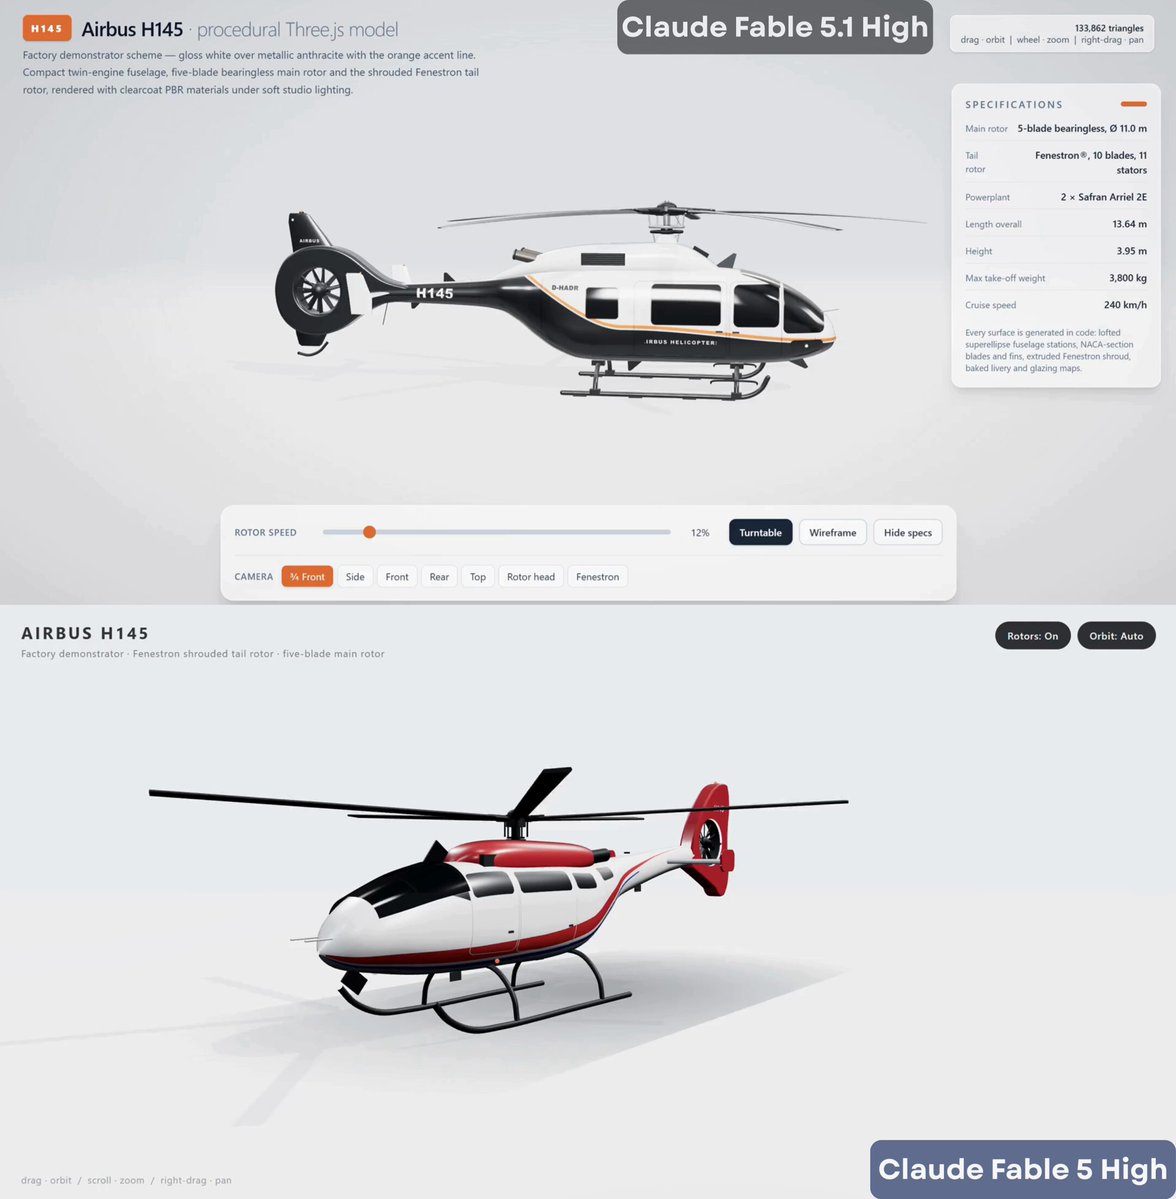 案例 100评测
用简单 prompt 对比 5.1 High 与 Fable 5 High 的 Three.js 直升机模型,缺少客观评分
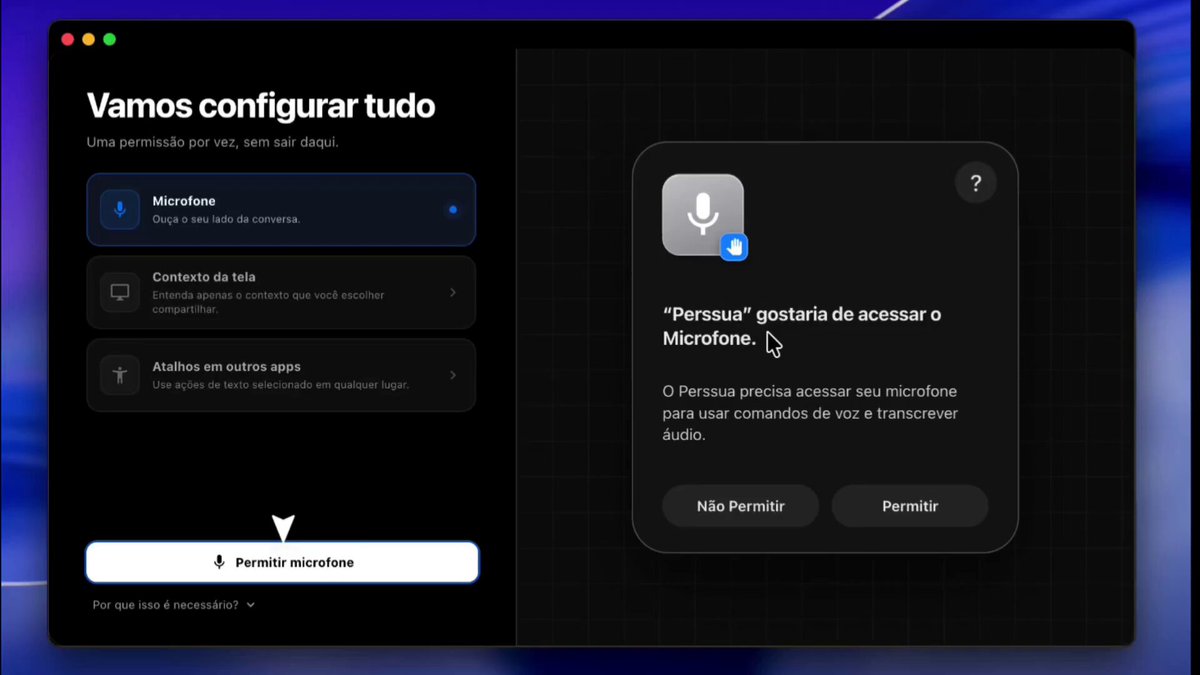 案例 101演示
作者称 one-shot 生成新 App 的 onboarding,有产物展示,未披露交互和发布验收
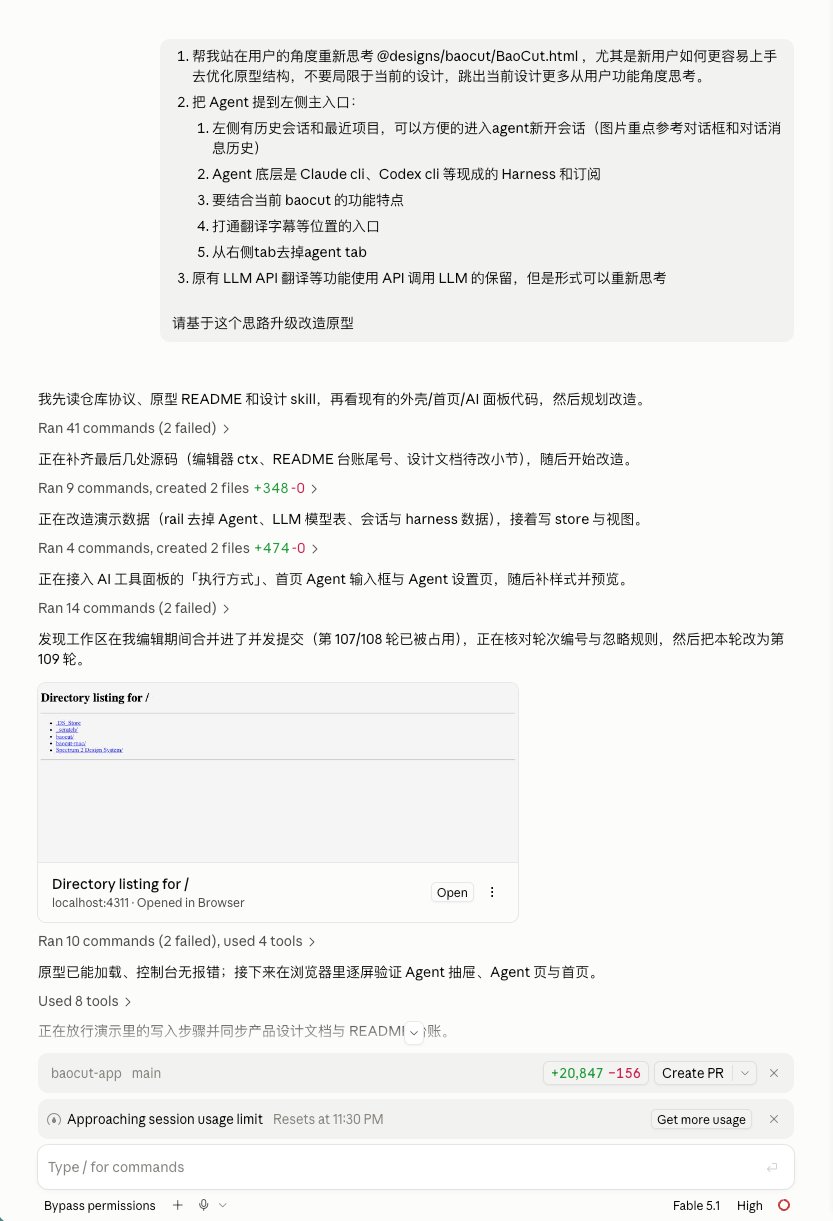 案例 102演示
使用完整需求重组 Agent、历史会话、项目和字幕翻译入口;结果仍是原型,无上线数据
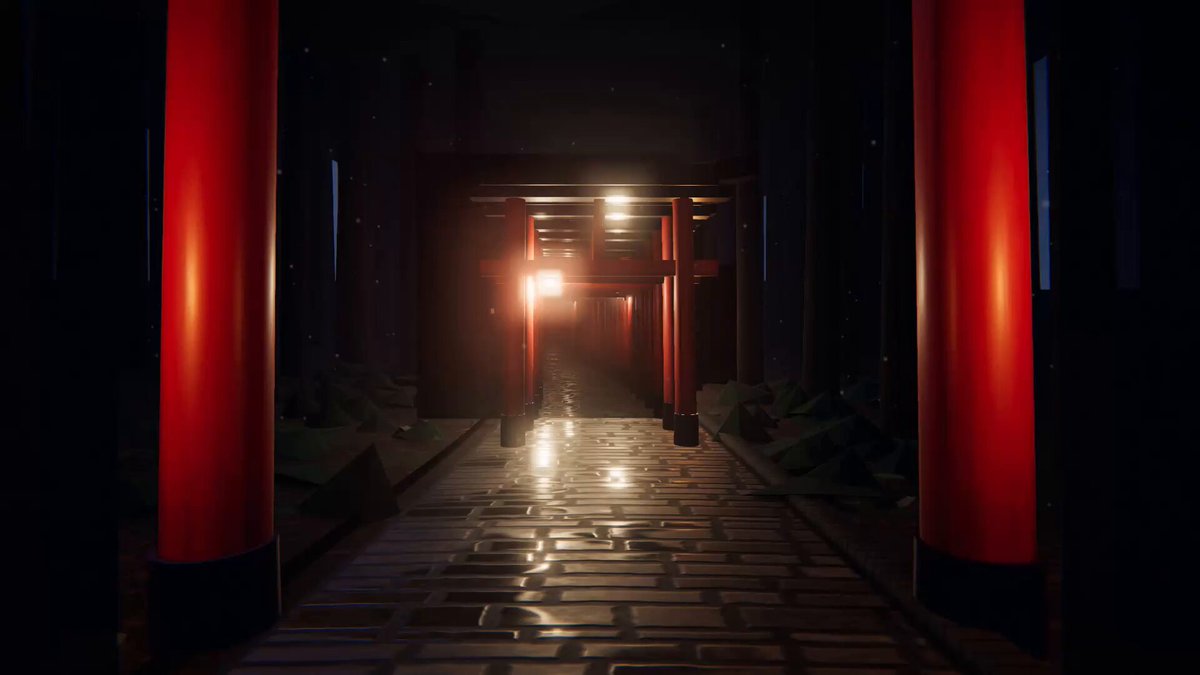 案例 103演示
18 分钟生成可步行世界并导出 15 秒视频;作者明确披露经过 3 轮修正,不是 one-shot
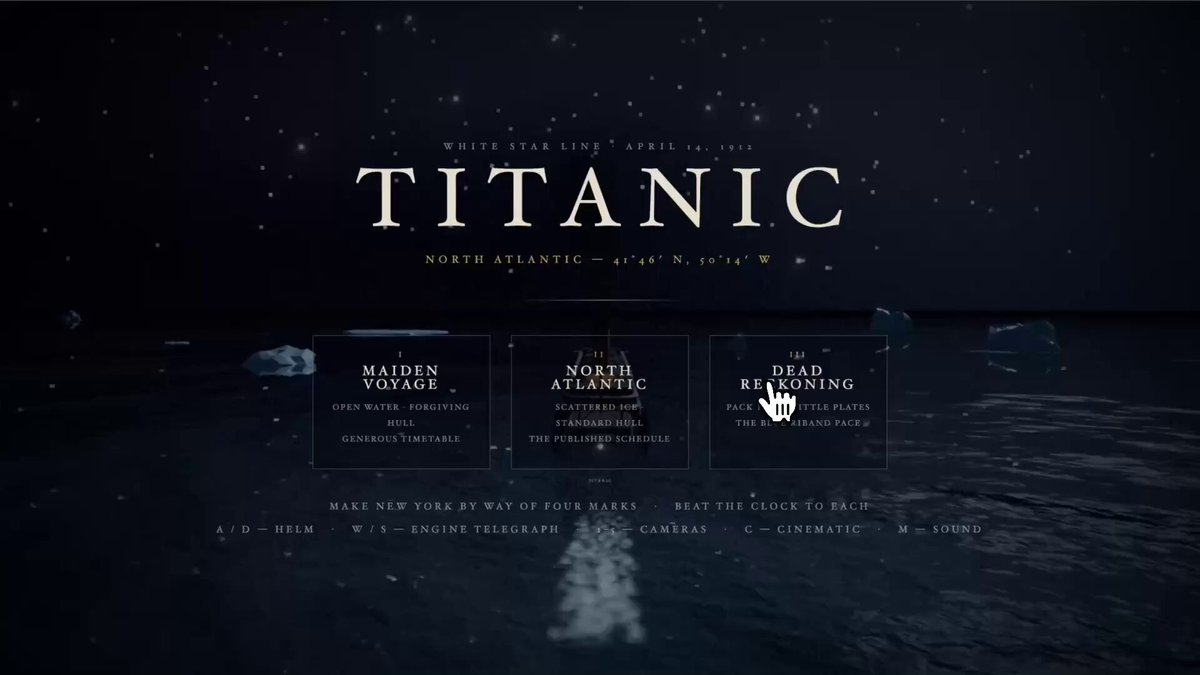 案例 104演示
两条 prompt 产出 Three.js 游戏、视角、转向、速度和任务系统;有 Netlify 入口,未实际试玩验收
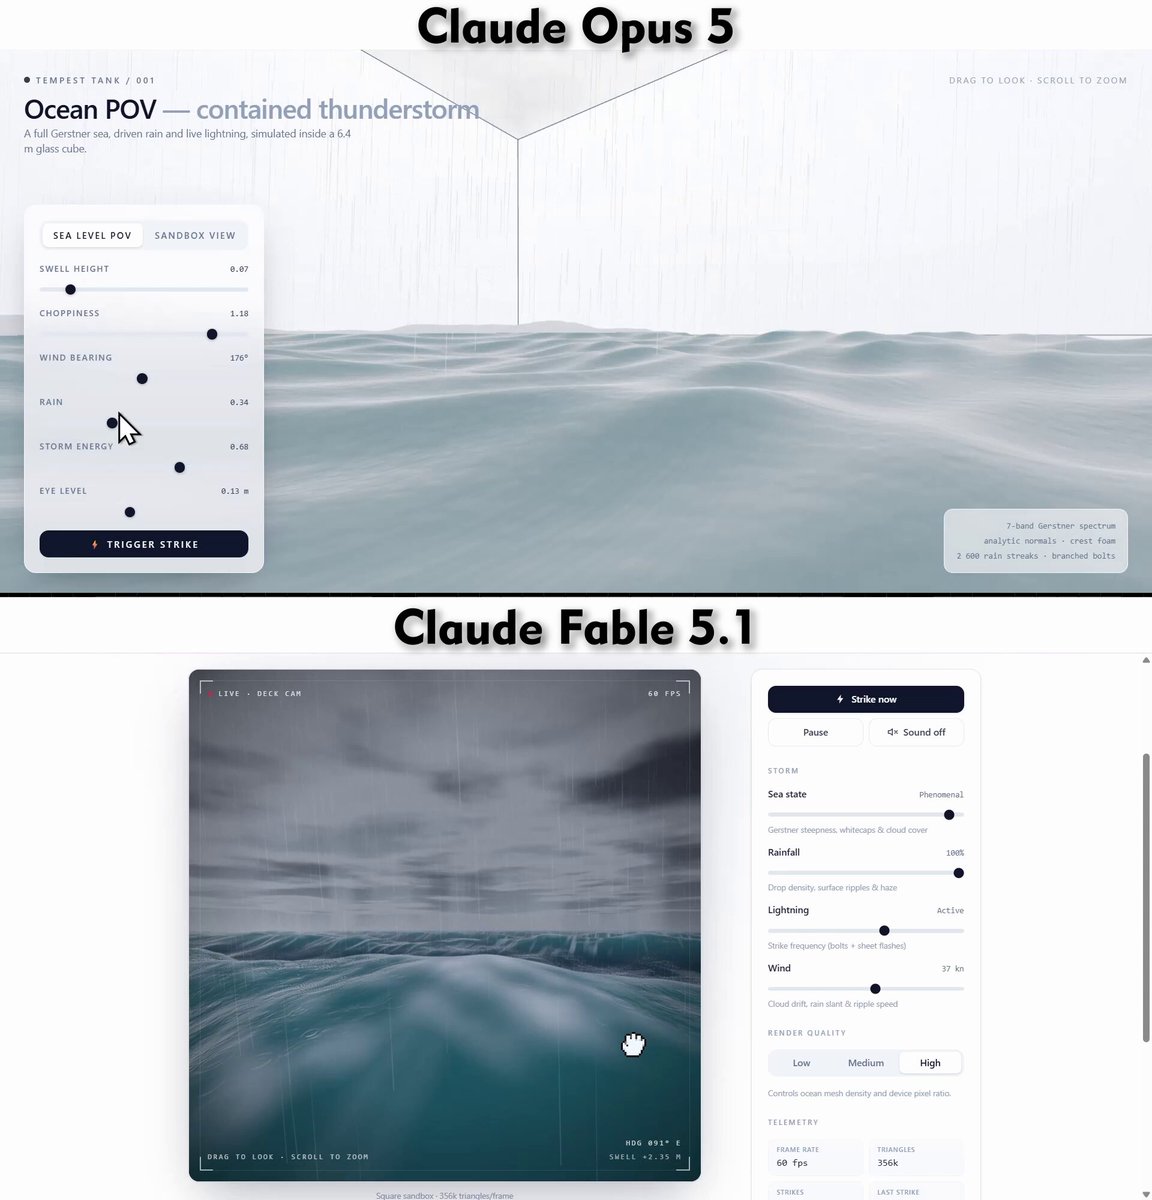 案例 105评测
用同 prompt 对比 Fable 5.1 与 Opus 5,展示海面、雨滴等视觉差异;评价为作者主观判断
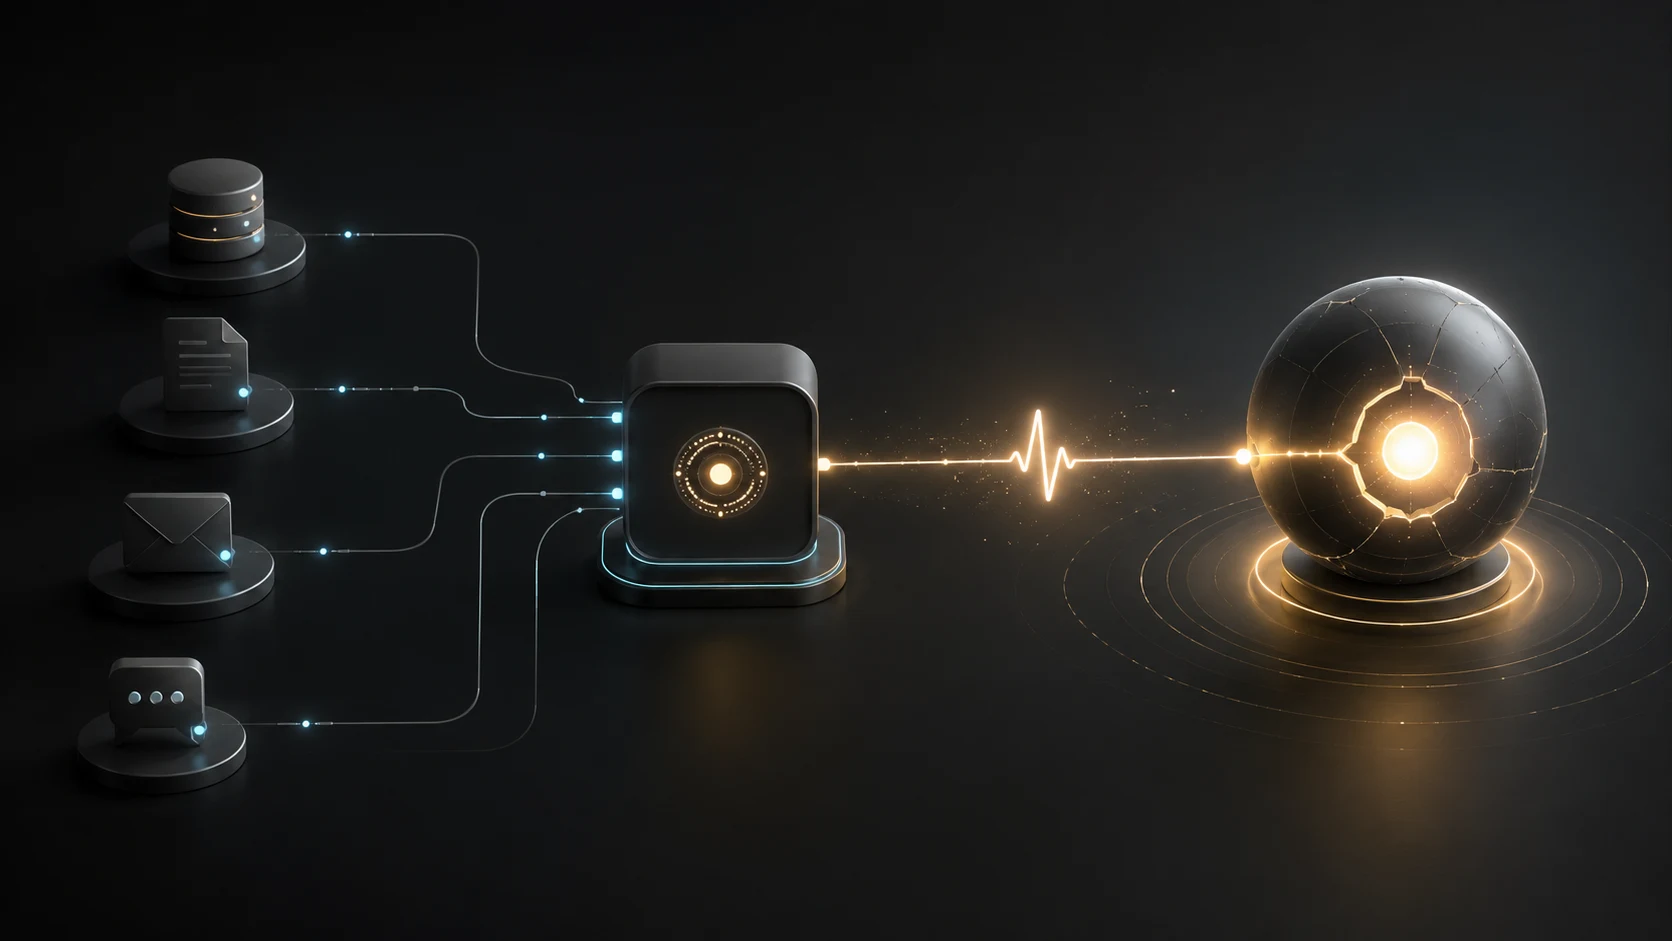 案例 106案例
作者称将 YouTube、邮件和 deals 轮询迁到自托管 n8n,仅在有事件时 webhook 唤醒 Bot;未披露账单降幅
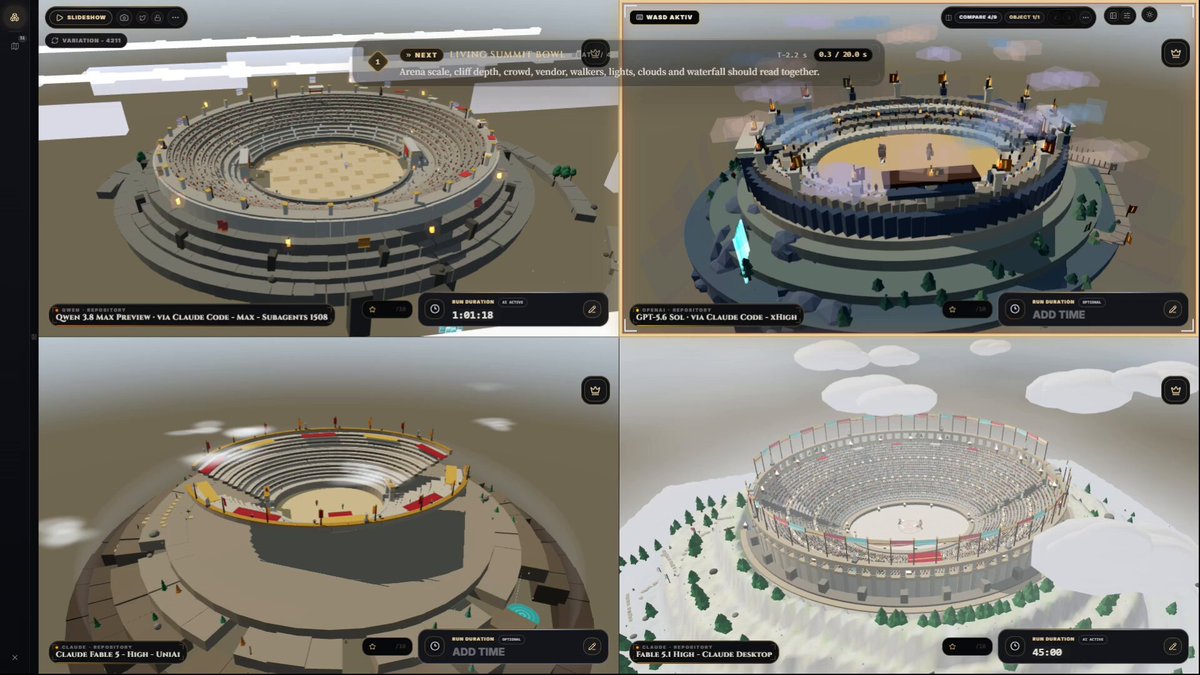 案例 107评测
作者称在最难的多约束测试中无碰撞,但未公开 rubric 和可重复的评分细节
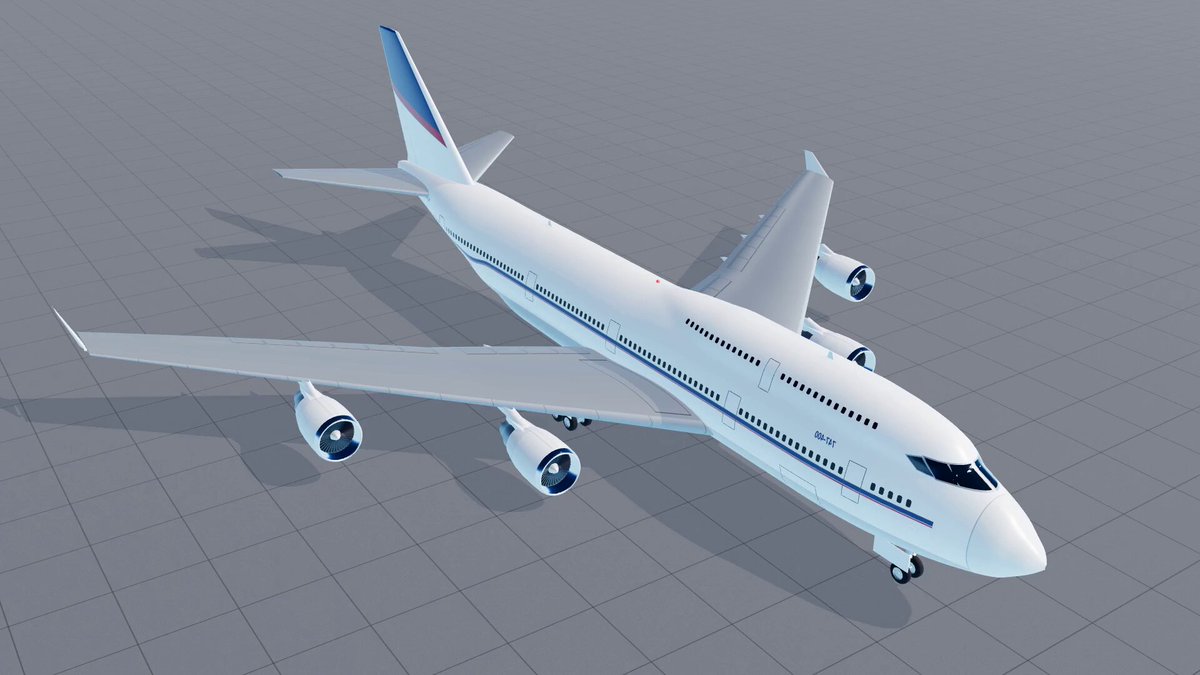 案例 108评测
原帖展示 5.1 的飞机生成结果并表示会在回复给出 prompt;本清单未独立评分
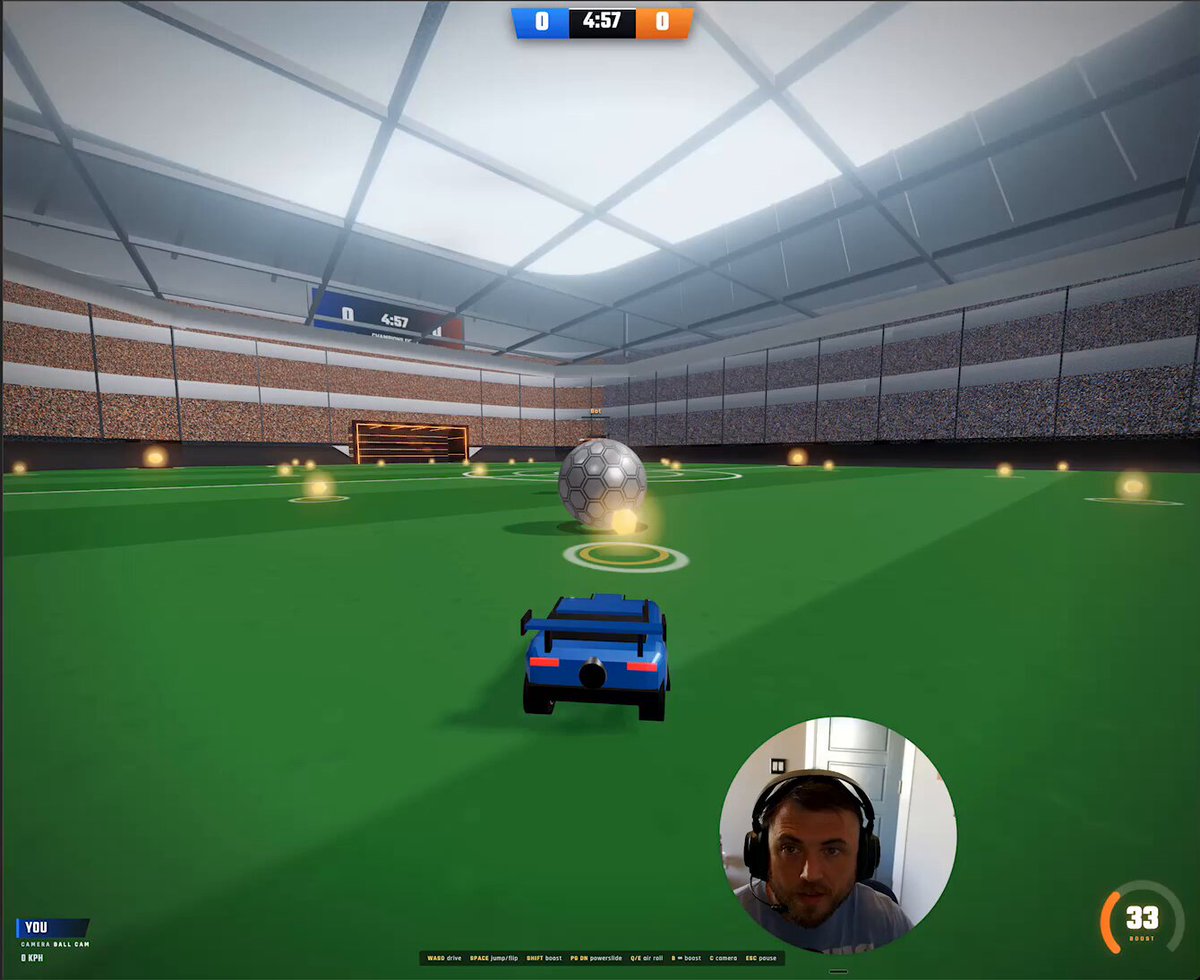 案例 109评测
两条 prompt 生成 3D 游戏,作者报告约 20 分钟并能够自查修复多个 bug;未给出独立通过率
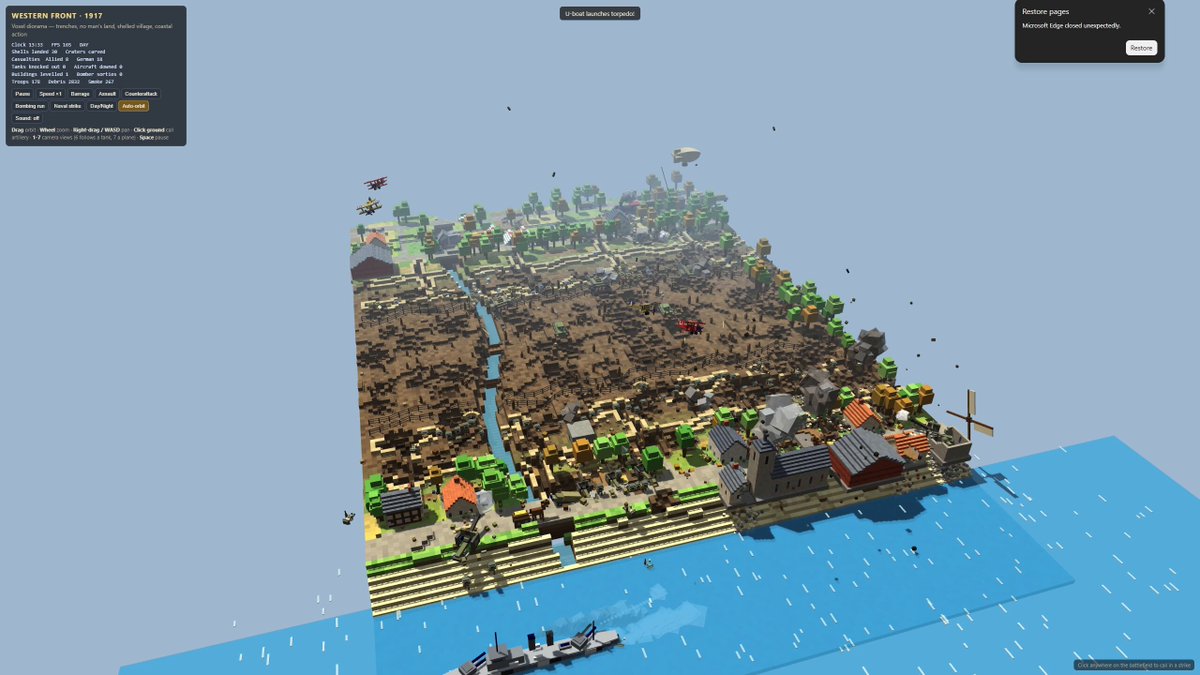 案例 110演示
有游戏式体素模拟器展示,原帖未披露 prompt、运行时间和机制验收
 案例 111评测
作者认为 Fable 5 的结构和文字更好,5.1 短句过多;仅一次测试,不能推广
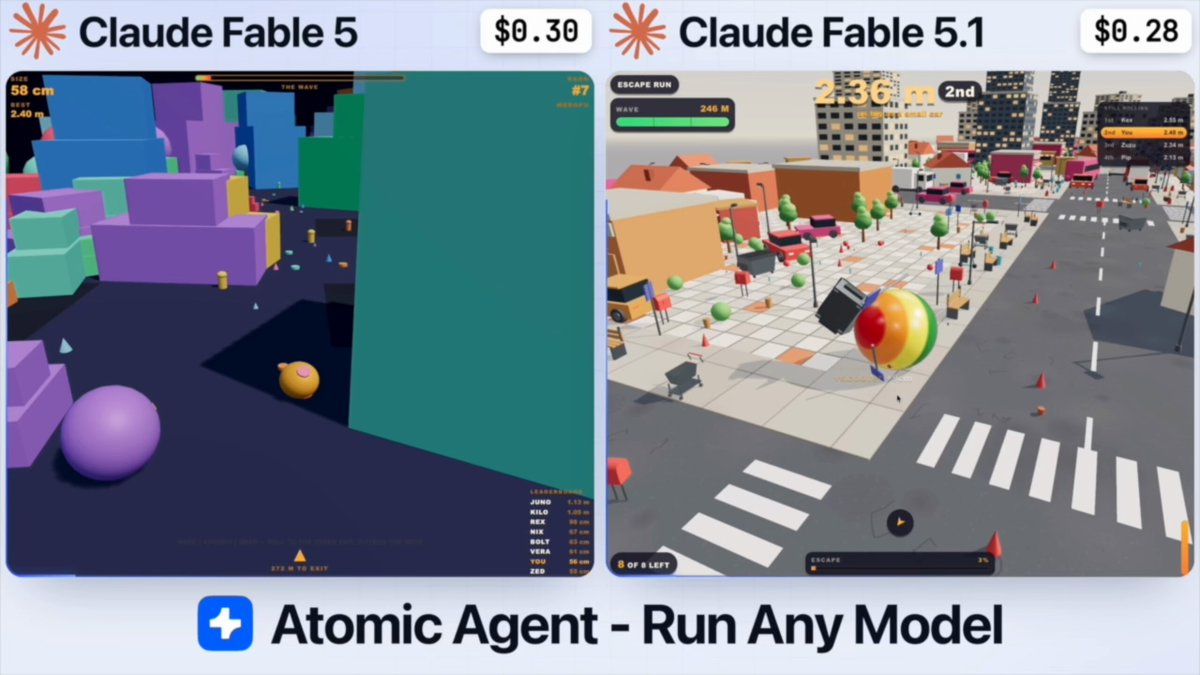 案例 112评测
Atomic Agent 报告黏球、水豚冲浪和饺子躲障碍三个任务合计从 $7.65 降到 $7.08;属平台自营测试
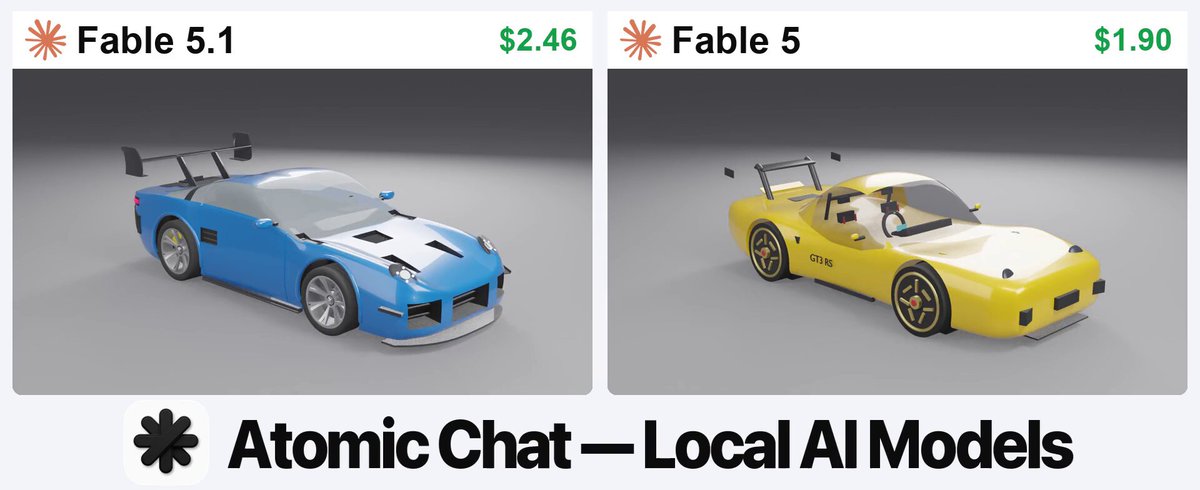 案例 113评测
5.1 报告为 1.2M tokens、$123.98、59.8 分钟,成本和时间均高于 Fable 5;属平台自营对比
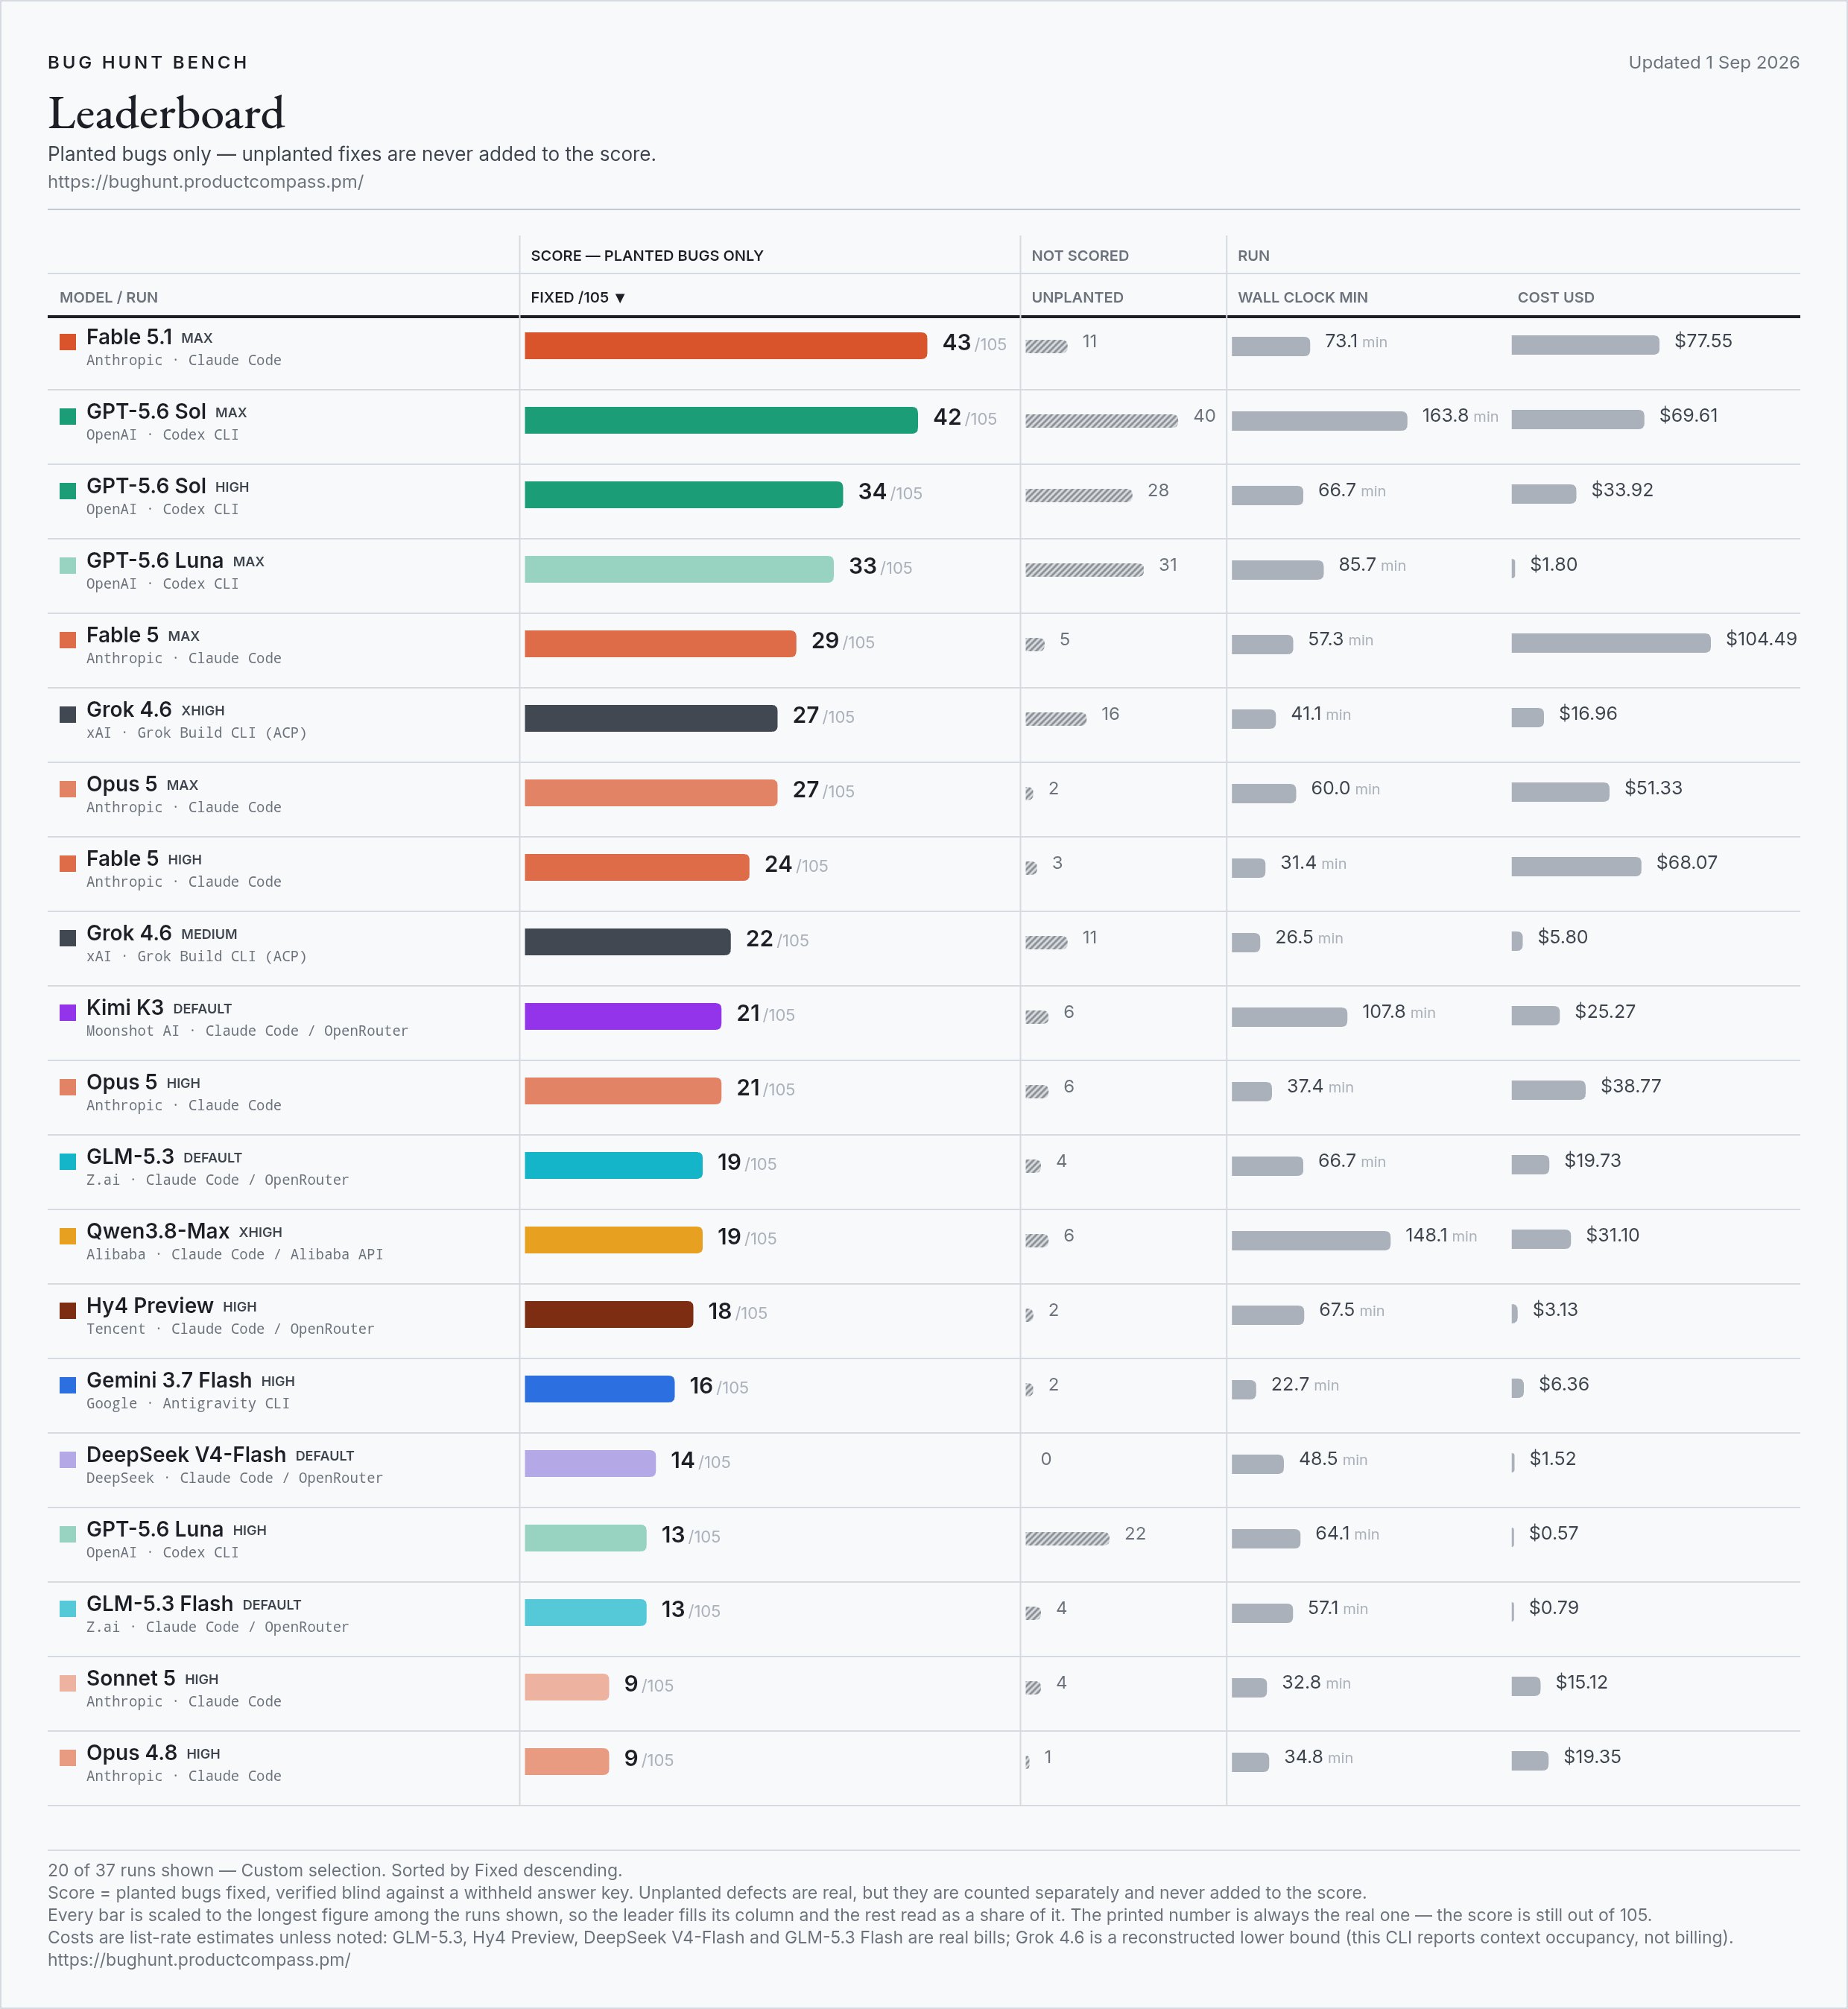 案例 114基准测试
在 2 个仓库、105 个植入 bug 中报告修复 43 个,略高于 GPT-5.6 Sol 的 42 个;未在本清单复跑
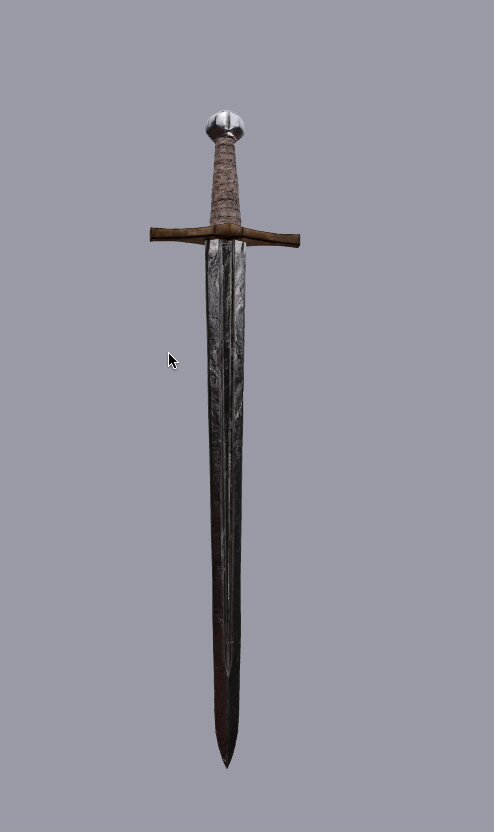 案例 115集成
3DAIStudio MCP 调用 GPT Image 2 与 Tripo P2,再用 Computer Use 操作 Blender 和 Substance 3D Painter;成果不能归因于单一模型
当前显示 48 / 116
BUILD WITH EVOLINK / 04
通过 EvoLink 接入模型,沿着已验证的案例方向开始构建。