
 案例 01评测
网页、3D 与 SVG
同一提示词比较 Sol 与 Luna 的落地页
作者将两款 GPT-6 模型加入同提示词落地页对比站;结果已展示,但本站未独立复现。
内容最近更新 / (上海时间)
林悦己 / ARCHIVE
查看 GPT-6 Sol 与 Luna 在网页、游戏、Agent、视频工作流和评测中的公开案例,区分模型贡献、失败记录与作者自述。
USE CASE MAP / 01
只收录能明确归属 GPT-6 Sol 或 Luna 的公开任务、评测与失败记录。每条保留作者和原帖;结果多为作者或平台自述,本站未独立复现。
HOW TO USE / 02
先核对卡片中的子型号和任务,再回到原帖查看实现方式、工具依赖与证据边界。
从编码、Agent、创意或评测等任务入口缩小范围。
按标题、方法或作者找到与你当前问题最接近的案例。
点击作者核对演示、限制、上下文和创作者的完整说明。
选择值得验证的方法,通过 EvoLink 接入模型并形成自己的流程。
REAL CREATOR CASES / 03
每行最多四个案例;点击作者可打开该案例的原始出处。图片与视频按需加载。
58 个案例
案例 01评测作者将两款 GPT-6 模型加入同提示词落地页对比站;结果已展示,但本站未独立复现。
作者以相同提示词和 max 档比较 Sol 与旧版 Opus 5;对手不是 Opus 5.5。
API 平台展示质量与成本对比;结果来自平台自测,本站未复现。
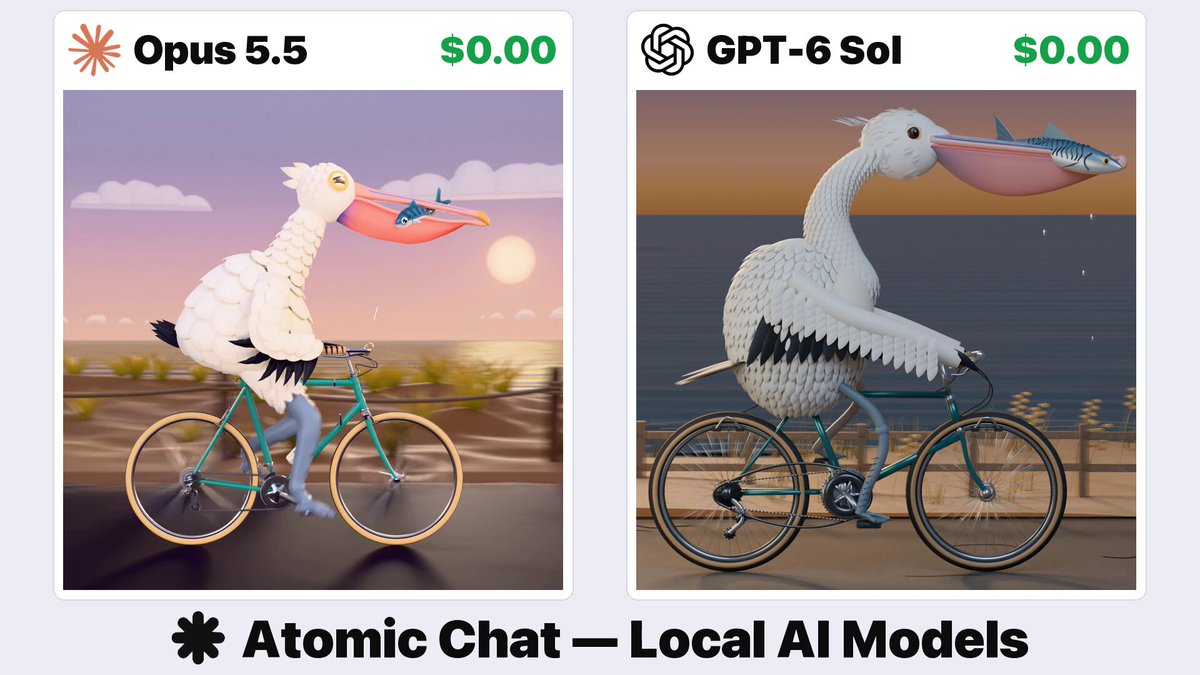 案例 04评测
平台以相同 brief 比较 Sol 与 Opus 5.5;画面优劣是发布者评价,本站未复现。
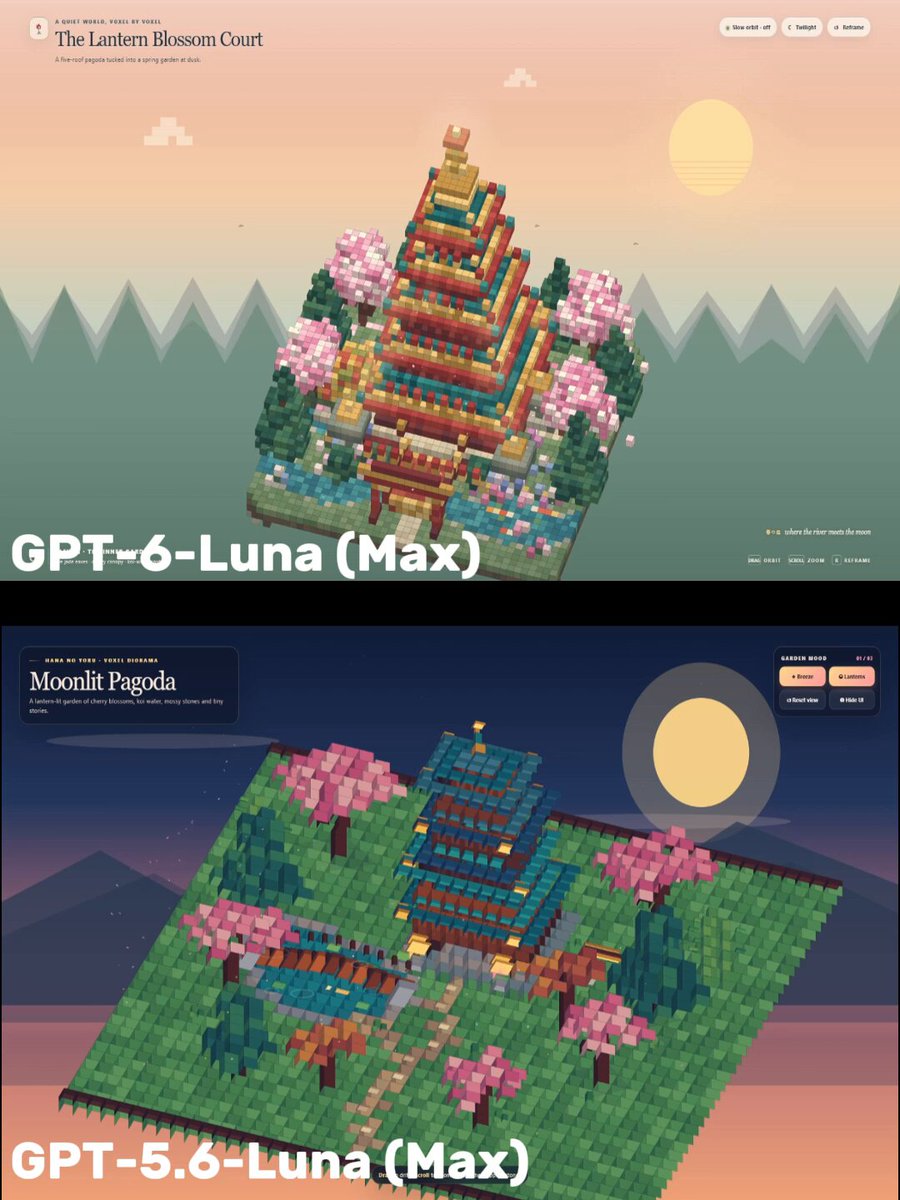 案例 05评测
同任务对比 GPT-6 Luna Max 与 GPT-5.6 Luna Max;有视觉输出,未核验源码。
具体 SVG 任务对比 Sol xHigh 与 Astra High;有画面,未核验源代码。
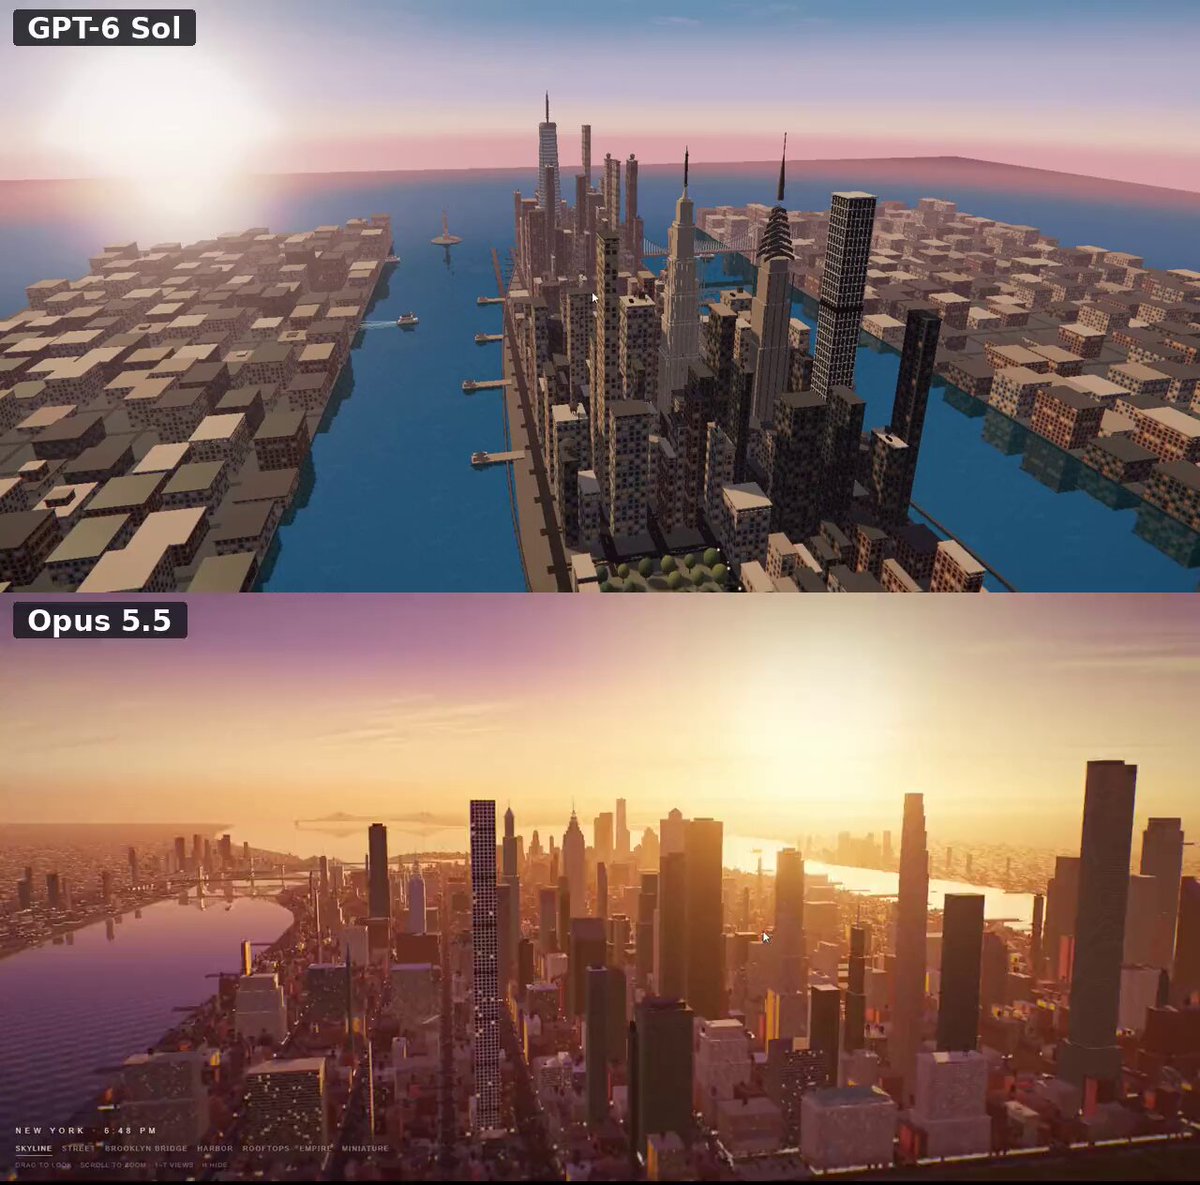 案例 07限制
作者称 Sol 未实现要求的 render loop 和镜头移动;记录为未完成结果。
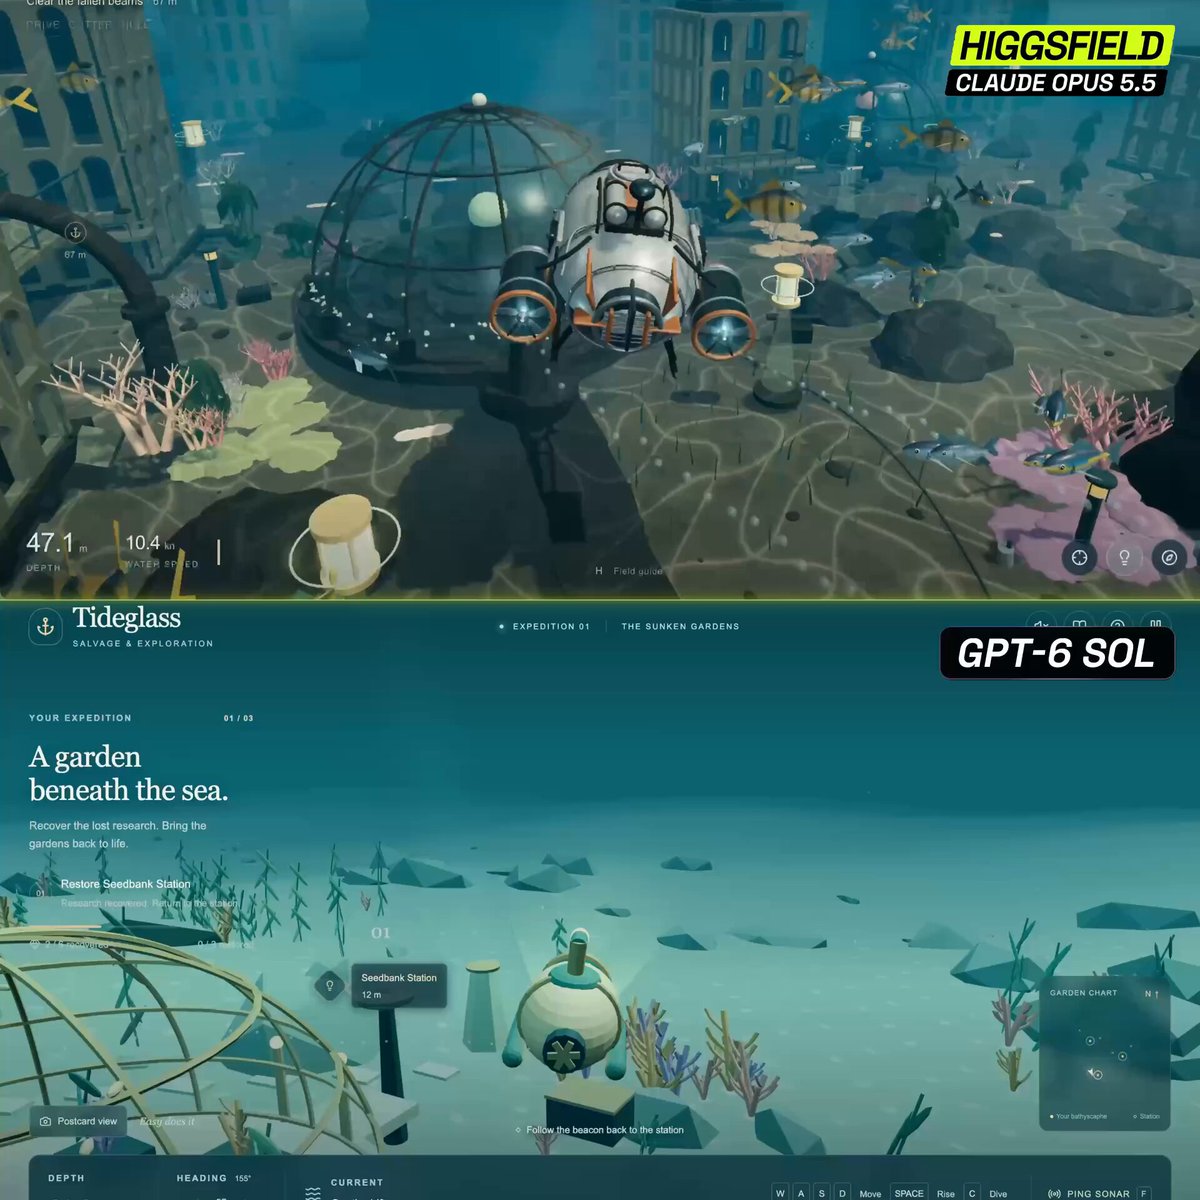 案例 08评测
Higgsfield 比较 Sol 与 Opus 5.5 的游戏制作;工程与可玩性未独立测试。
作者发布简短游戏演示;本站未独立运行。
作者展示 Sol 产物;源码与可玩性未核验。
JetBrains 展示员工用 Sol 制作的游戏;证据来自平台官方演示。
 案例 12演示
作者展示视频,但未披露制作链路,不能据此认定 Luna 原生生成视频。
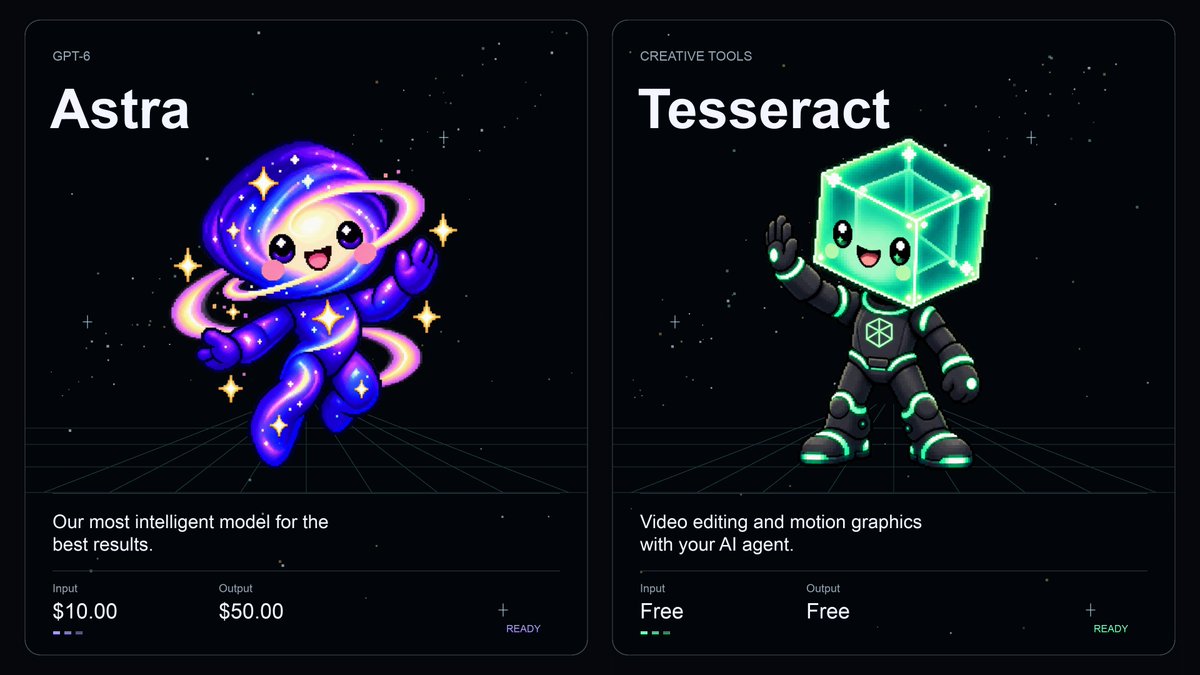 案例 13评测
Mirage 展示两款模型配合 Tesseract 的结果;渲染依赖视频工具,本站未复现。
作者演示几轮提示词的视频工作流;不将外部工具的生成归为 Sol 原生能力。
 案例 15演示
联合创始人展示 Sol 辅助的视频修改;属于产品演示,未独立复现。
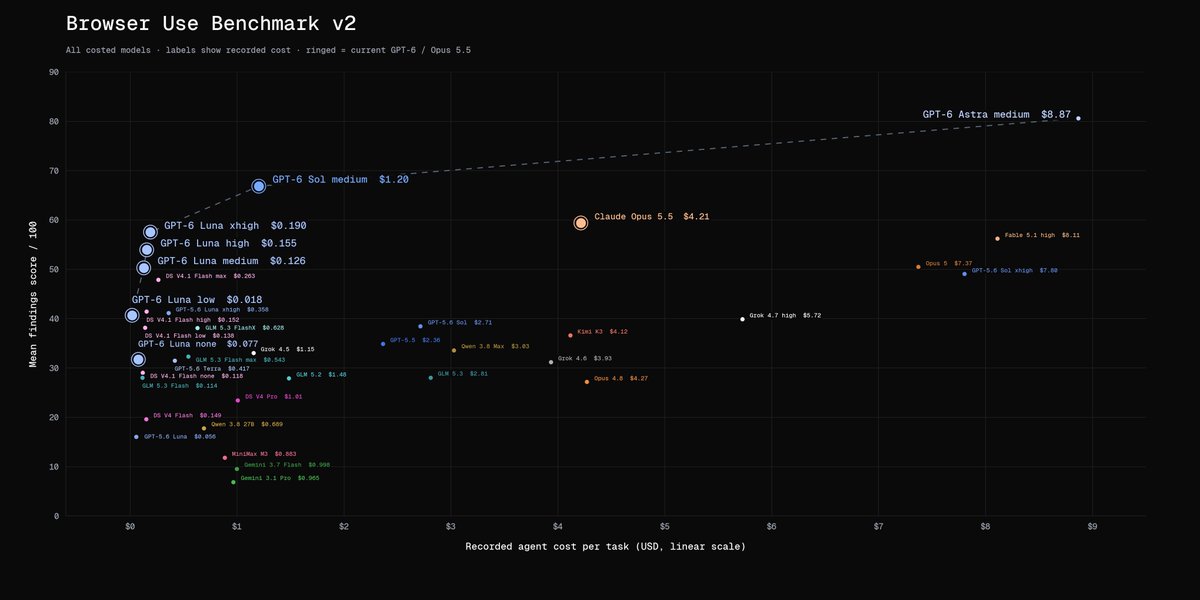 案例 16基准测试
Browser Use 发布长难度任务与成本对比;数字为平台自测,不能泛化到所有浏览器任务。
作者自述已切换既有任务;Luna 替换其他 API 仍是计划。
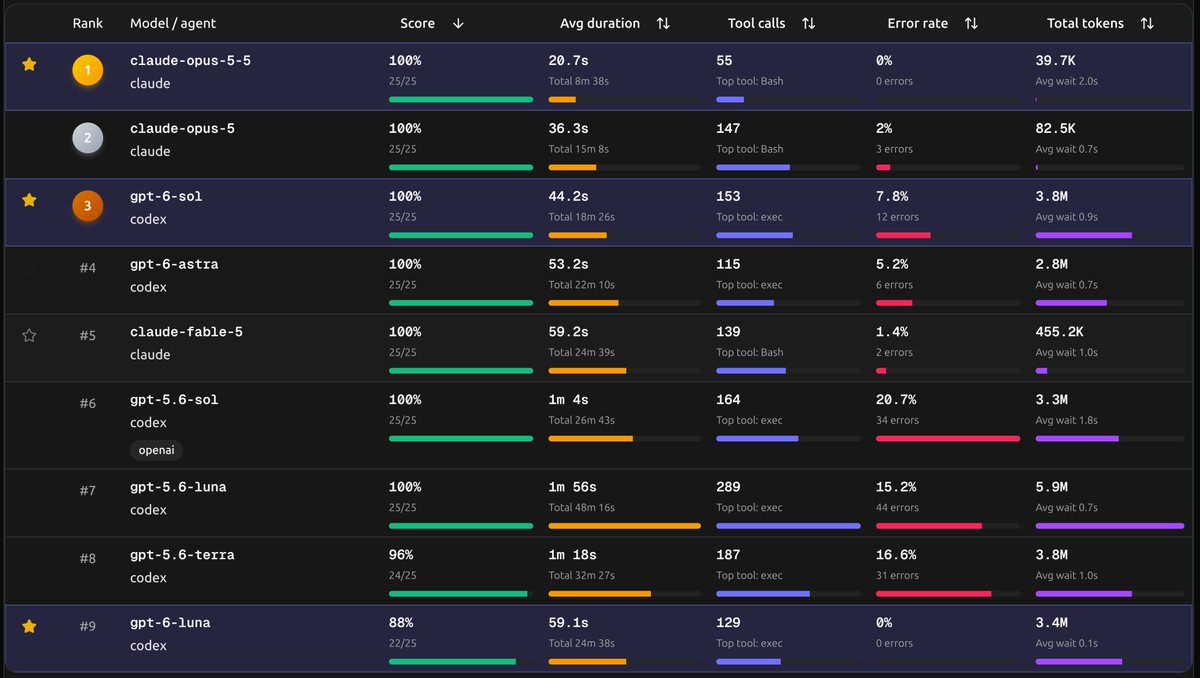 案例 18评测
研究者自测 Sol 改善、Luna 退步;本站未复现,保留正反结果。
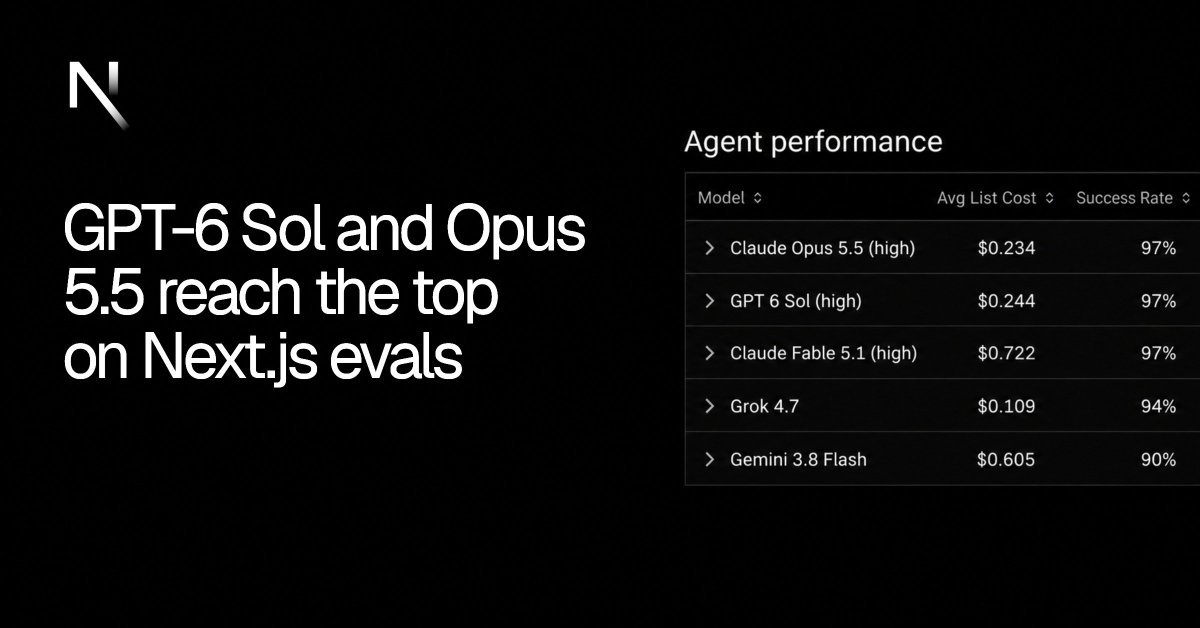 案例 19基准测试
Next.js 团队公布特定评测中 Sol 成功率 97%;不能外推到所有软件开发任务。
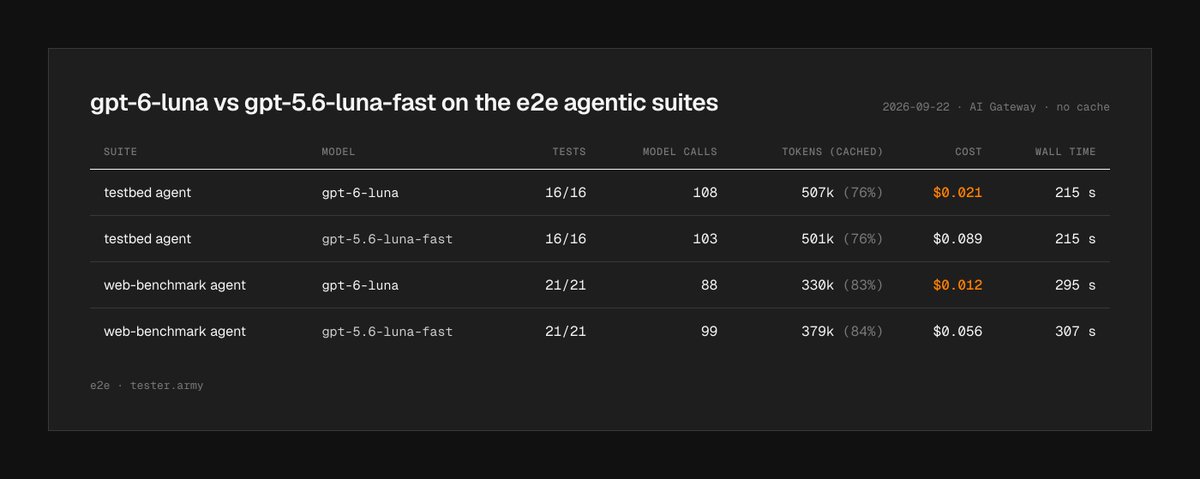 案例 20评测
作者自述两套测试全过,费用分别为 0.03 与 0.15 美元;成本未独立核验。
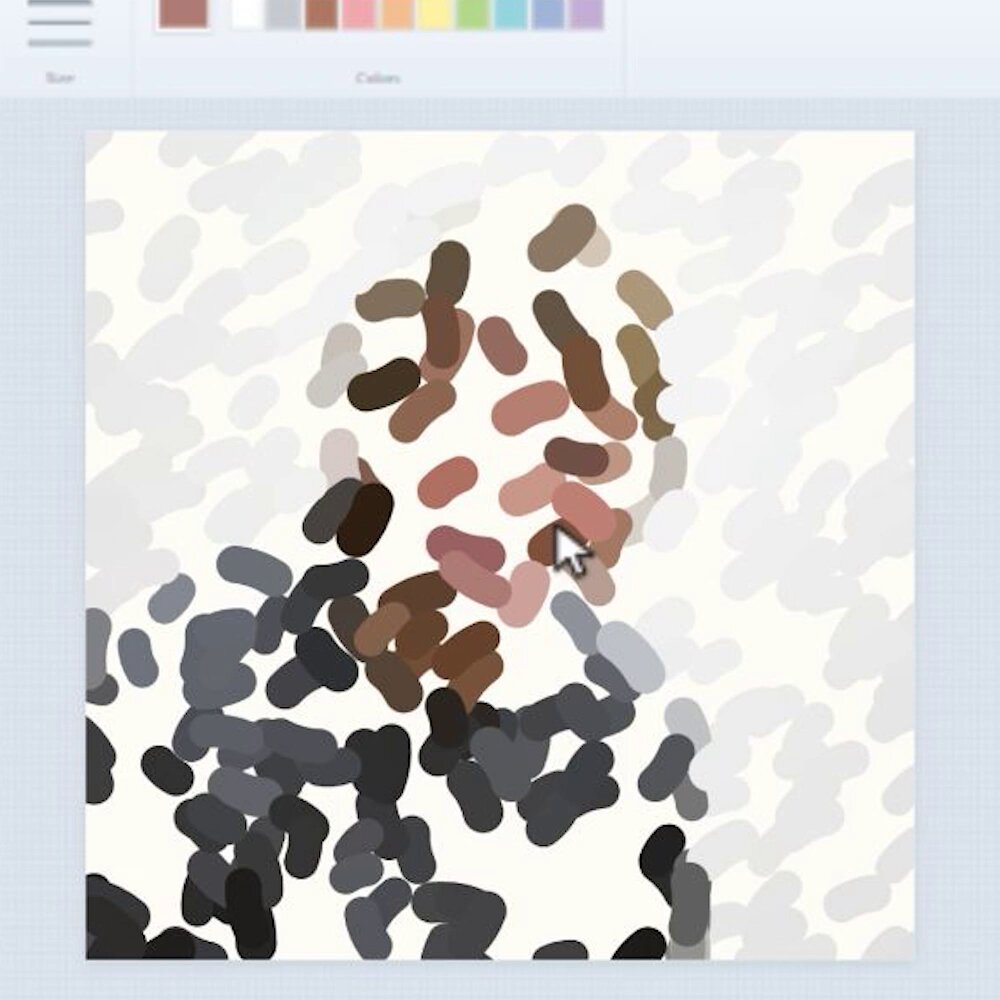 案例 21演示
作者给出操作指令与结果媒体;本站未复现浏览器操作。
发布者按十类题材生成 50 稿并用三个 AI 评审;结果不能代表真实观众反馈。
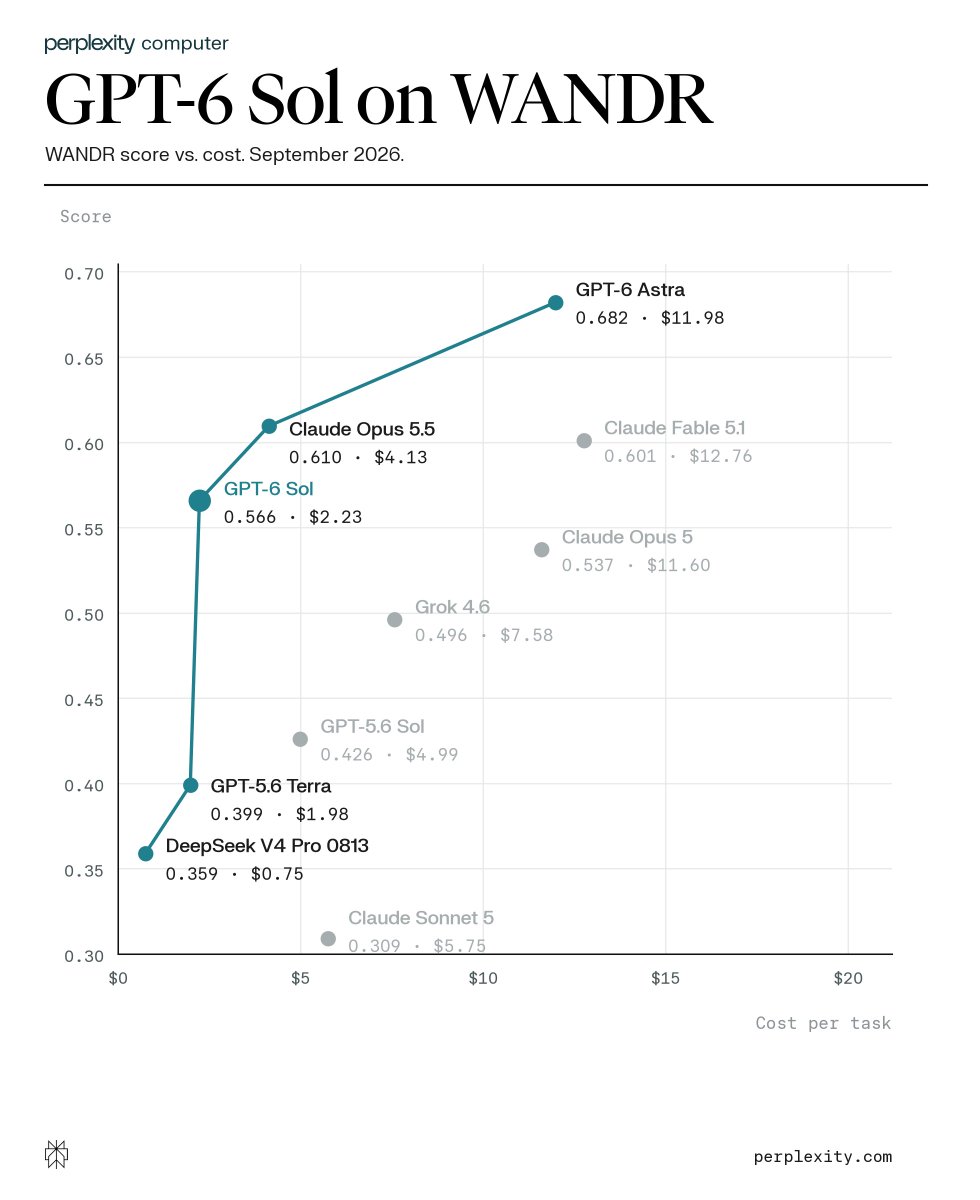 案例 23评测
Perplexity 自述 WANDR 评测,计划把 Sol 用于 Light 编排;计划与已测结果分开。
研究者记录打开炉灶并放置摩卡壶的失败;任务名称来自所引 Astra 实验。
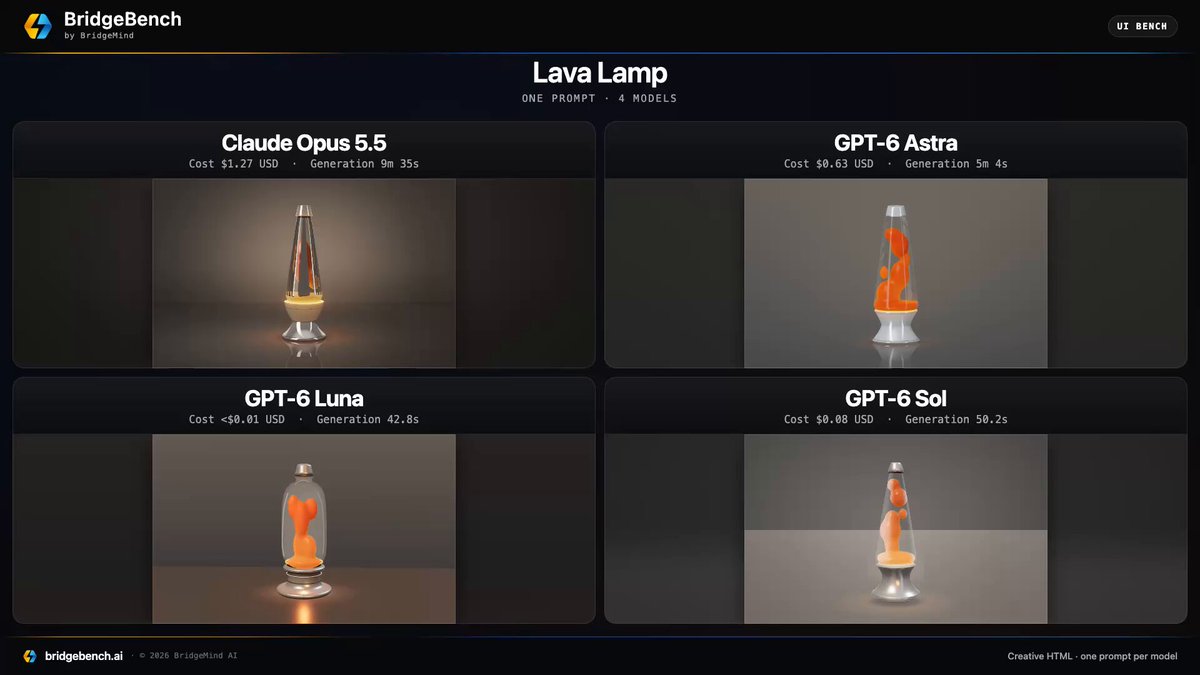 案例 25评测
BridgeBench 用同一提示词比较四款模型;Sol/Luna 的耗时与费用仅对应这次测试。
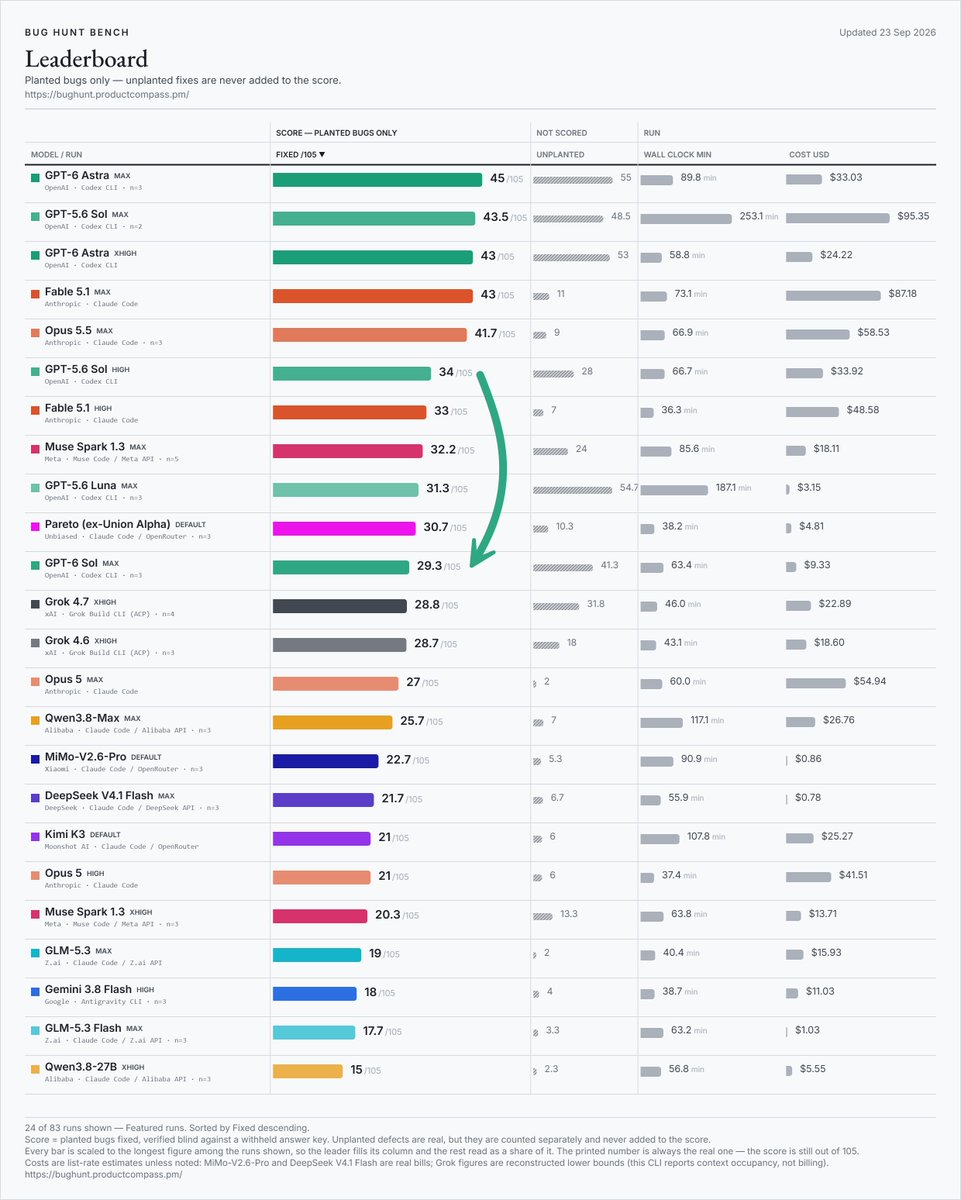 案例 26基准测试
发布者报告 Sol Max 在 105 个预埋缺陷中找到 29.3 个,估算成本较低,但该次质量下降。
作者称 Luna 在四种 harness 中都忽略 GitHub 集成,改用浏览器执行仓库审查。
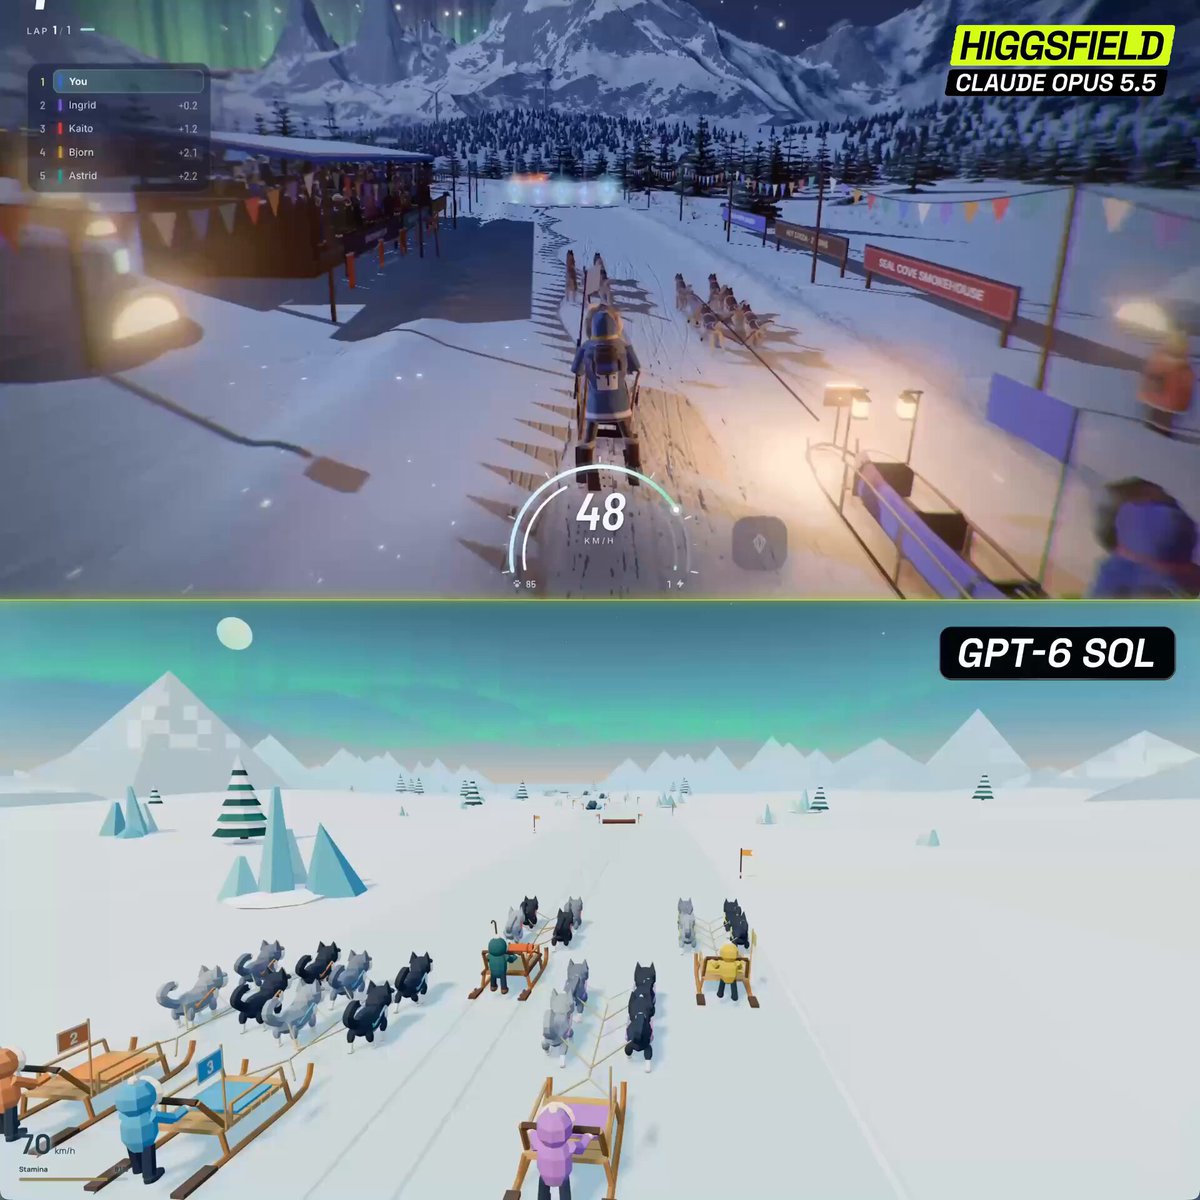 案例 28演示
Higgsfield 展示 Sol 与 Opus 5.5 的游戏对比;制作环境由平台提供,未独立试玩。
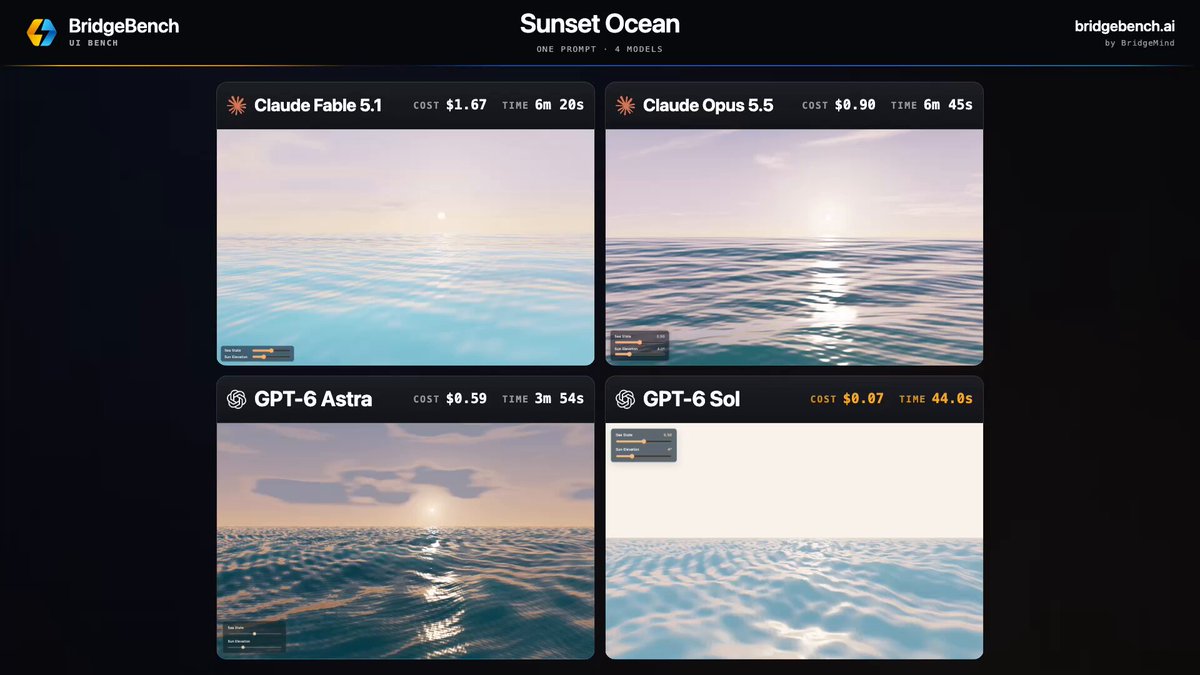 案例 29评测
BridgeBench 报告 Sol 用 44 秒、0.07 美元完成同题场景;只是一次视觉对比。
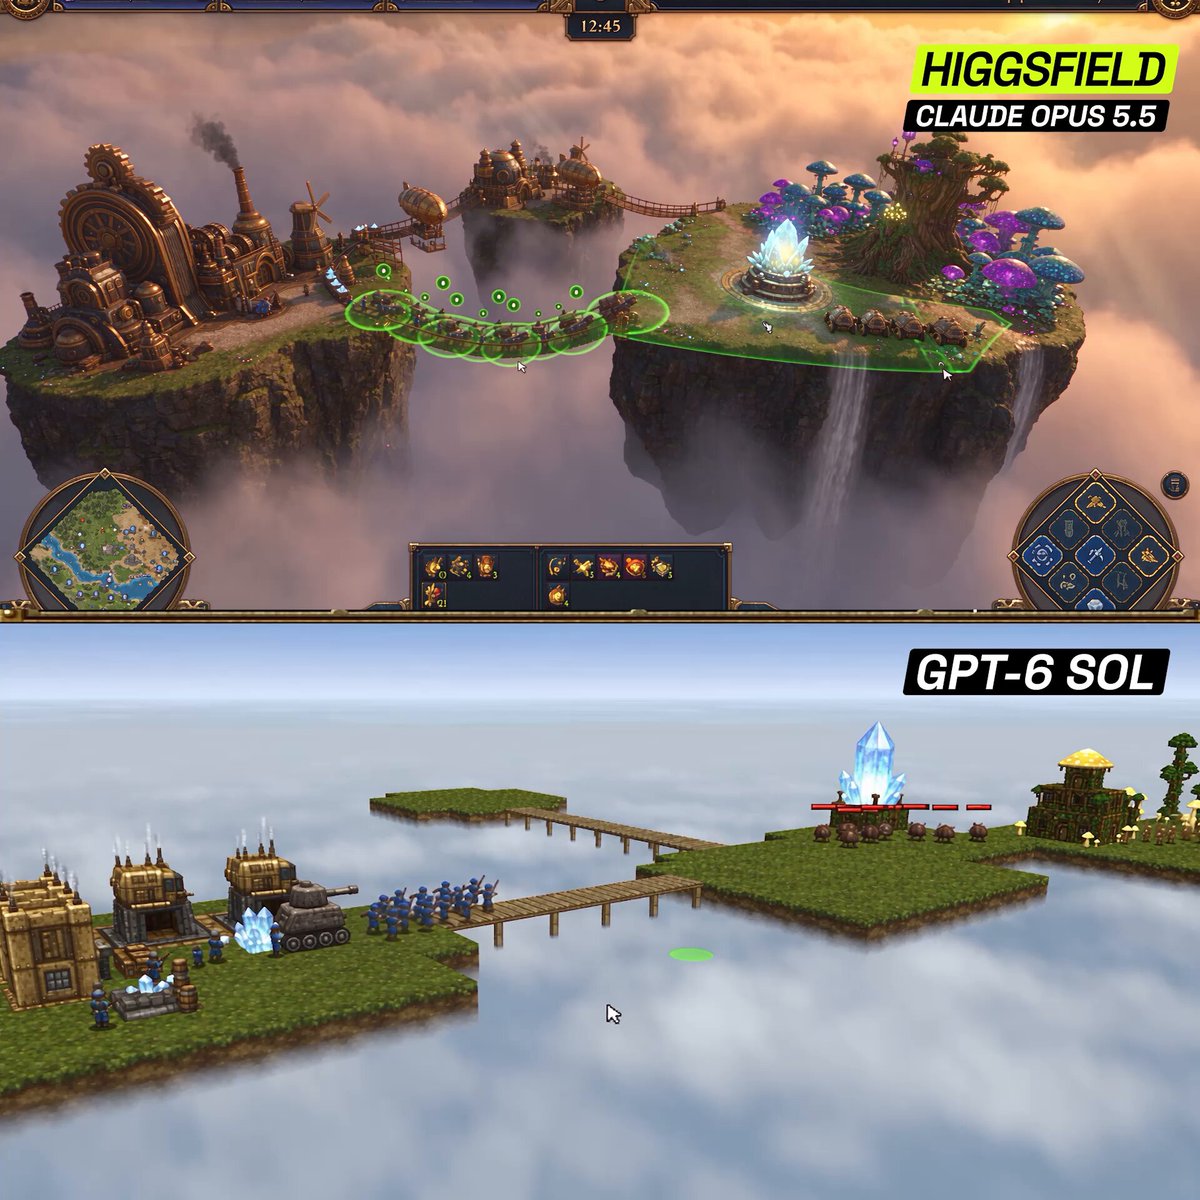 案例 30演示
Higgsfield 比较 Sol 与 Opus 5.5 的战场规模原型;属于平台演示。
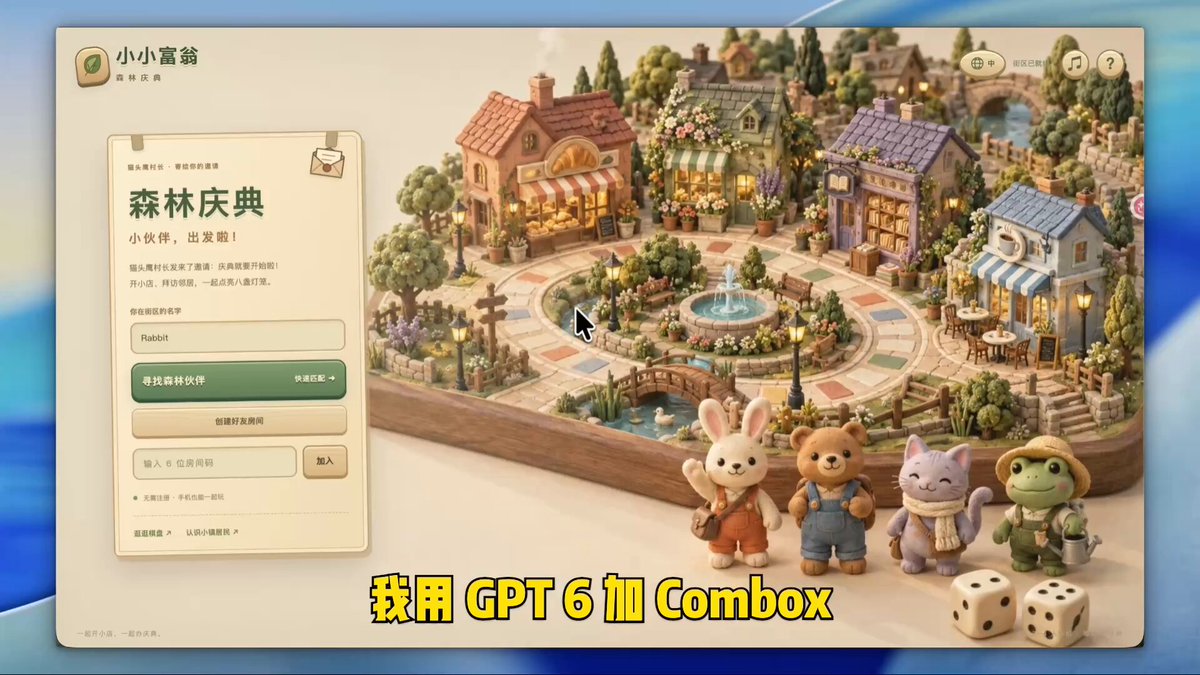 案例 31演示
作者用 Sol 与 Combos CLI 制作 2–4 人棋盘游戏;素材、联机和发布由外部工具完成。
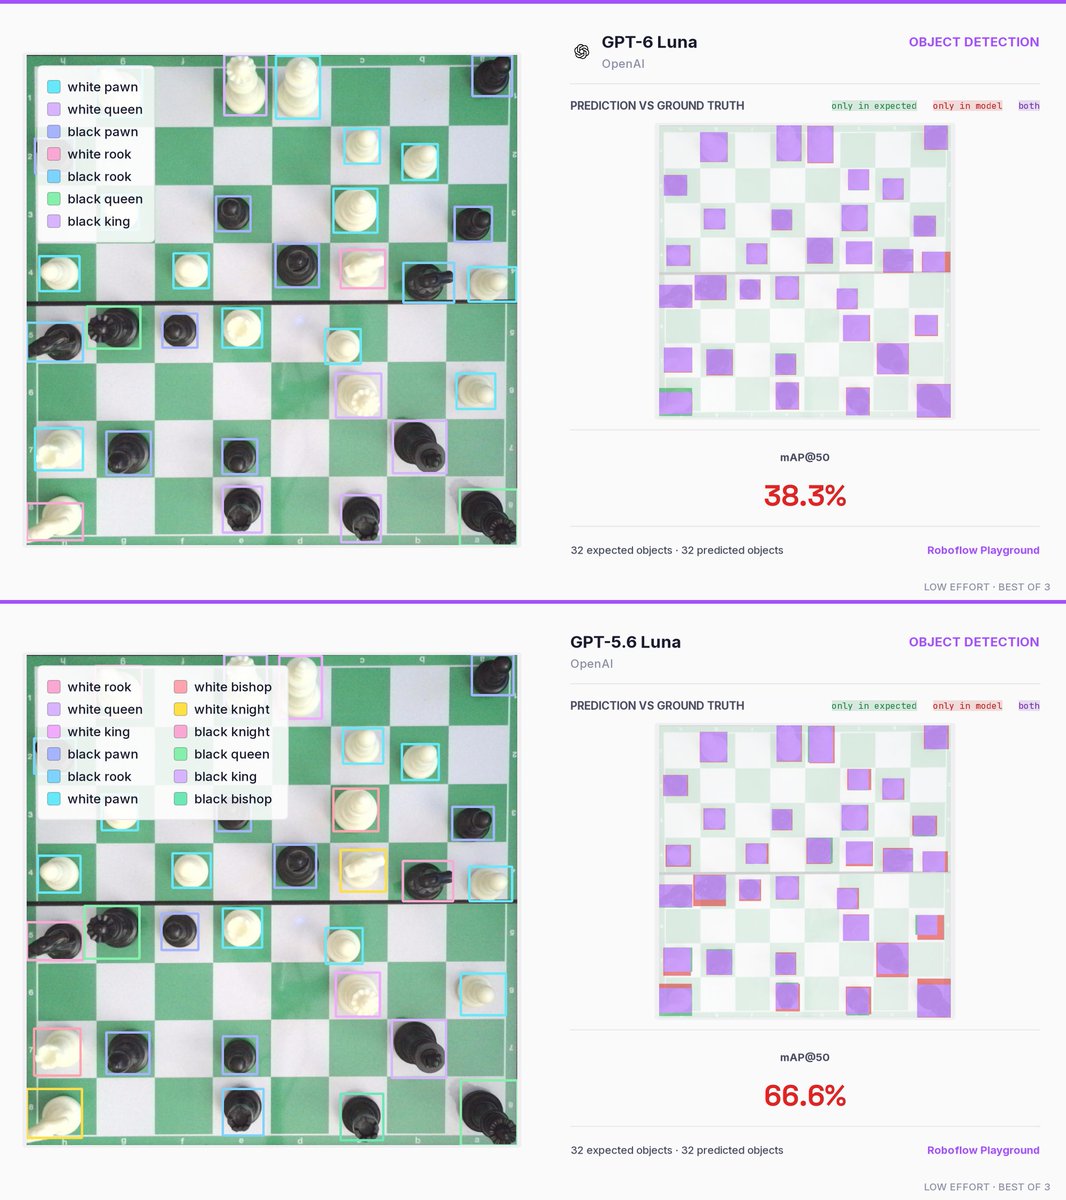 案例 32基准测试
Roboflow 自测称抽取、计数、推理低于 5.6 Luna,目标检测略有提高。
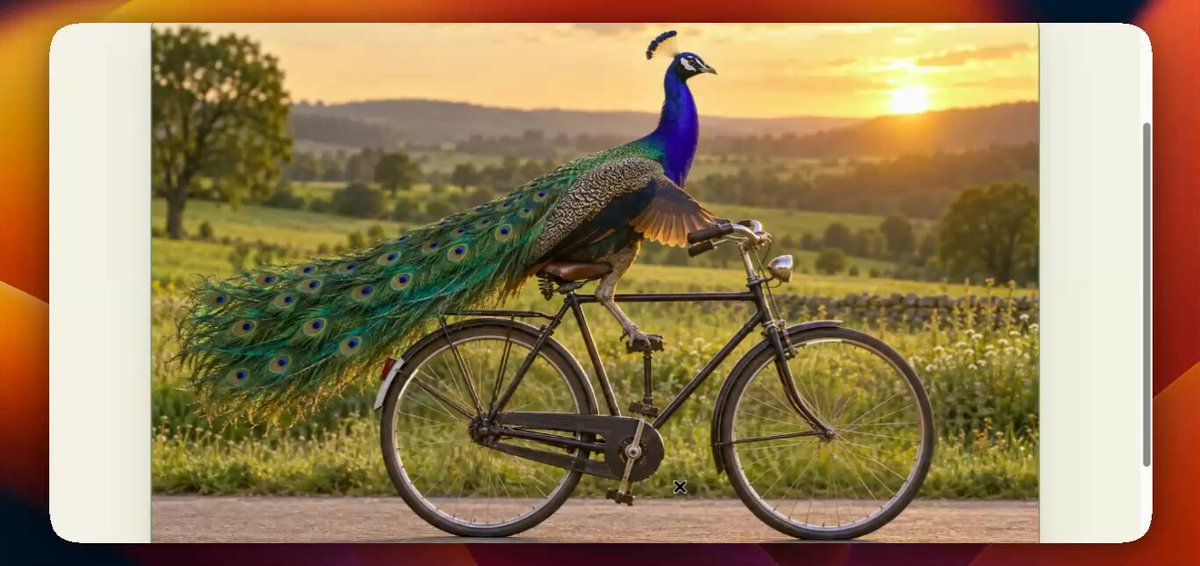 案例 33限制
作者称 Luna 用图片和旋转圆圈代替完整动画;属于具体失败反馈。
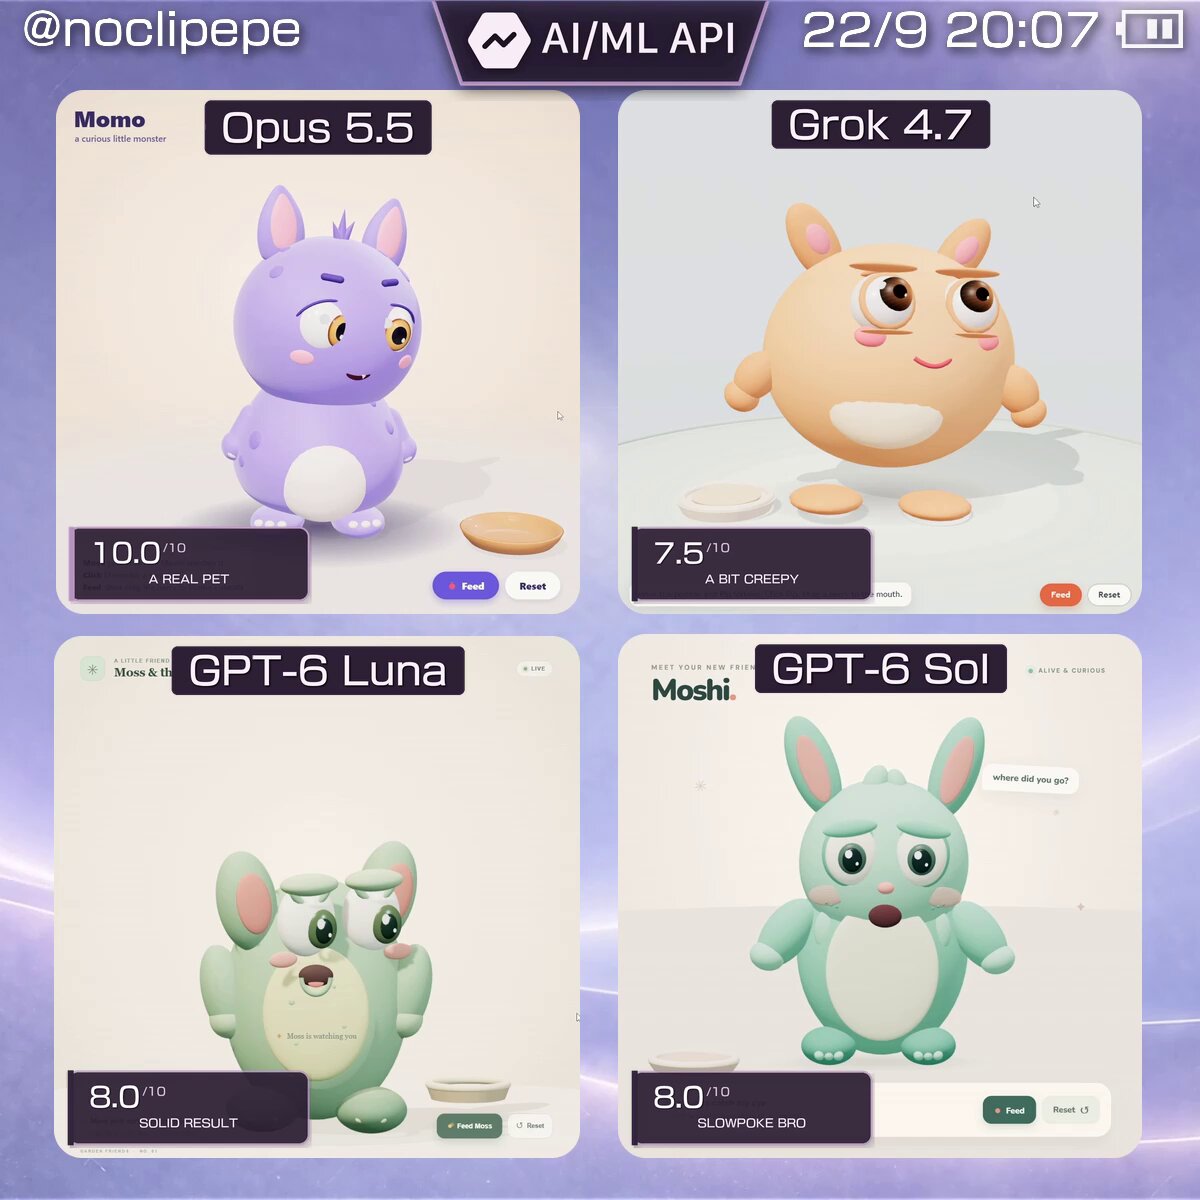 案例 34评测
同题任务要求怪物跟随光标并对喂食作反应;发布者称 Luna 最快,但表情效果有限。
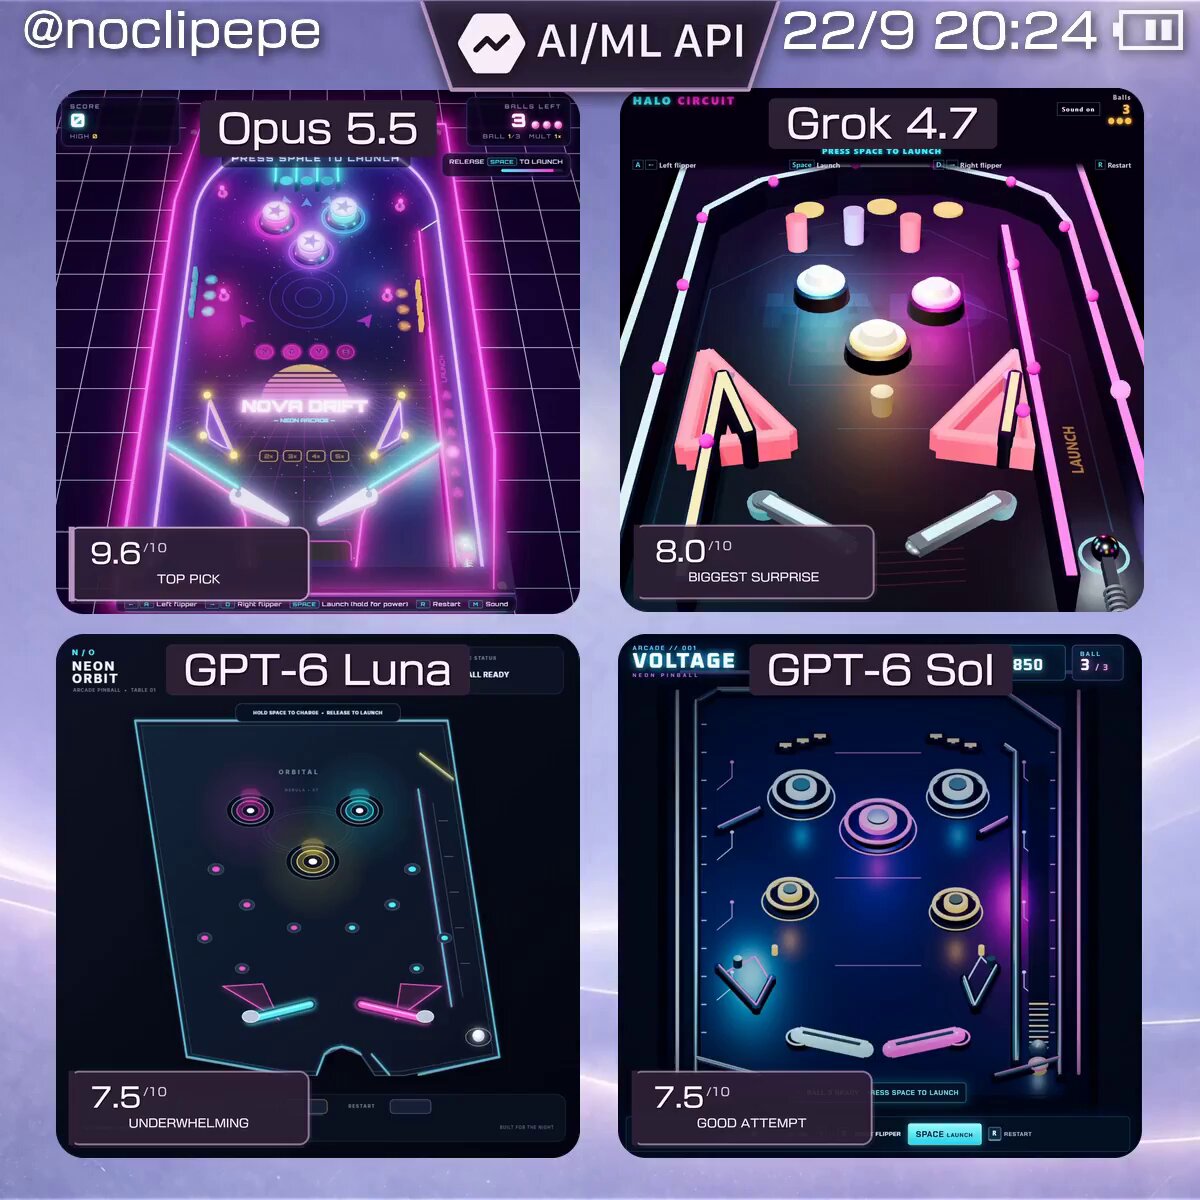 案例 35评测
同题可玩弹球任务中,发布者报告 Luna 耗时 6 分 22 秒、Sol 耗时 17 分 26 秒。
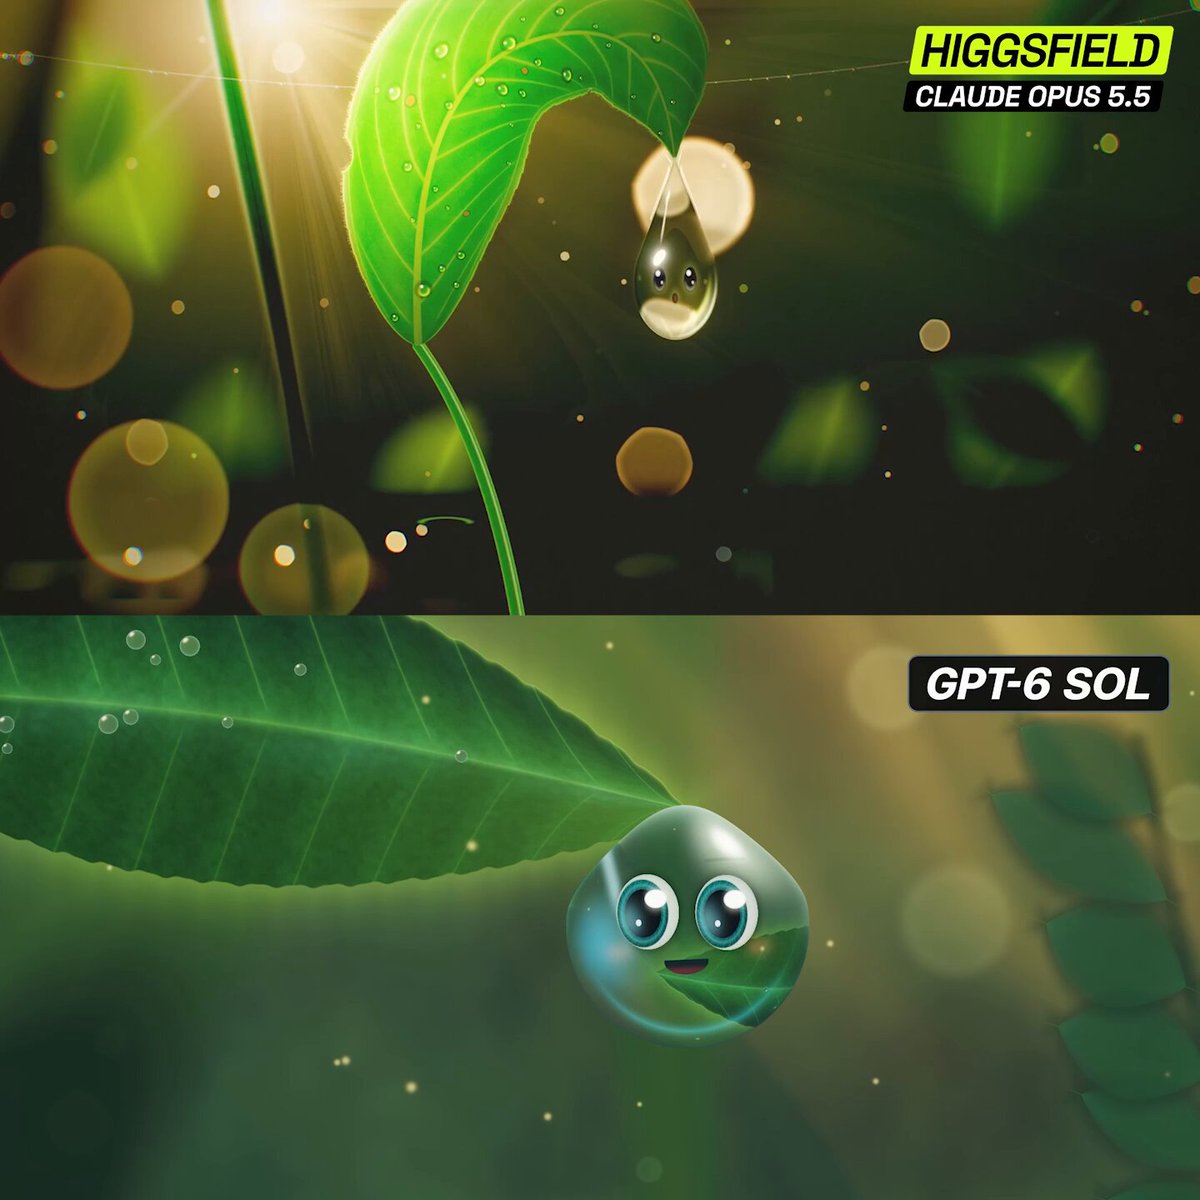 案例 36演示
Higgsfield 展示单文件 HTML 和浏览器实时渲染;Sol 负责代码,不是原生视频生成。
 案例 37评测
作者称 Sol 用十分钟完成三颗行星;与 Opus 的订阅额度来自不同套餐,不能直接等价。
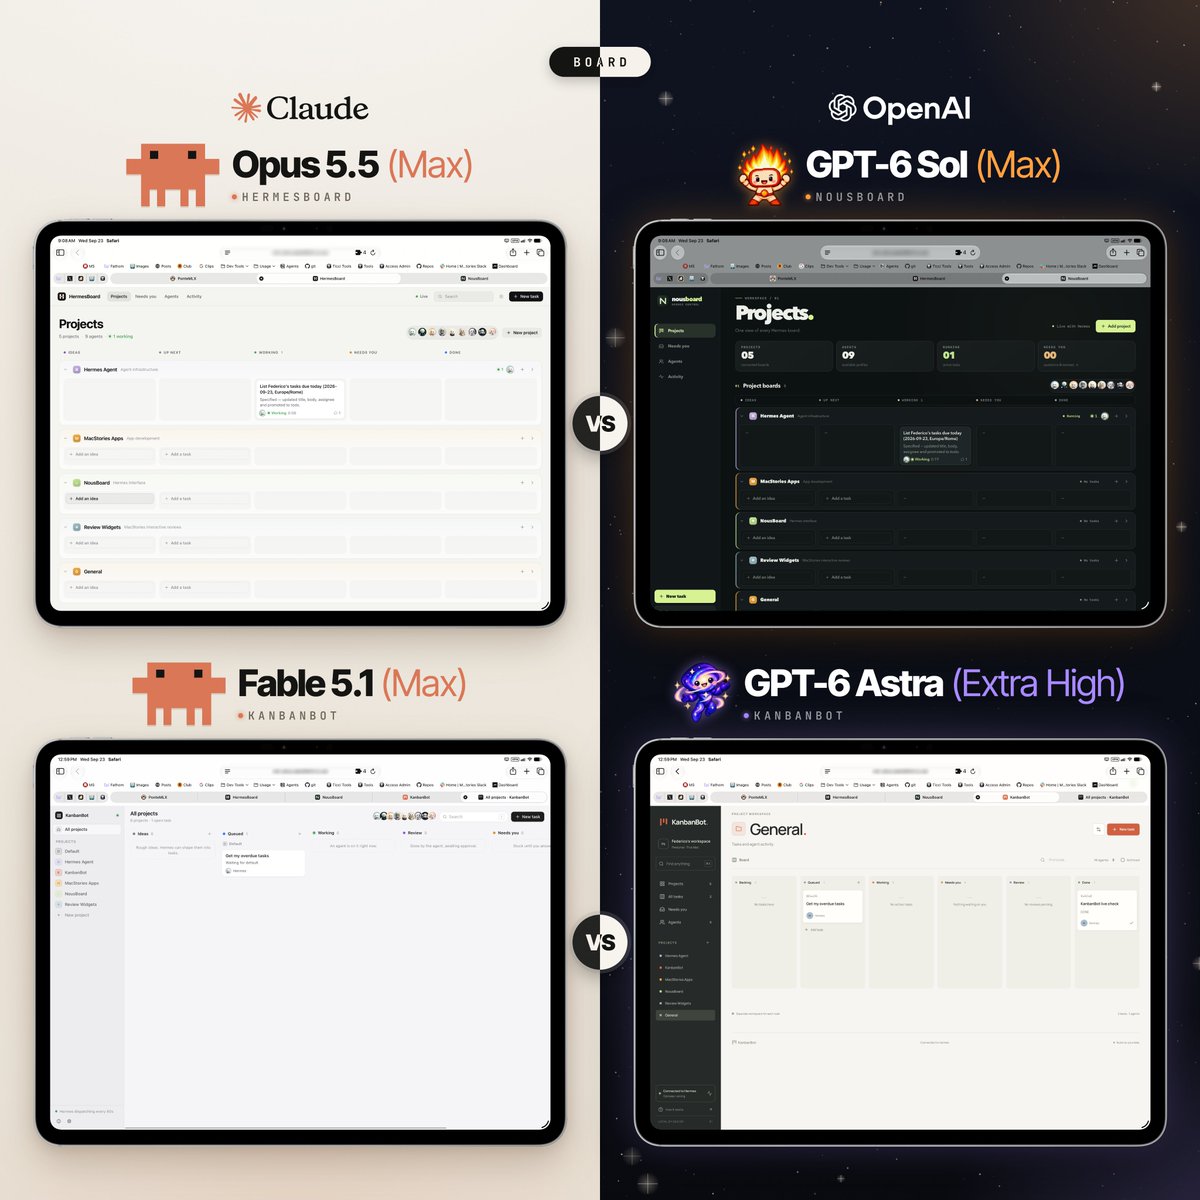 案例 38评测
作者以同一提示词比较四款模型的 Hermes Agent 看板界面,并将 Sol 排在最后。
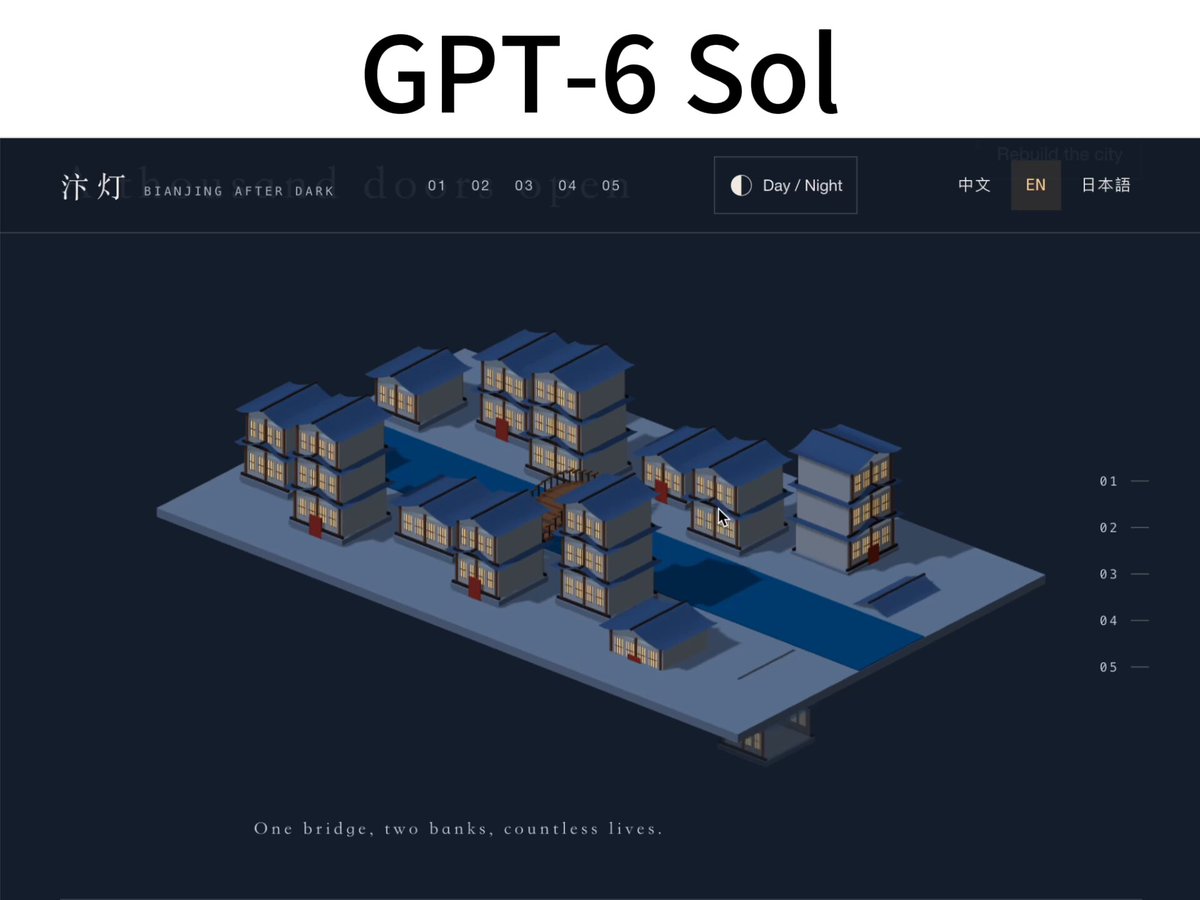 案例 39评测
OpenDesign 以同题比较 Sol 与 Opus 5.5,称两者风格不同;完整评测尚未发布。
 案例 40基准测试
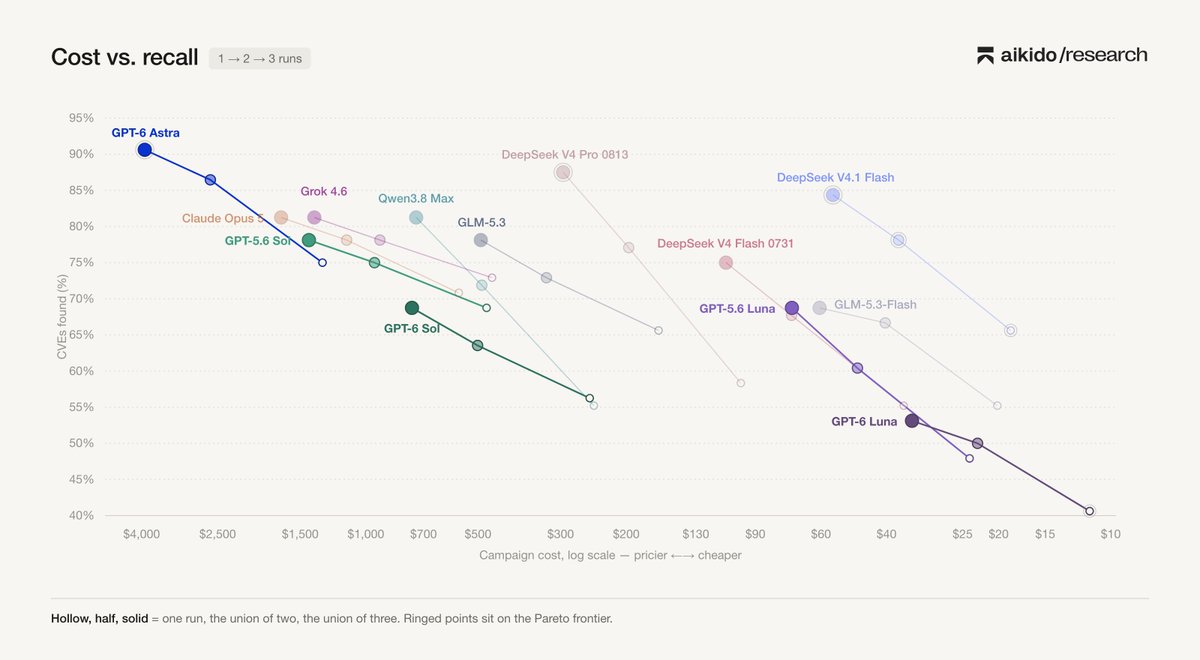
发布者的 32-CVE 评测报告 Sol 召回率 68.8%、Luna 53.1%;两者低于各自 5.6 版本。
 案例 41限制
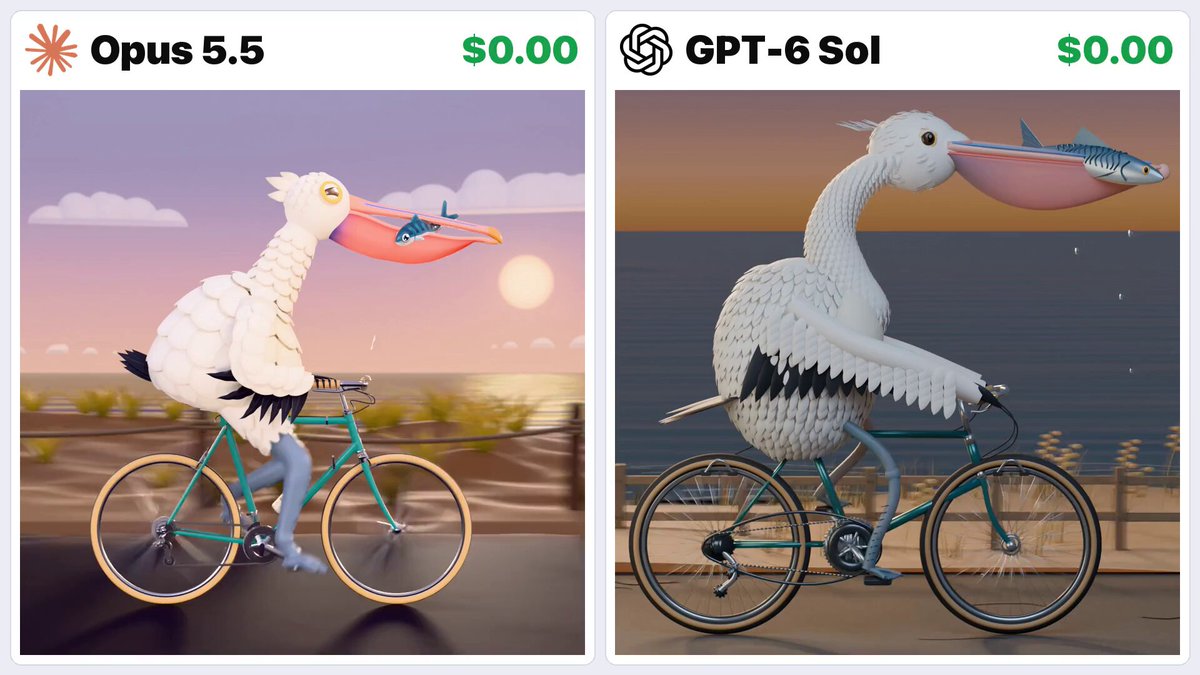
同题测试中,作者称 Sol 更快且较便宜,但绑定和几何质量存在明显问题。
 案例 42基准测试
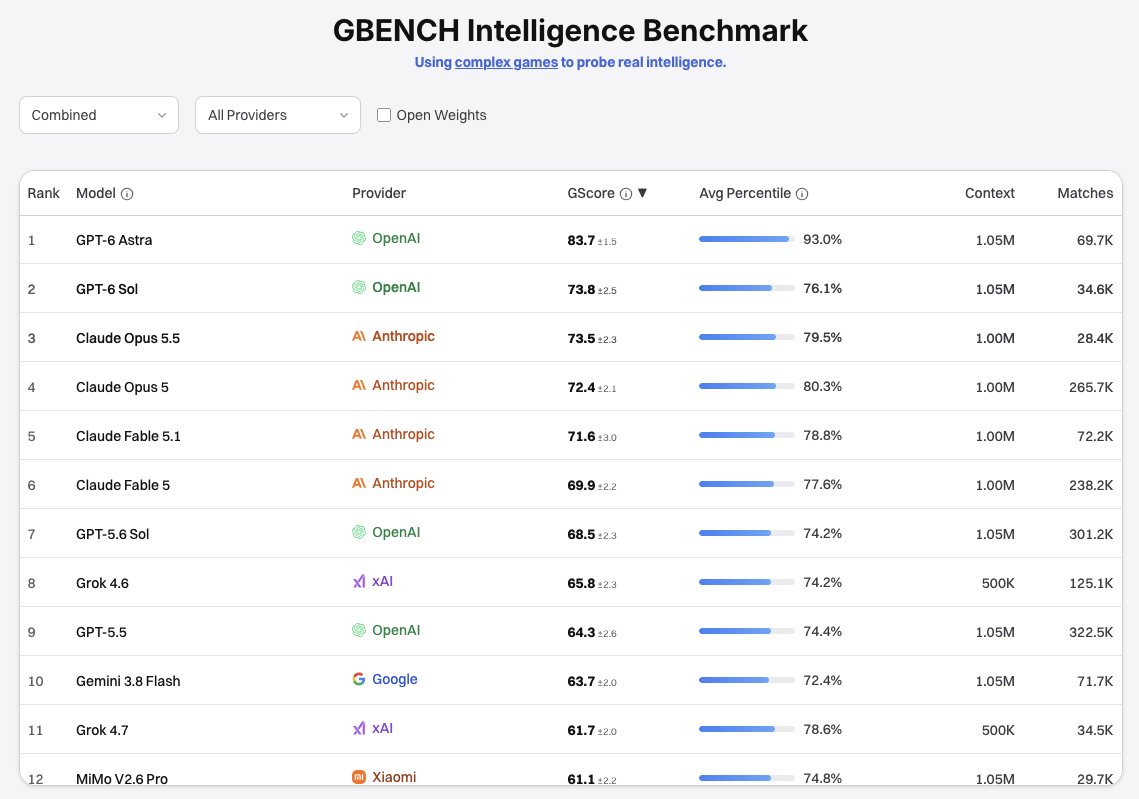
GertLabs 自测称 Sol 与 Opus 5.5 差距在误差内、Luna 略好于 5.6 Luna;结果依赖其 harness。
 案例 43演示
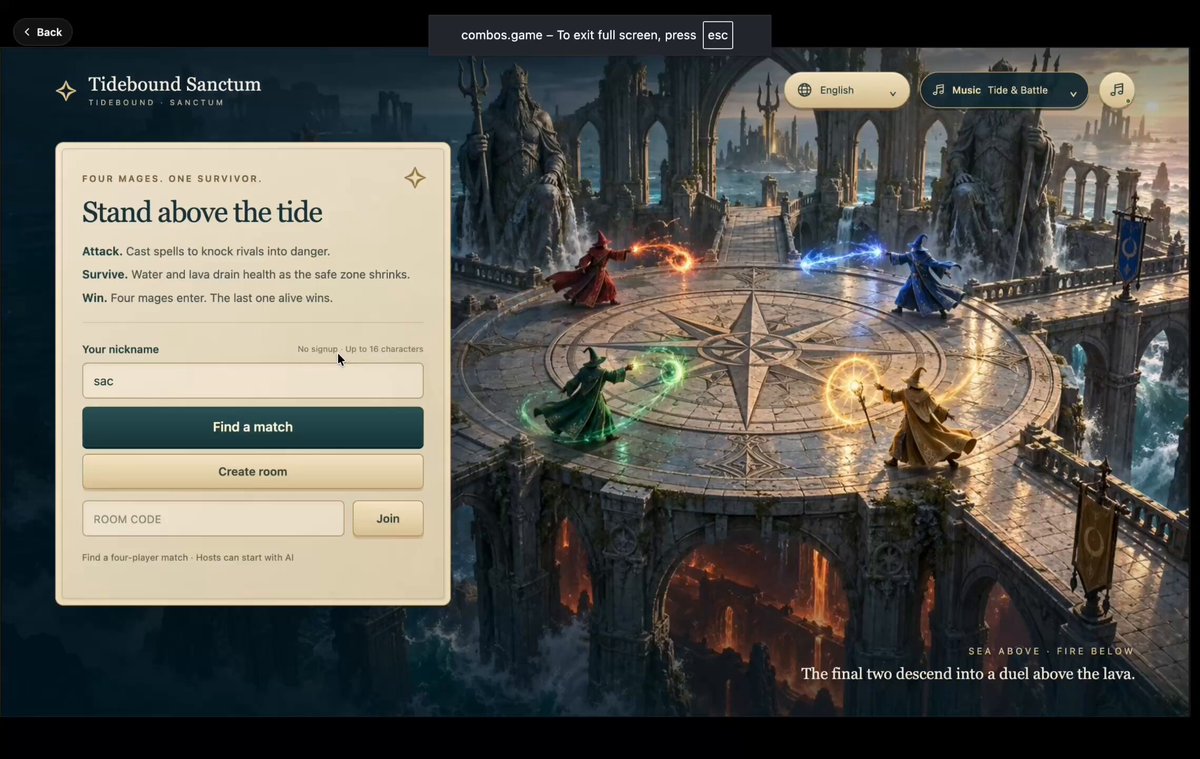
作者用 Astra 规划、Sol 编码;3D 素材、音效、联机和发布由 Combos CLI 及其他模型协作。
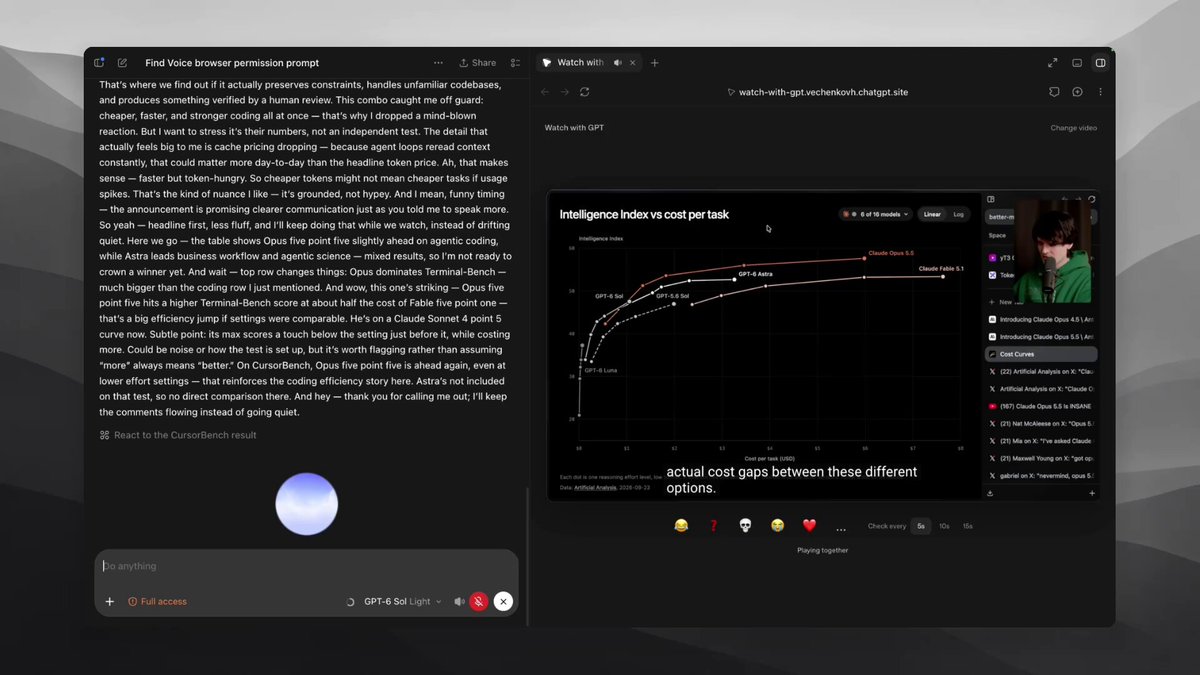 案例 44演示
作者用 ChatGPT Voice 与 WebMCP 做同步观看站点,演示 Sol 随视频播放给出评论。
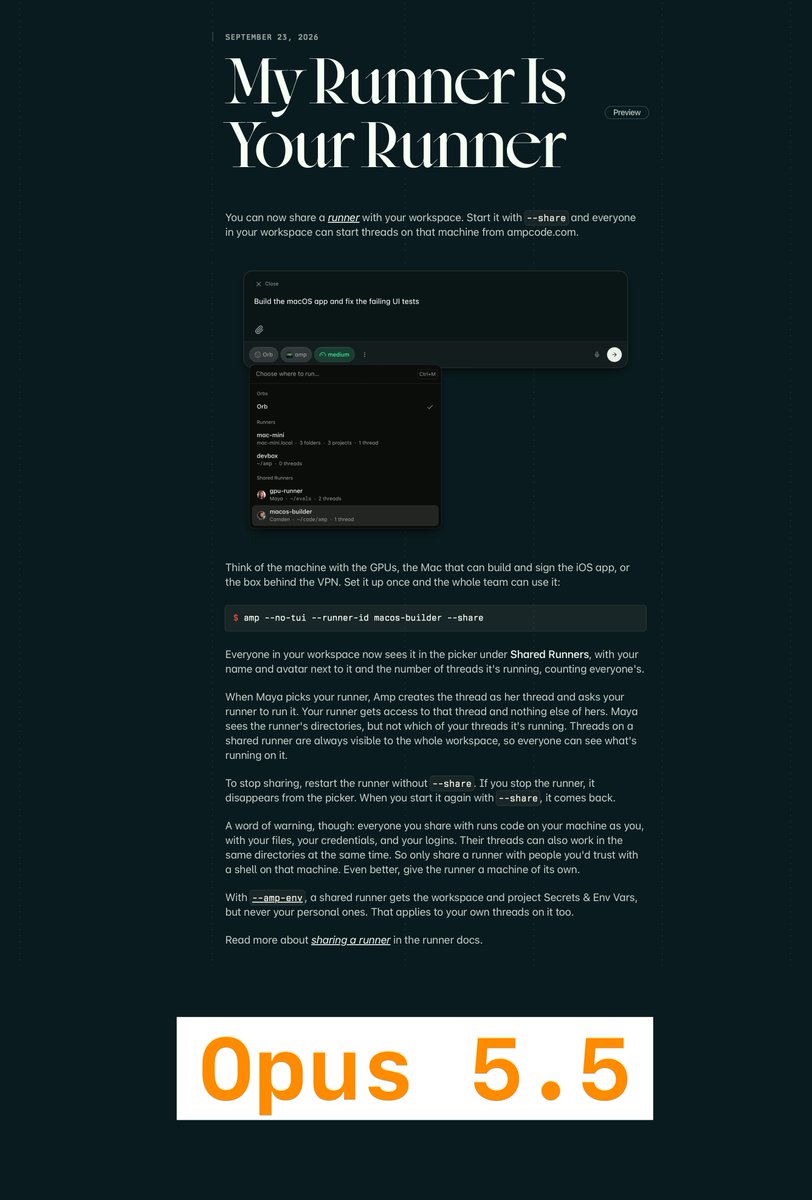 案例 45评测
同题要求写产品更新并配界面截图;作者估算 Sol 成本 3.10 美元,主观更偏好其他结果。
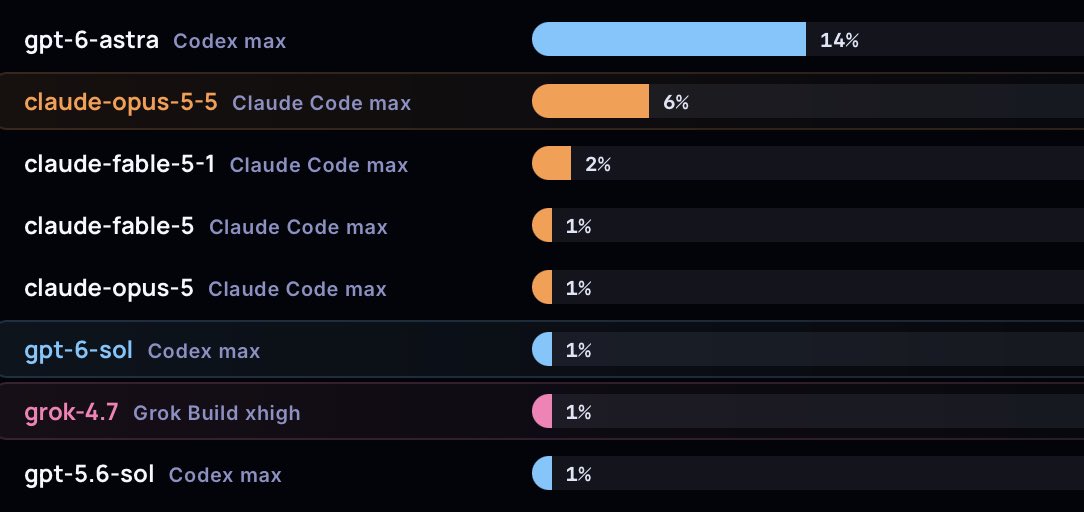 案例 46基准测试
MazeBench 报告 Sol 在其高难空间任务中得分 1%;不代表全部推理任务。
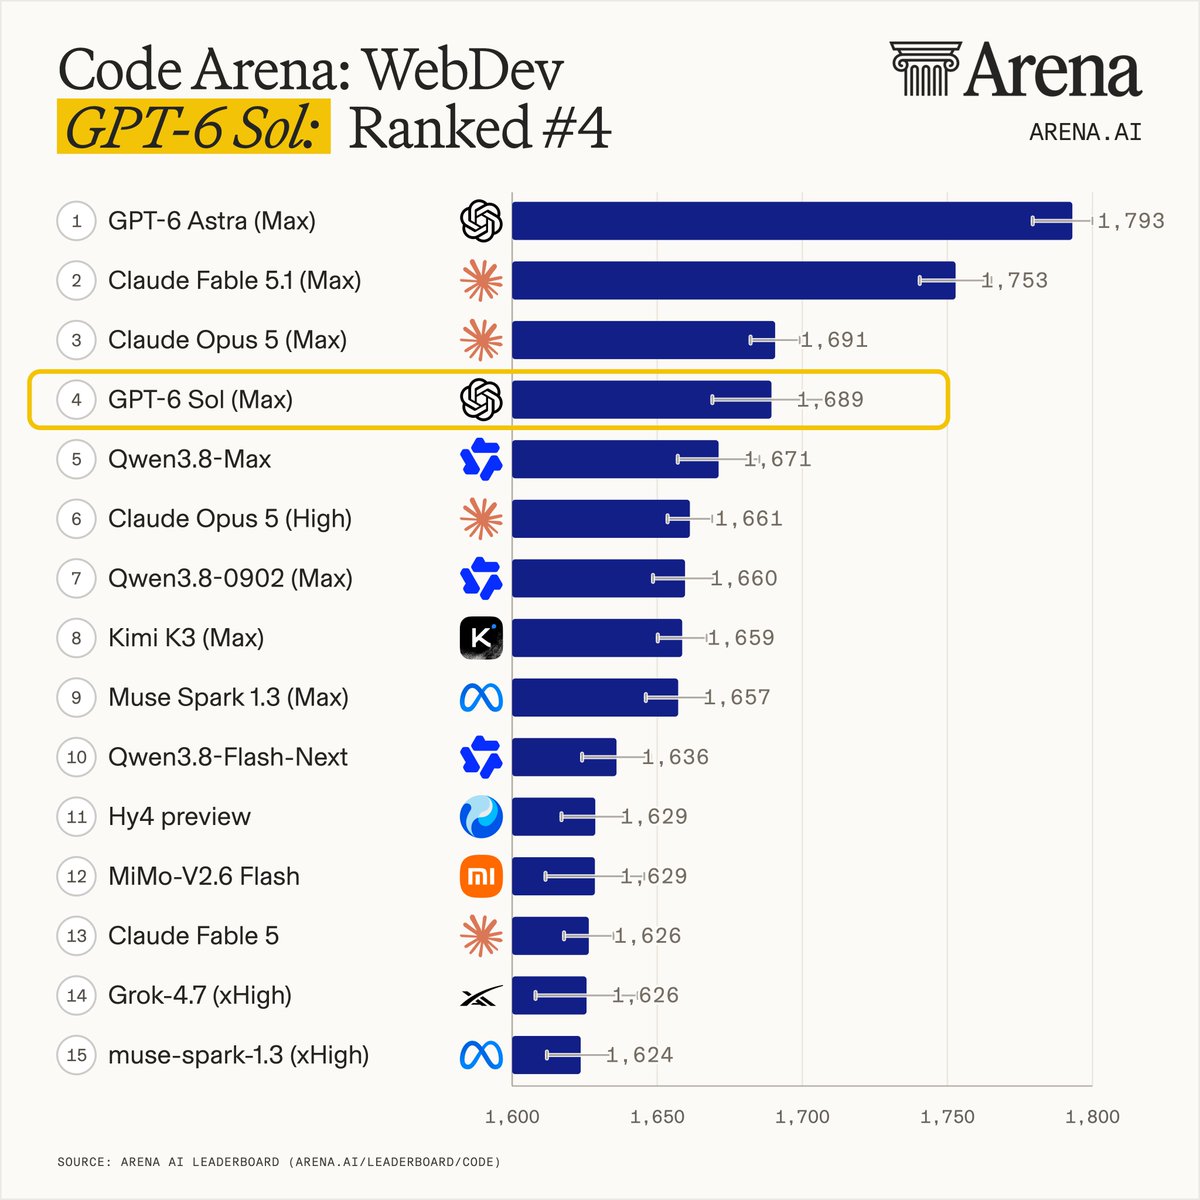 案例 47基准测试
Arena 报告 Sol Max 在 WebDev 排名第四;分数由该平台任务和投票决定。
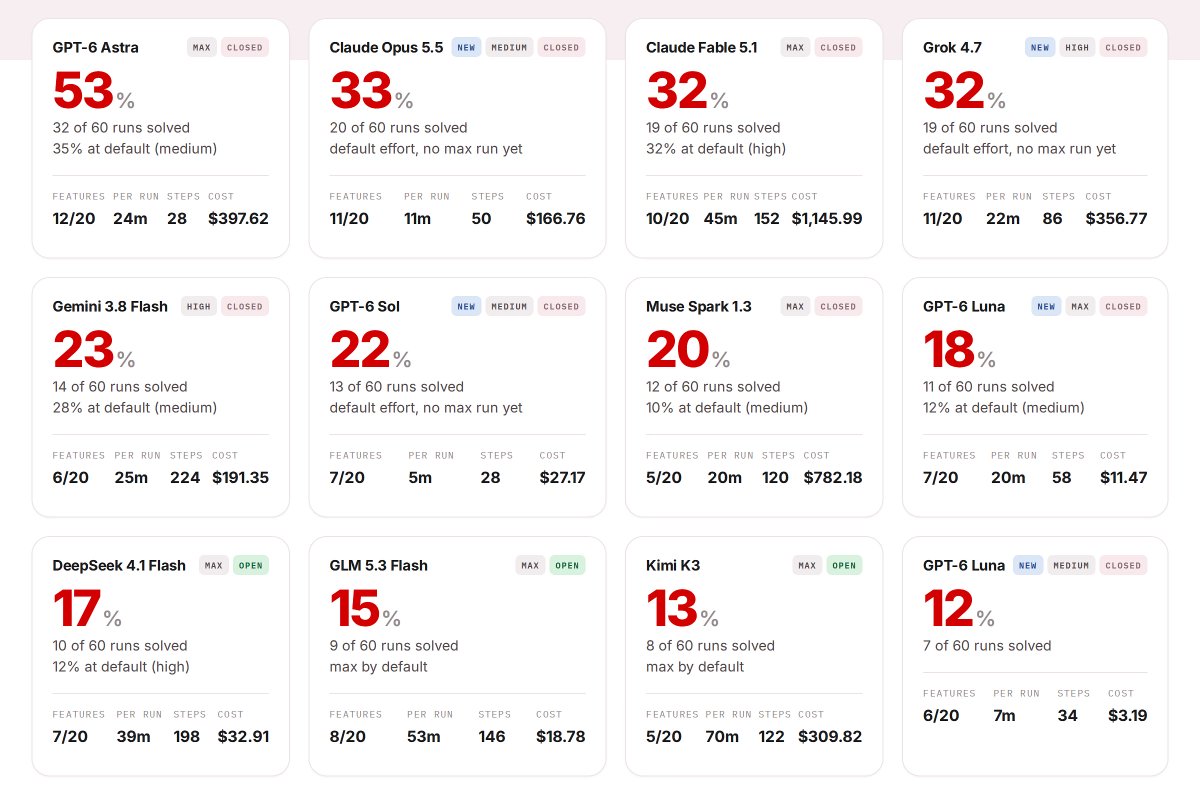 案例 48基准测试
Rails Agent 评测报告 Luna Max 完成率 18%、花费 11 美元,并与 Sol 同图比较。
当前显示 48 / 58
BUILD WITH EVOLINK / 04
在 EvoLink 模型目录确认当前可用型号与接入方式,再用自己的任务验证案例。