
Seedance 2.5 在即梦上了快一周了,效果到底有多好,你看看这三个完全不同的demo就知道了
最接近商业广告成片的产品呈现 https://x.com/Hss1128_/status/2083509466725802172
无法分辨真假的Vlog视频,甚至长达1分钟 https://x.com/sulfurscales/status/2084256472322781622
动漫角色一致性和风格及其稳定,在多个镜头中保持住了角色和复古动漫质感 https://x.com/jboogx_creative/status/2084581050991448160
TVC、Vlog、动漫,这些原本需要不同制作流程的内容,现在都可以从 Seedance 2.5 里直接得到相当高的完成度。但效果越好,另一个问题就越现实: 贵啊!!!
按照当前使用成本估算,一条 30 秒 720p 视频大约需要 15 美元,折合人民币接近 100 元! 如果一次生成就能得到可用结果,这笔钱并不离谱,真正烧钱的是 Prompt 没有写清楚啊~
人物和画面都很好,但镜头节奏不对,不能用;动作完成了,但角色中途变脸、换装或多出一个人,不能用;上传了多张参考图,但模型不知道哪张图负责人物、哪张负责产品、哪张负责环境,还是不能用!
一次失败就是接近 100 元,哪怕是高糊480p也得50喔?!
接下来悦己想分享的 Seedance 2.5 的 Prompt 指南不是那种“告诉你多写几个电影感、8K、运镜流畅之类的词”,因为用户真正需要解决的是,怎样让模型在生成之前就理解这条视频要做什么、哪些地方必须保持稳定、每个动作什么时候发生、镜头最后停在哪里
为了回答这个问题,悦己整理了接近 200 条公开的 Seedance 2.5 Prompt,提示词仓库 大家可以看看这个 https://evolink.ai/seedance-2-5-prompts?utm_source=twitter&utm_medium=articel&utm_campaign=seedance25
拆解了互动量 Top 50 的具体写法以后发现,值得复制的不是某一条写得特别长的 Prompt,而是一套可以反复使用的组合公式
Seedance 2.5 Prompt = 1 种表达结构 + 任务必需的控制策略 + 明确的内容题材
表达结构:决定模型按照什么顺序理解信息 控制策略:决定人物、素材、时间、摄影机、动作、声音和风格中,哪些部分可以自由发挥,哪些部分不能出错 内容题材:模型最后要交付的是 Vlog、TVC、动漫、纪录片、MV,还是一段动作电影
这套公式带来的效果不是让 Prompt 看起来更专业,而是减少信息冲突,让模型先抓住成片目标,再执行最重要的控制要求。
话不多说,开整!
一、得选对 Prompt 的表达结构
表达结构就是信息进入模型的顺序,同一个创意可以只写一句核心概念,也可以写成故事、制作规格书或逐秒分镜,结构选得不对,细节越多反而越容易互相冲突
从实际创作出发,常用结构可以整理成 6 种,没有哪一种永远最好,关键是根据成片目标、控制精度和制作方式选择最合适的一种
1 极简概念句:用最少变量保留模型的导演空间
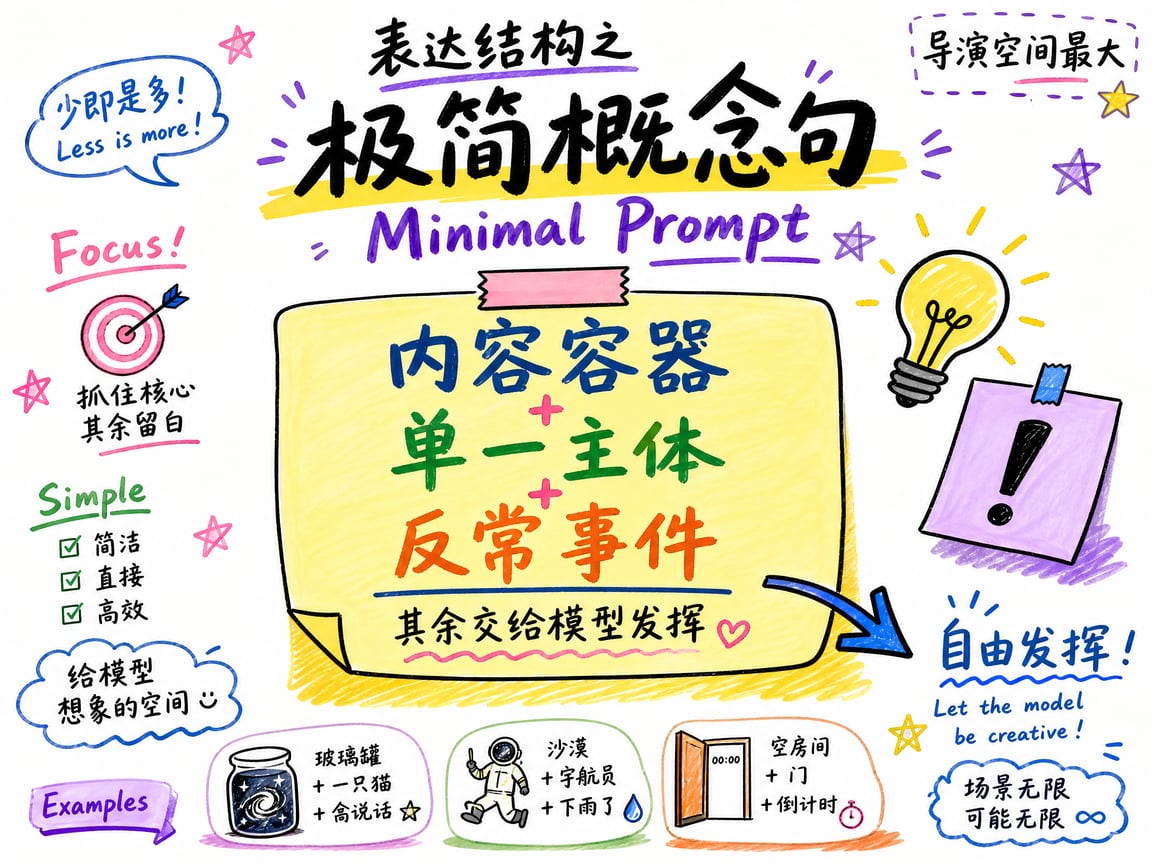
只给模型一个清晰的内容容器、核心主体和反常事件,把镜头、动作和视听细节交给模型发挥,适合概念本身就足够强的内容
熟悉的内容容器 + 单一主体 + 反常事件或关系 + 明确的情绪或结果 + 最多两个必要限制
比如,这个case只保留影片类型和连接、社区这组核心主题,让模型承担绝大部分叙事与视听决策,最终生成了一段完整长视频
https://x.com/arikuschnir/status/2083209950231220403
2 连续自然语言叙事:让动作沿着因果关系自然推进
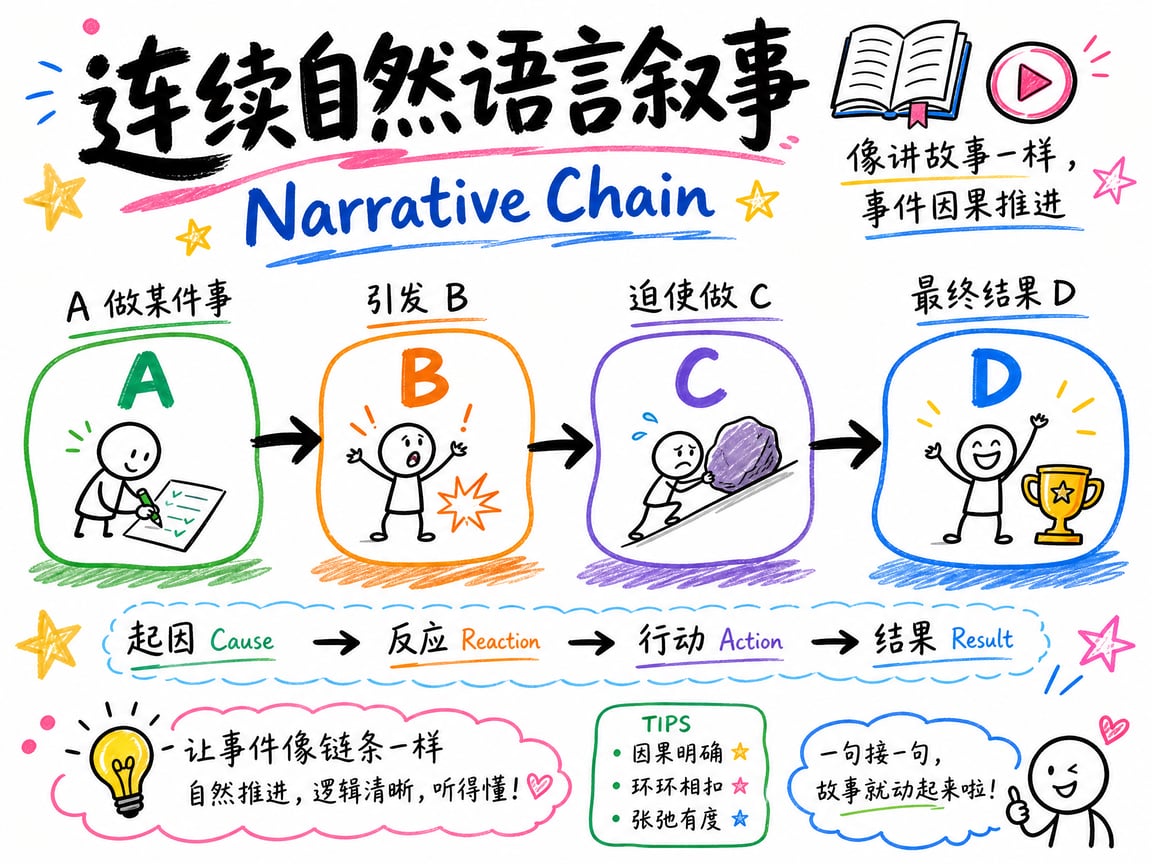
像讲故事一样写清人物从什么状态开始、发生了什么、怎样反应、最后走向什么结果,不强制模型逐镜头执行,但要求事件之间有明确因果
媒介质感 + 主体与环境 + 平静起点 + 触发事件 + 递进动作链 + 结尾回收 + 必要限制
动作链可以进一步简化为:
主体做 A → A 引发 B → B 迫使主体做 C → C 造成最终结果 D
这个案例用连续叙事组织一段洗衣 Vlog,七个生活动作都围绕同一个任务推进,手机录像质感、韩语对白和环境声共同维持日常感
https://x.com/doctorwasif/status/2083779989414019109
3 模块化制作规格书:让人物、摄影、场景和声音各归其位
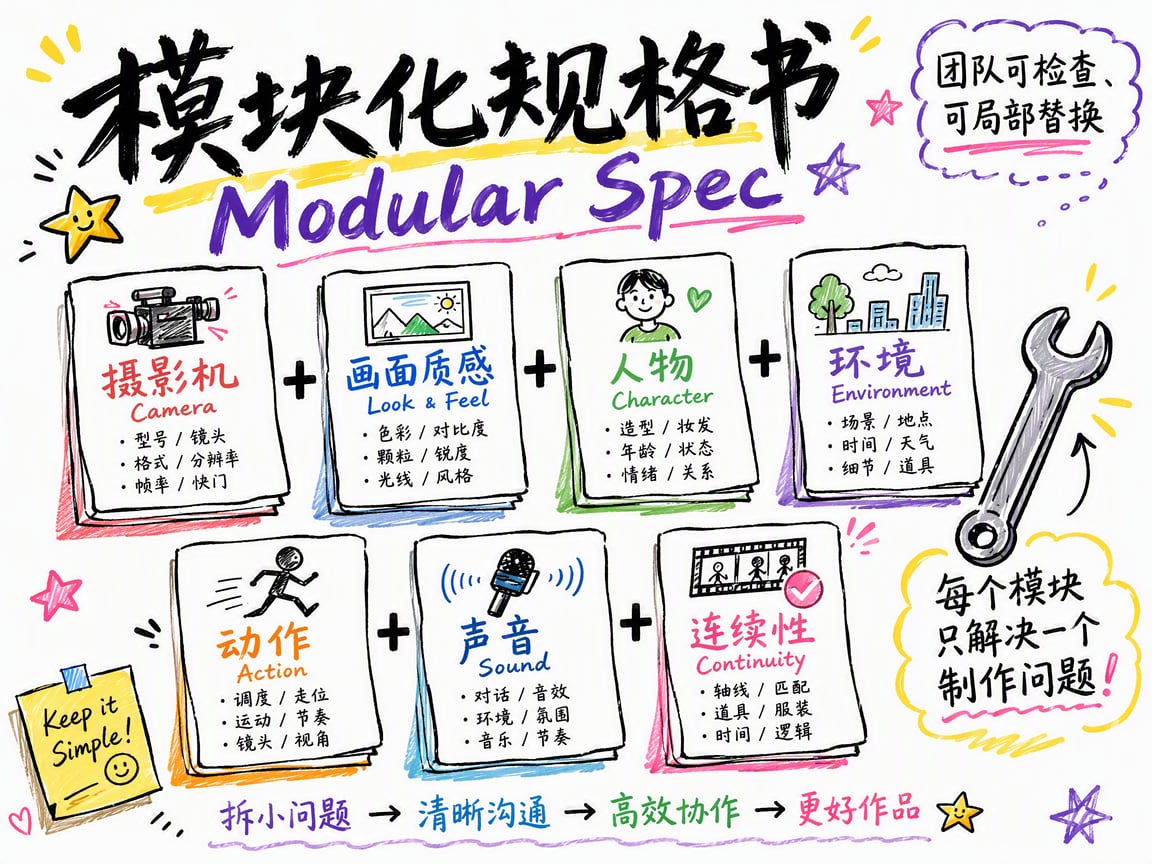
把 Prompt 拆成摄影、风格、人物、环境、动作、声音和连续性等模块,每个模块只解决一个制作问题,方便团队检查和局部替换
成片规格 + 摄影机 + 画面质感 + 主体 + 环境 + 动作 + 声音 + 连续性 + 负向约束
这个压花 ASMR Vlog 把摄影机、人物、环境、声音和真实感分别写进不同模块,并用手抖、失焦和曝光变化建立真实的家用摄像机效果
https://x.com/strength04_x/status/2084269139556761919
4 时间轴逐镜头分镜:让关键事件在正确的时间发生
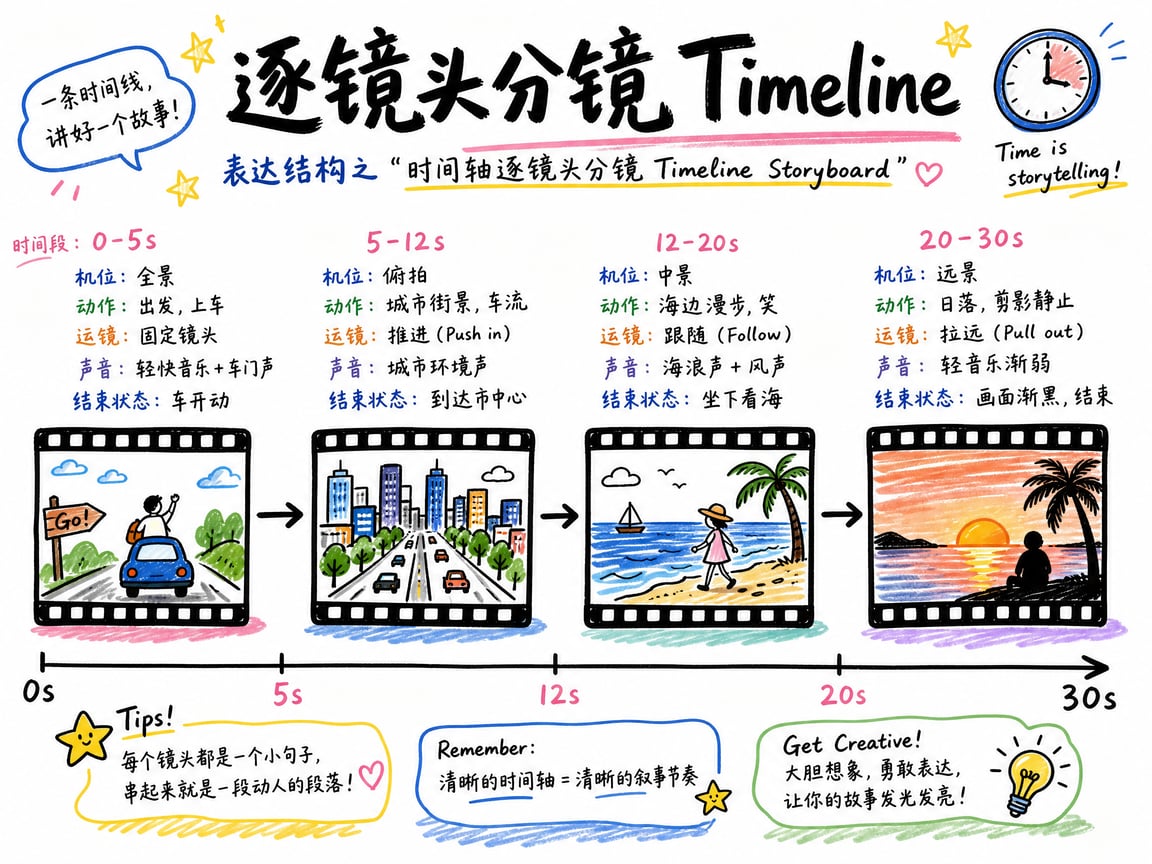
把总时长拆成连续时间段,每一段只规定一个主要动作,同时写清机位、摄影机运动、声音和结束状态,适合必须在规定时间完成的多镜头内容
全局规格 + 主体锁定 + 时间轴镜头单元 × N + 跨镜连续性 + 全局负向约束
单个镜头单元可以直接套用:
时间段 + 景别与机位 + 主体动作 + 摄影机运动 + 声音或对白 + 本镜头结束状态
这个旅行 Vlog 把 30 秒拆成出发、城市探索、抵达海边、朋友社交和日落收尾,让地点、动作和情绪沿着时间持续升级
https://x.com/bubblebrain/status/2083659648108990925
5 一镜到底与路径叙事:让摄影机运动本身成为故事
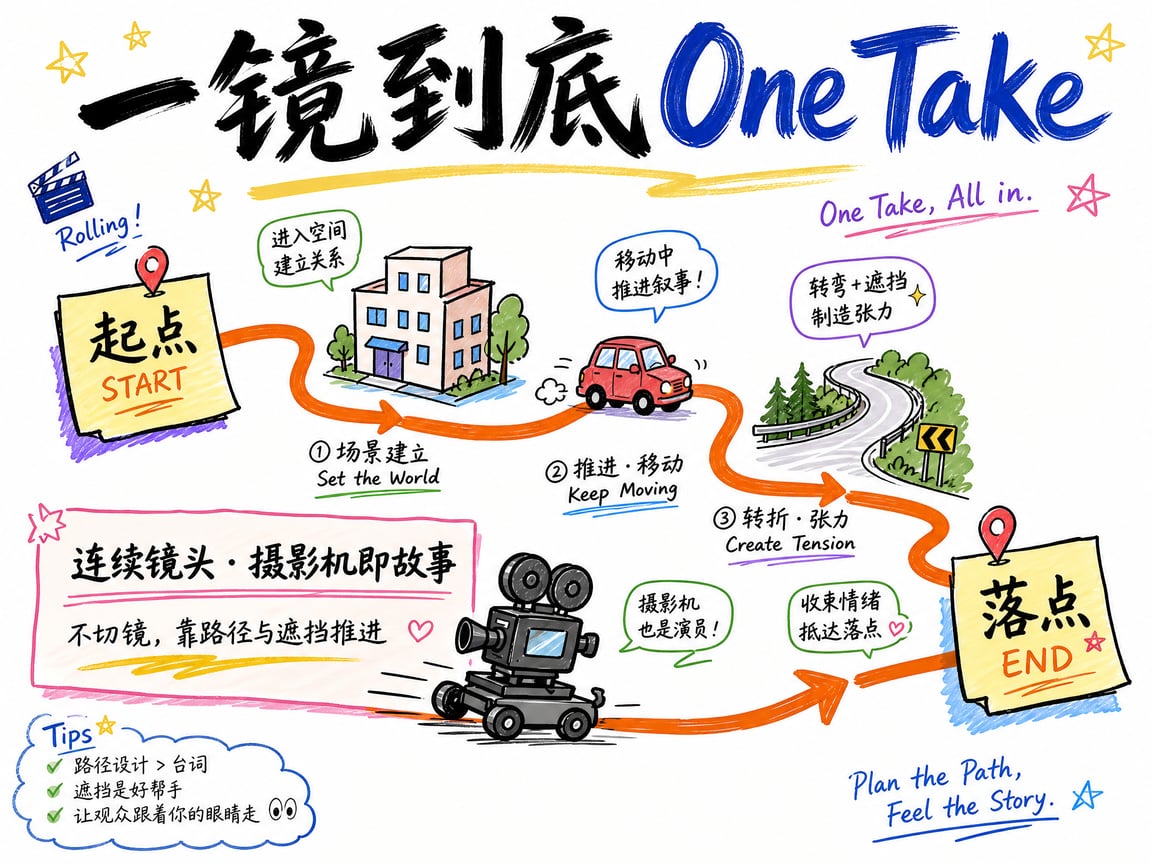
不依靠剪辑切换场景,而是用摄影机经过的空间、遮挡物和路径节点推动故事,适合追逐、穿越和连续空间奇观
连续镜头声明 + 摄影机起点 + 路径节点 × N + 物理过渡 + 主体锚点 + 最终落点 + 禁止切镜
单个路径节点可以这样写:
摄影机从哪里出发 + 怎样移动 + 穿过或绕过什么 + 主体位于哪里 + 如何进入下一空间
这个案例先锁定刺客、目标、车辆和东京环境,再让摄影机沿着连续追逐路线穿过不同空间,利用遮挡保持运动和方向连续
https://x.com/victorinfocus/status/2084074611751186713
6 结构化数据模板:让 Prompt 可以被批量生成和检查
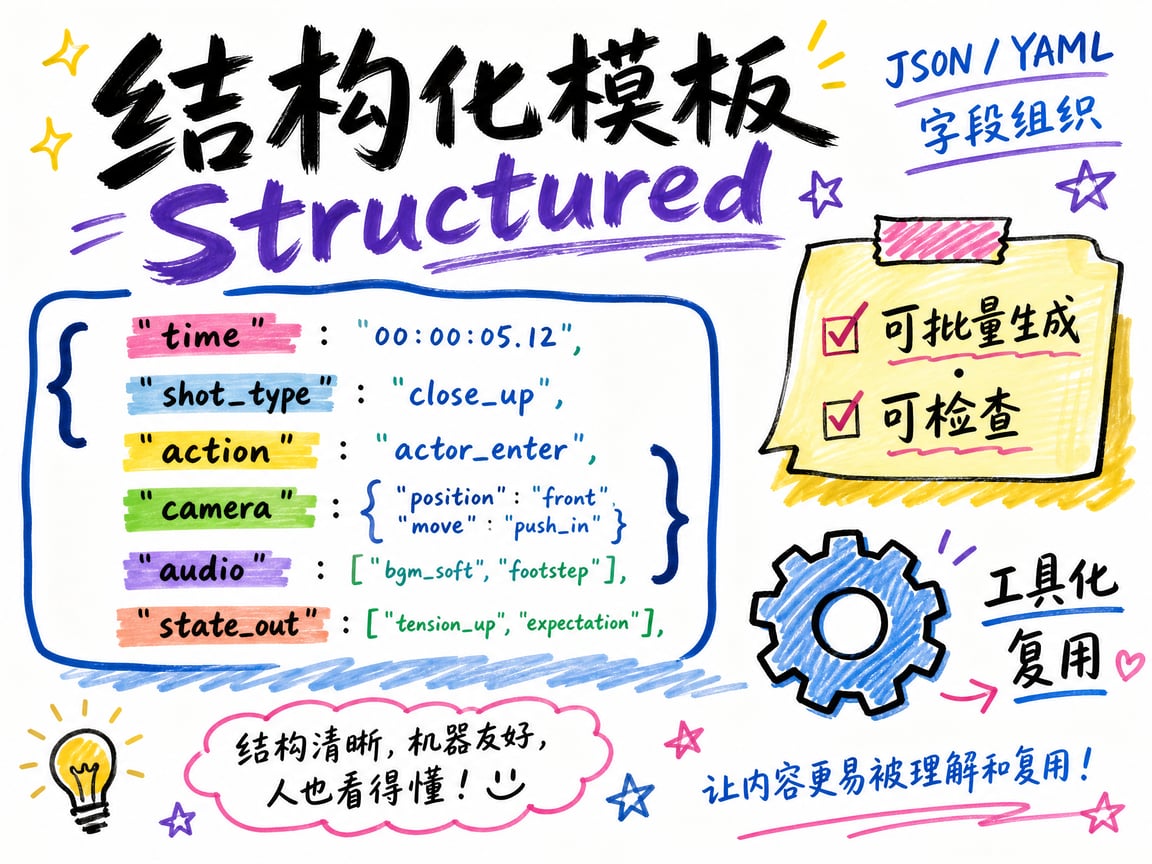
用 JSON、YAML 或固定字段组织全局风格、参考素材、角色和镜头,主要价值是方便程序生成、翻译、验证和批量复用,不代表画面会自动变好
元数据 + 全局风格 + 实体与参考表 + 镜头数组 + 声音层 + 连续性约束 + 负向约束
每个镜头对象可以统一为:
time + shot_type + subject + action + camera + audio + state_out
这个案例用结构化字段拆分标题、风格和镜头,每个镜头分别记录时间、动作、摄影机与对白,效果是更容易被工具读取和重复修改
https://x.com/sebatheepan/status/2084023216440246455
二、控制策略:搞定最容易失败的部分
控制策略则决定模型的哪些自由度必须被收紧,简单来说,表达结构管怎么说,控制策略管哪里不能出错
从这批 Prompt 里可以归纳出 8 类控制策略:
- 素材映射,负责划分每张参考图的职责
- 身份连续性,负责稳定人物和产品
- 时间节奏,负责安排事件发生的先后
- 摄影机空间,负责机位路径和最终落点
- 动作物理,负责接触受力和结果
- 声音口型,负责对白与声音同步
- 媒介质感,负责视频看起来由什么设备和制作体系拍摄
- 负向约束,负责封堵最可能让成片报废的问题
这 8 种策略不需要全部写进同一条 Prompt,角色或产品广告通常更依赖素材映射、身份连续性和负向约束,动作场景更依赖时间节奏、摄影机空间和动作物理,Vlog 则更依赖媒介质感与声音控制,先判断这次生成最容易在哪里失败,再组合真正需要的策略
素材映射:让每张参考图只负责一件事
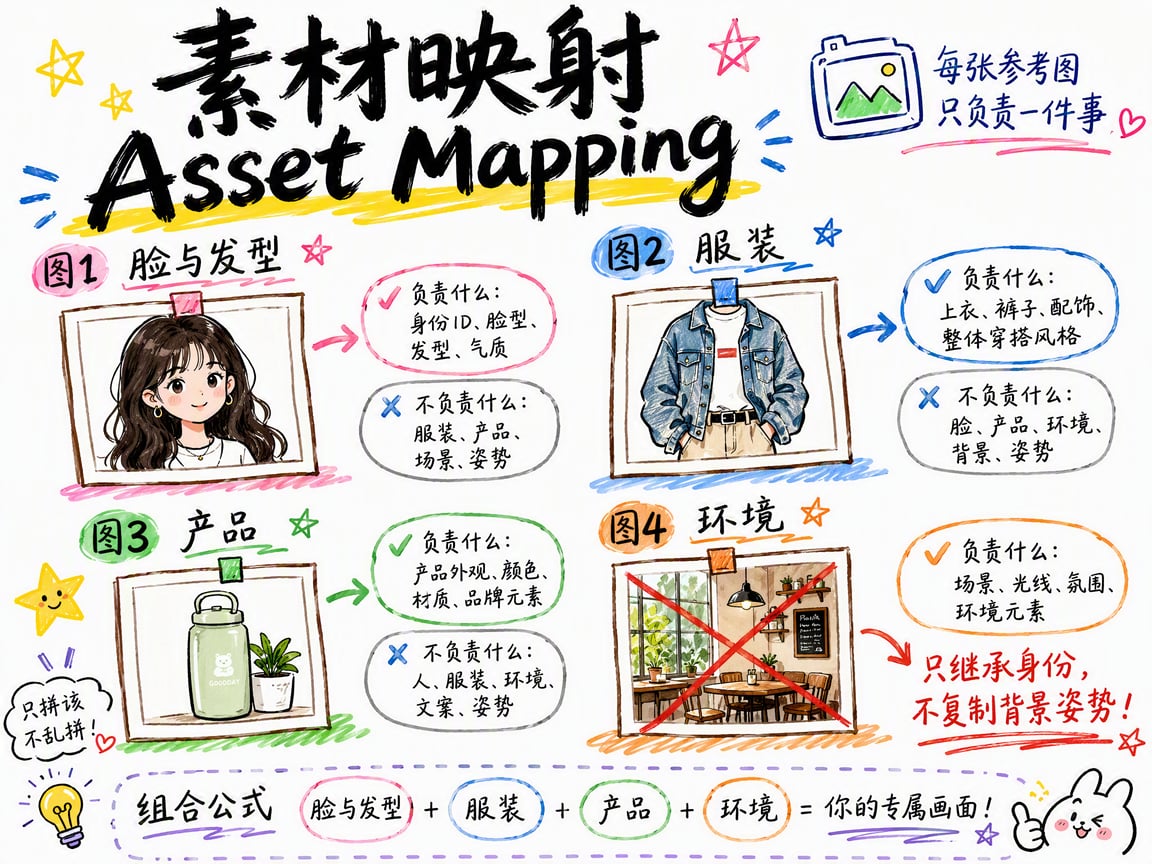
素材映射解决的不是有没有上传参考图,而是模型应该从每张图里继承什么,人物、服装、产品、环境和动作必须各自有清楚的职责边界
素材 ID + 负责什么 + 不负责什么 + 必须继承的属性 + 忽略的属性 + 冲突优先级
洗衣 Vlog 只让 Image1 提供人物的脸和发型,不允许模型复制参考图的背景、姿势和构图
https://x.com/doctorwasif/status/2083779989414019109
Prompt 中真正起作用的是这两句:
A woman (use Image1 only for facial identity and hairstyle) does laundry alone on a quiet morning Do not recreate or copy the reference image—use it only for facial identity and hairstyle
第一句规定 Image1 负责什么,第二句规定它不负责什么,模型因此可以继承人物身份,同时重新生成洗衣房、服装和动作
身份连续性:让人物、服装、产品和道具保持稳定
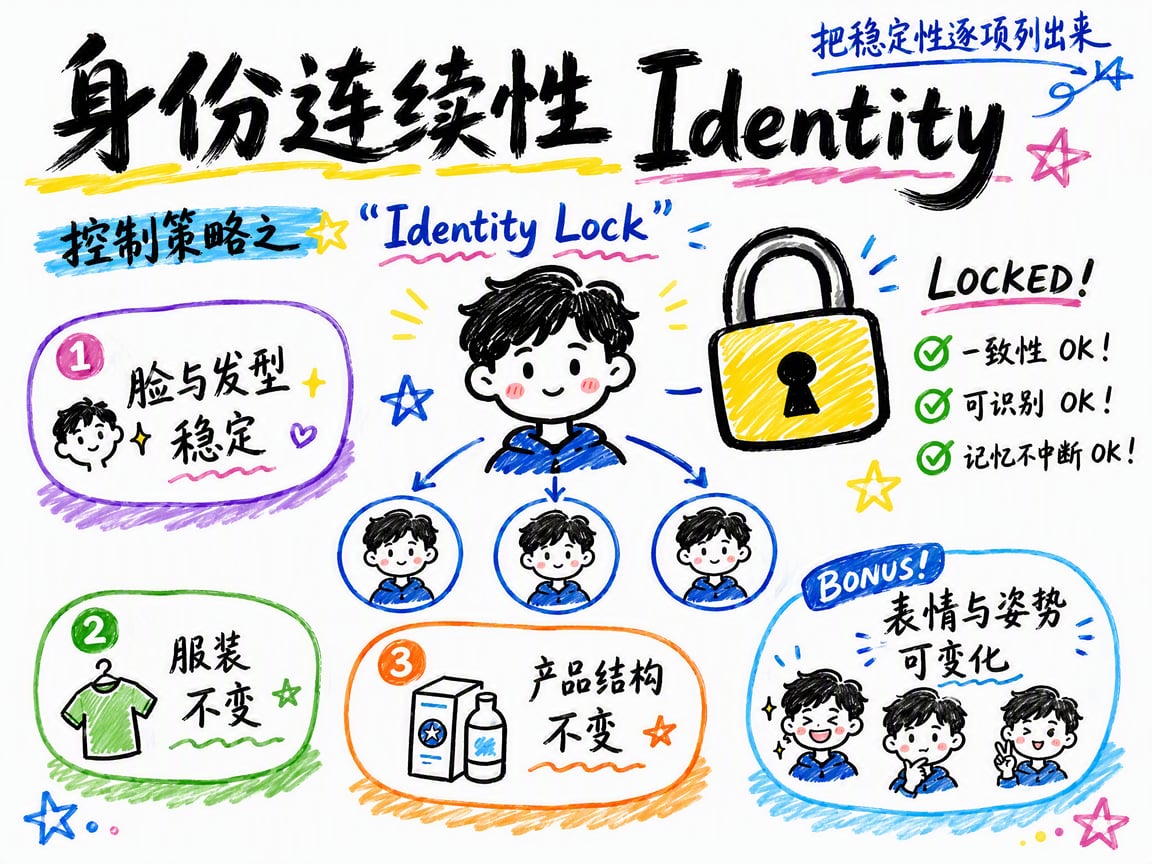
身份连续性需要先区分哪些属性必须锁定,哪些属性可以自然变化,脸、发型、体型、服装和产品结构可以保持稳定,表情、姿势、布料和光影则需要保留运动空间
实体 ID + 锁定属性 + 允许变化属性 + 每段进入状态 + 每段结束状态 + 数量约束
这条奢侈品太阳镜 UGC 同时锁定人物和产品,人物在卧室、镜子和产品特写之间移动,但脸、穿搭以及太阳镜的结构不能改变
https://x.com/aiwithkhan/status/2084608509837275231
Prompt 没有只写保持一致,而是把需要稳定的属性逐项列了出来:
Preserve her facial identity, hairstyle, eye color, makeup, skin tone, body proportions, white sleeveless fitted top, light blue wide-leg jeans, pearl choker, rings, and bracelets consistently throughout the video Maintain perfect product consistency, including the frame shape, lenses, hinges, colors, materials, and proportions
这种写法的效果是把人物一致性和产品一致性拆成两条独立规则,避免模型保住了脸,却在不同镜头里改掉镜框、镜片或包装
时间节奏:让每段时间只完成一个主要目标
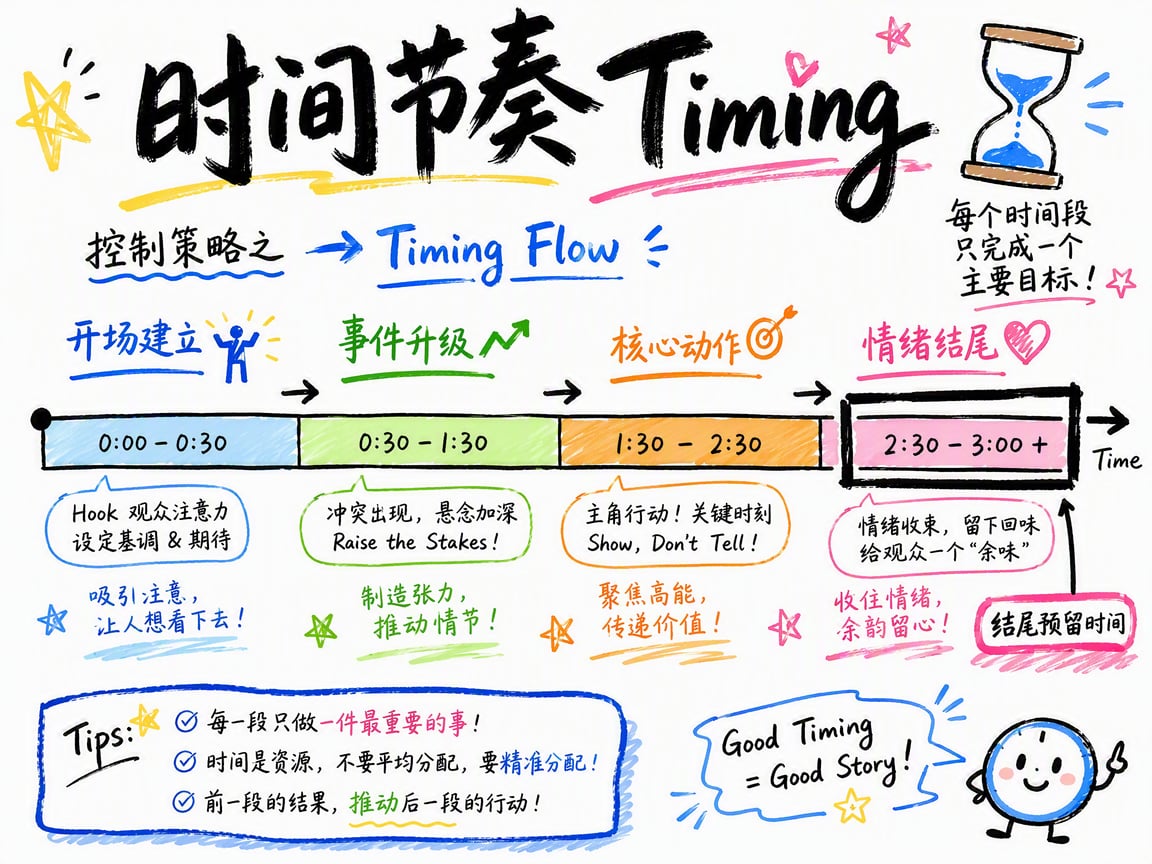
时间节奏不是把每一秒都写满,而是为开场、升级、核心动作和结尾分配足够时间,每个时间段只承担一个主要目标,后一段从前一段的结果继续
总时长 + 时间段 + 每段单一目标 + 段间触发关系 + 结尾预留时间
这条旅行 Vlog 把 30 秒拆成出发、城市探索、抵达海边、朋友社交和日落收尾,最后三秒不再增加新事件,只完成情绪回收
https://x.com/bubblebrain/status/2083659648108990925
开场与结尾在 Prompt 中被明确分开:
0-5s: Morning departure 27-30s: Ending moment. Golden hour sunset. She sits near the ocean, holding a drink, watching the sunset. The camera slowly moves backward
前五秒只建立一天的起点,最后三秒只负责结束,一条 30 秒视频因此不会在高潮后突然停止,也不会在结尾继续塞入新的地点和动作
摄影机空间:让镜头知道从哪里开始、怎样移动、停在哪里
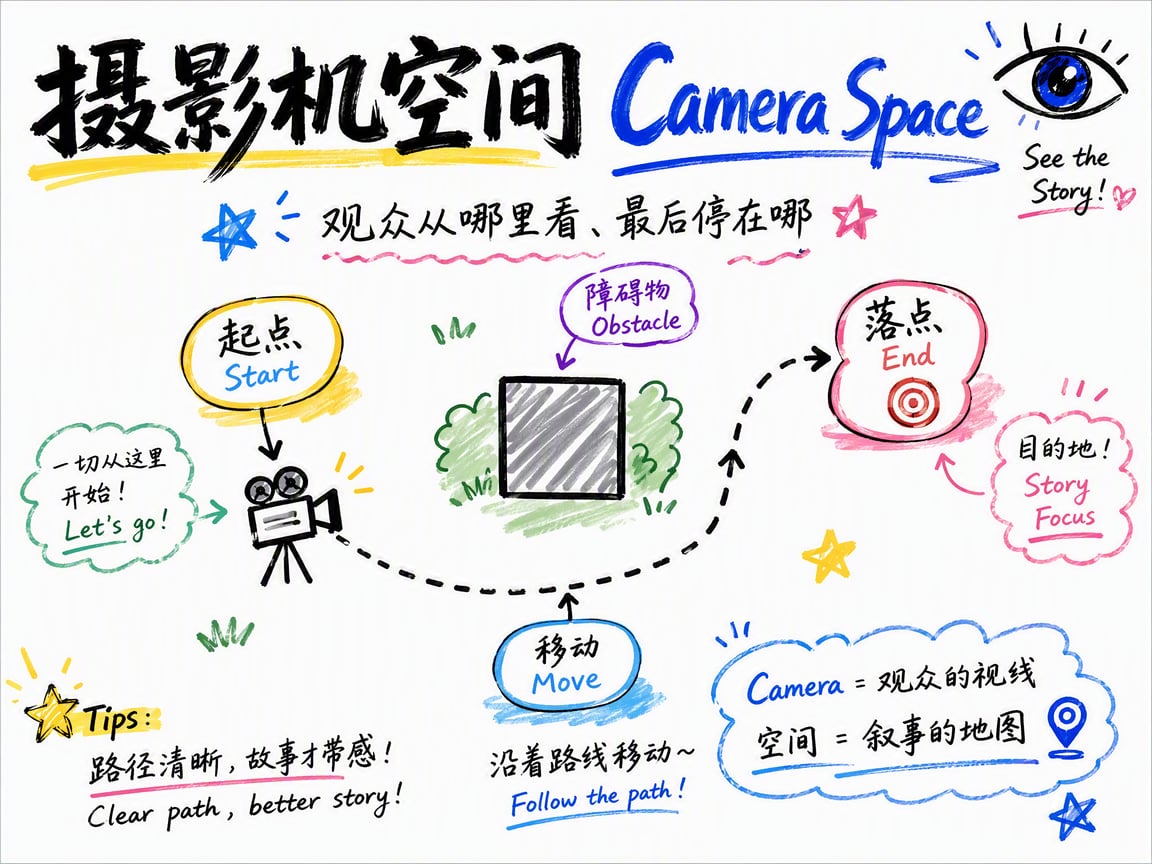
摄影机空间控制的是观众从哪里看、主体位于画面哪里、镜头如何穿过环境,以及最后停在什么构图,只有运镜名称,没有空间关系,模型依然不知道该往哪里走
摄影机起点 + 主体画面位置 + 单一主要运动 + 空间参照物 + 过渡方式 + 摄影机终点
这场东京追逐没有只写快速跟拍,而是让车辆不断超过摄影机,再让摄影机落后、被事故推开,最终转到刺客正面完成收尾
https://x.com/victorinfocus/status/2084074611751186713
其中两句分别规定了摄影机与主体的关系以及最终落点:
The camera is repeatedly overtaken by the vehicles, falls behind them, then is rushed past as the crash unfolds End with a front-facing tracking shot of the assassin riding toward the camera at speed just after regaining control
车辆、摄影机和道路不再是三个独立元素,它们在同一条运动轴线上持续改变距离,观众才能感受到速度、危险和最后重新获得控制的过程
动作物理:让接触、受力和动作结果真正连起来
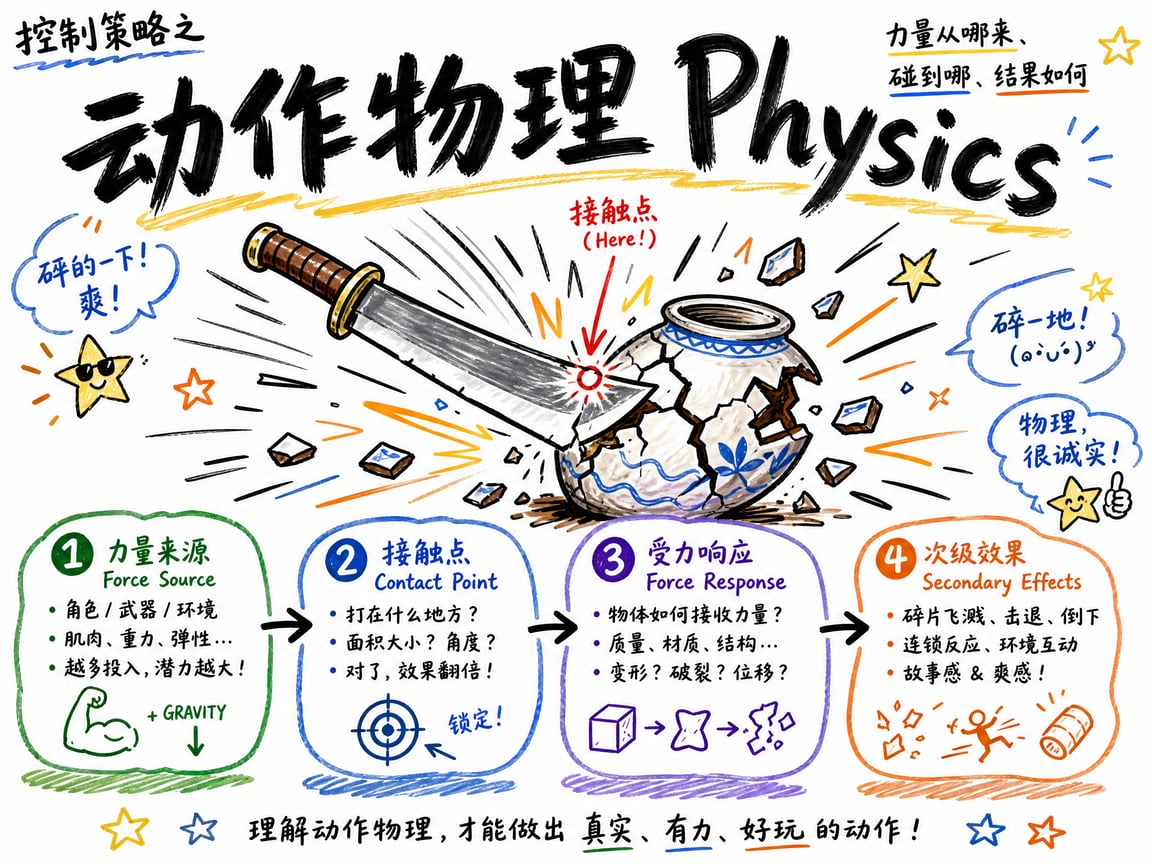
动作物理不能只写真实或有冲击力,需要说明力量从哪里来、接触什么位置、物体如何响应、产生什么次级效果,以及结果是否保留到下一步
初始状态 + 主动力 + 接触点 + 受力响应 + 次级物理效果 + 动作后的稳定结果
这条锻刀真人秀没有把测试写成大师砍碎陶瓷,而是逐步交代挥刀、命中、碎裂、飞散和刀刃进入物体后的状态
https://x.com/techhalla/status/2084018642300141851
Prompt 对第一次命中的描述是:
Master steps in, raises the machete. Hard cut to side angle as he delivers a powerful overhead chop into the first gnome Impact explodes in slow motion: ceramic shatters into sharp fragments, paint chips and dust fly outward. Time locks at peak penetration
力量来源、动作方向、接触对象、材料反应和最终状态都能被看见,模型不需要用无接触爆炸或随机碎片去猜什么叫有冲击力
声音口型:让对白、环境声和音乐找到各自的位置
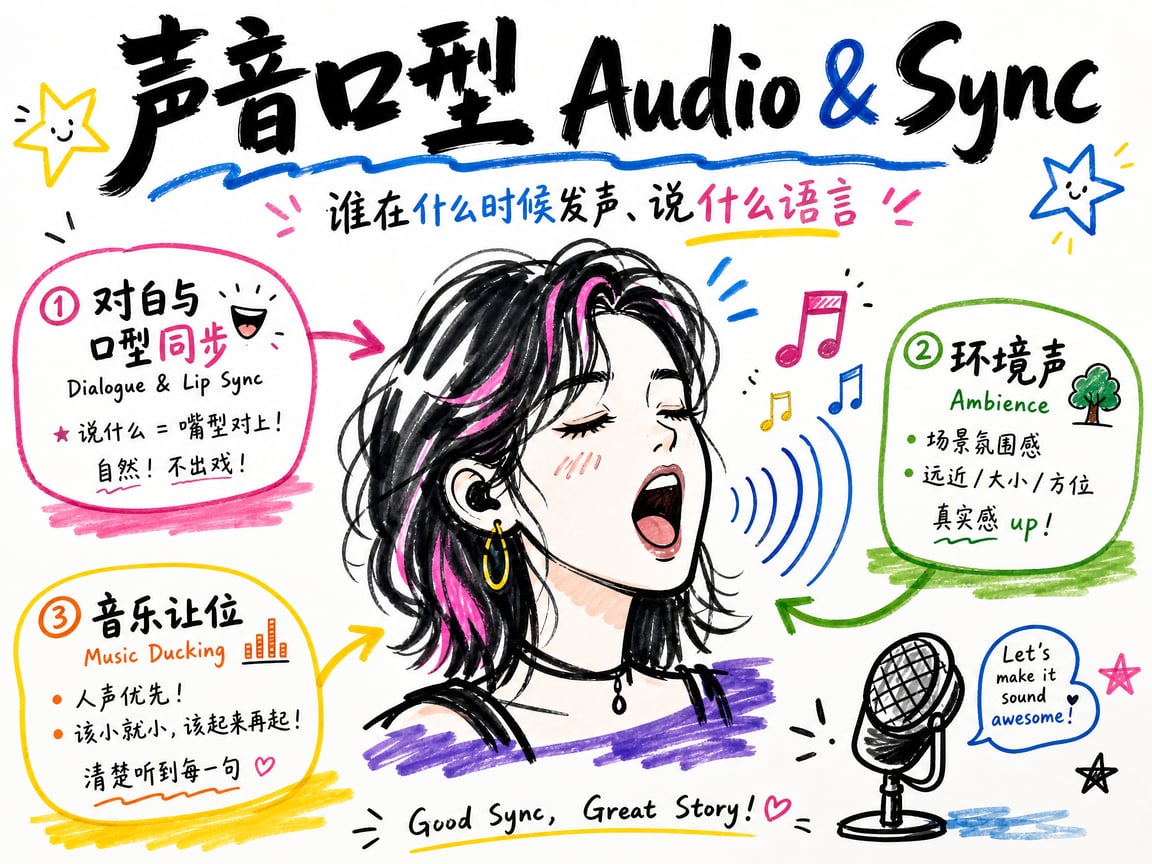
声音控制需要写清谁在什么时候发声、使用什么语言、口型跟随谁、背景里还有什么声音,以及音乐是否应该让位给对白和动作
声音来源 + 时间点 + 语言与内容 + 表演方式 + 同步对象 + 空间位置 + 背景声音
这条双歌手 Pop MV 让两名歌手在主歌和副歌中都保持演唱状态,只在器乐段落改为互动和编舞,避免角色嘴型、音乐段落和表演状态互相打架
https://x.com/zarairahh/status/2084992037313507340
Prompt 直接规定了演唱与器乐段落的区别:
Both artists actively perform the song with perfect lip synchronization, realistic mouth movements, expressive facial expressions, confident body language, and emotional delivery During instrumental moments they naturally interact with each other through elegant movement and subtle choreography
这两句把口型同步的对象、表演状态和没有歌词时应该做什么一起说清楚,模型就不需要让角色从头到尾无意义地张嘴
媒介质感:让视频真正像 Vlog、DV、纪录片或电影
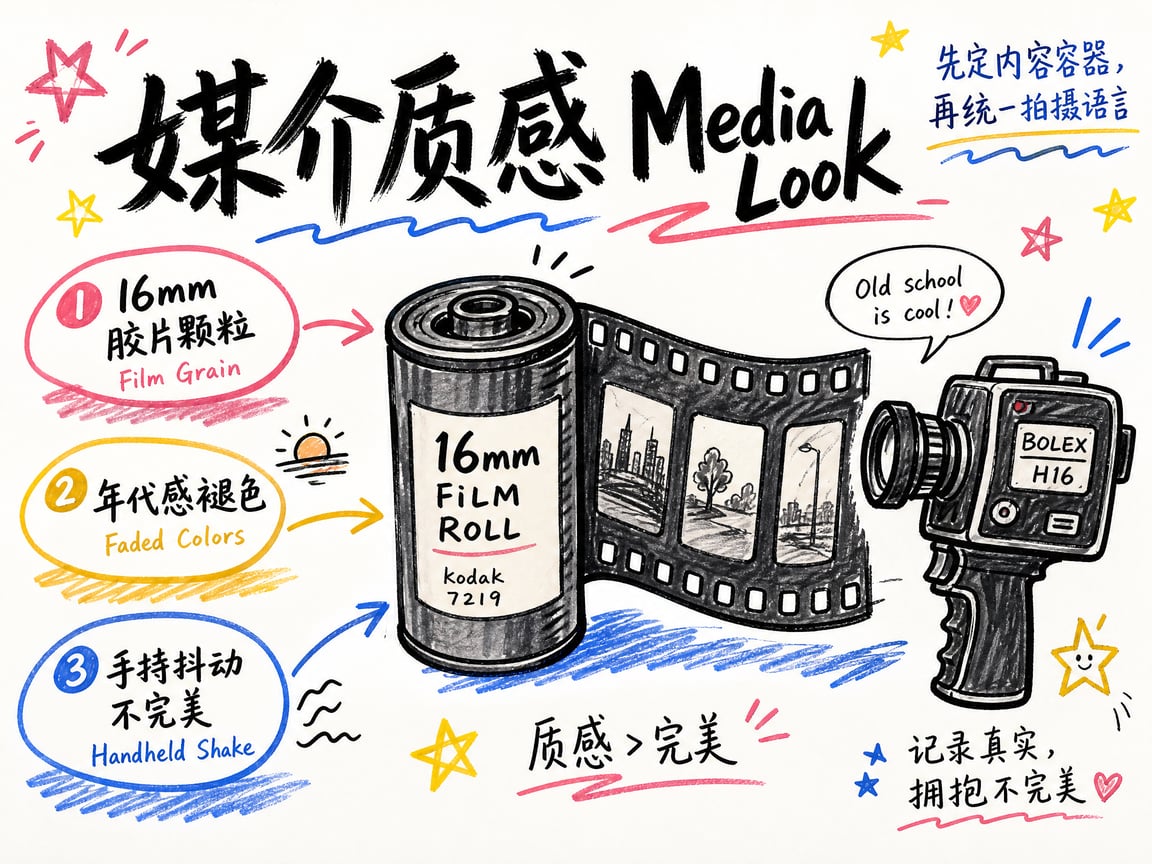
媒介质感不是在 Prompt 末尾堆 8K、电影感和超写实,而是先确定视频属于哪种内容,再用设备、年代、镜头缺陷、曝光和色彩建立一套一致的拍摄语言
内容容器 + 拍摄媒介 + 光学特征 + 运动缺陷 + 曝光与色彩 + 材质表现 + 排除的视觉风格
这条地中海旅行短片想要的不是精致商业片,而是一卷在几十年后被重新发现的 1970 年代 16mm 纪录影像
https://x.com/hey_am_cherry/status/2083561941004685471
Prompt 使用的不是抽象画质词,而是一组属于同一种媒介的具体特征:
Authentic late-1970s Mediterranean documentary captured on vintage 16mm Kodak film, naturally faded colors, subtle film grain, real optical imperfections, slight gate weave Shoulder-mounted handheld camera with imperfect human movement, soft vintage lenses, warm afternoon sunlight, no cinematic polish
褪色、胶片颗粒、片门晃动、肩扛手持和不完美运动都指向同一种旧纪录片质感,画面不会同时像手机 Vlog、现代广告和复古胶片
负向约束:只封堵最可能让这次生成报废的问题
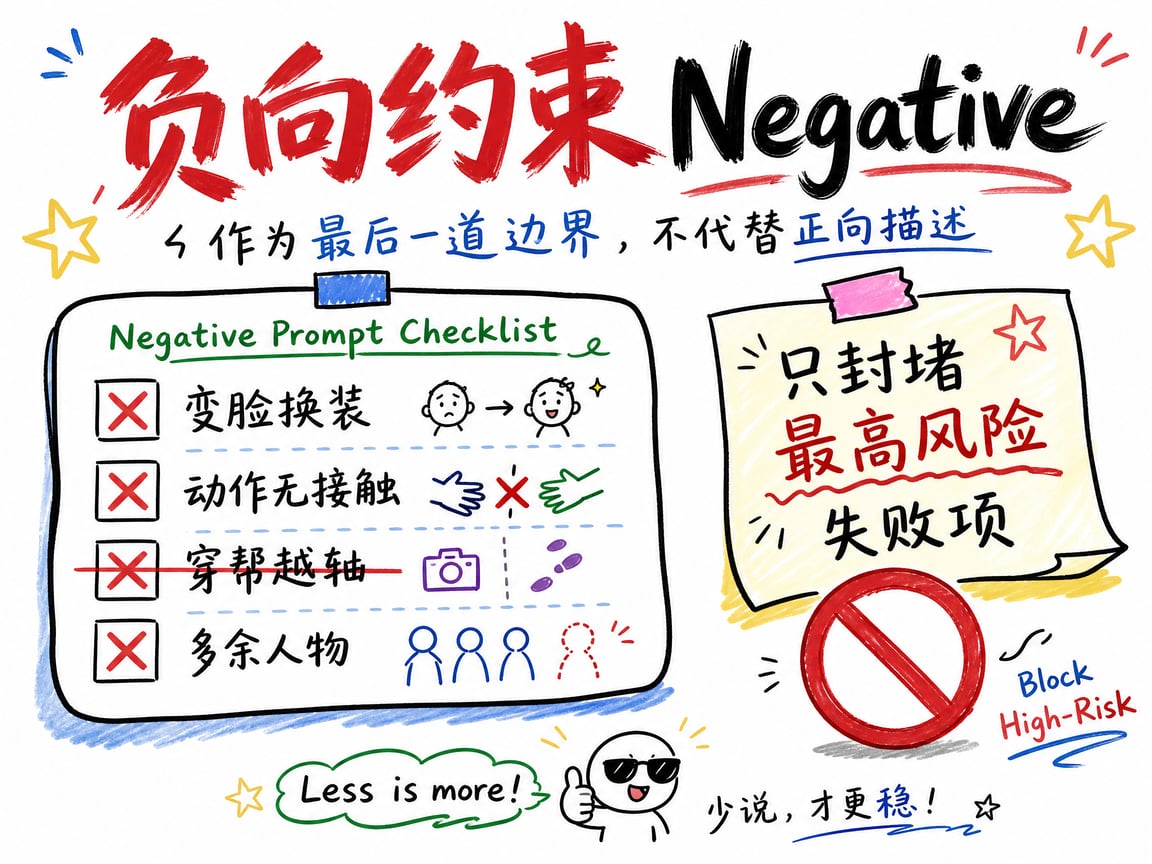
负向约束不是通用禁词越多越好,而是根据当前任务的高风险失败点设置最后一道边界,人物、摄影和物理问题应该分别约束,并明确发生冲突时什么最重要
正向目标 + 高风险失败项 + 约束作用对象 + 约束范围 + 冲突时的优先级
这条 30 秒近身格斗最怕人物交换身份、动作没有接触、摄影机越轴和场景位置变化,因此负向约束全部围绕这些会让战斗无法观看的问题展开
https://x.com/lansenai/status/2083521805176988016
Prompt 中与人物和动作直接相关的部分是:
全程不得交换身份,不得变脸、改变服装颜色、改变体型或生成第三名参战者 禁止隔空挥拳、拳脚穿透身体、没有接触却自行后退、无故旋转、连续空翻、悬浮和夸张飞行
这些限制没有重复描述想要的画面,而是提前封堵格斗视频最常见的报废方式,保住双人身份、真实接触和动作方向比增加一长串通用禁词更重要
三、组合完整 Prompt
真正开始写 Prompt 时,不需要先把前面的 6 种表达结构和 8 种控制策略重新抄一遍喔!上面的内容属于大而全的科普了!
我们要做的事儿是先确定这条视频要交付什么,再选择一种表达结构承载信息,最后只补充当前任务真正需要的控制策略!
顺序很重要,内容容器和表达结构应该先出现,人物、素材、时间、摄影机、动作、声音和媒介控制随后加入,负向约束最后才写,用来封堵已经能够预见的失败,而不是代替正向描述
一条 Seedance 2.5 Prompt 的通用公式
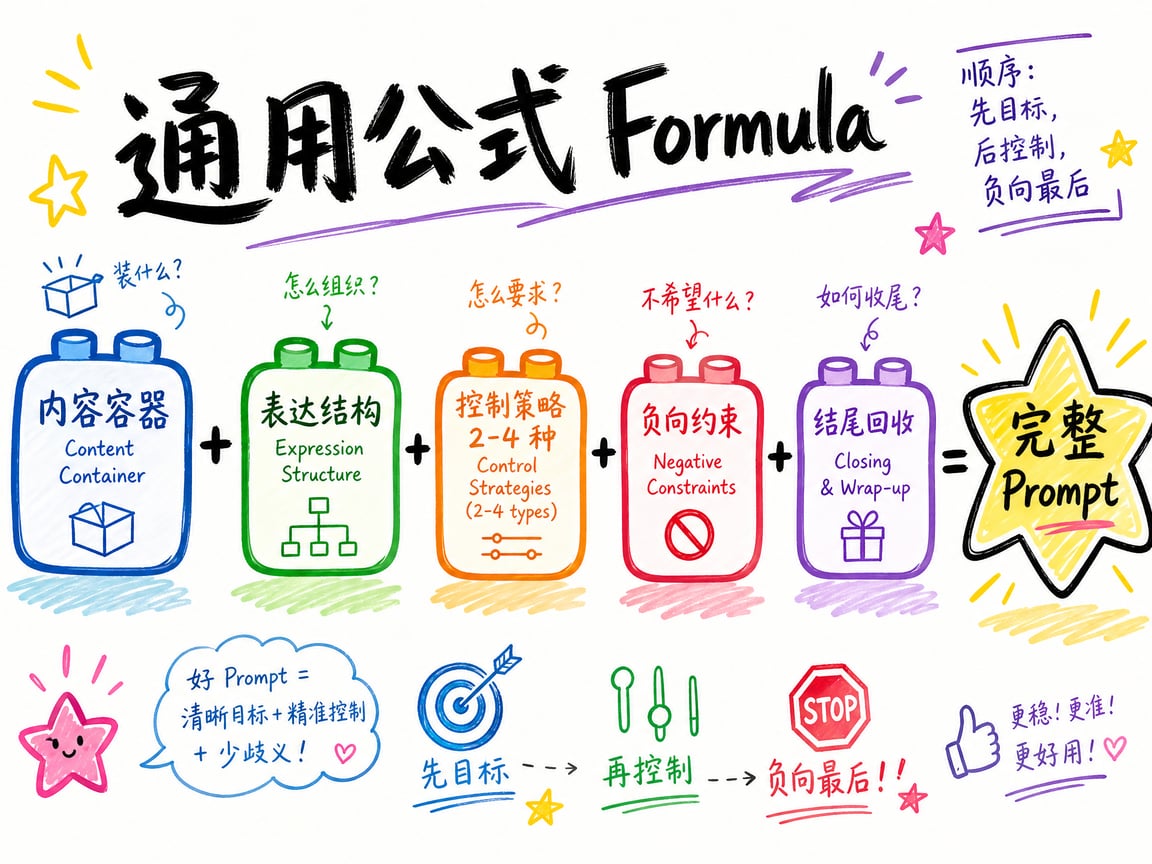
完整 Prompt= 内容容器与成片目标 + 1 种表达结构 + 2 至 4 种必要控制策略 + 段间衔接状态 + 针对性负向约束 + 结尾回收
这条 15 秒洗衣 Vlog 使用连续自然语言叙事作为外层结构,再加入素材映射、媒介质感、声音和负向约束,没有为了显得专业而把所有控制策略都塞进去
https://x.com/doctorwasif/status/2083779989414019109
Prompt 里的几个关键块是:
15s handheld home-video vlog, 7-shot montage A woman (use Image1 only for facial identity and hairstyle) does laundry alone on a quiet morning Sequence: untangles wet clothes → shakes out a shirt → checks a collar stain by the window → hangs it → finds a mismatched sock → struggles with a heavy bedsheet → finishes hanging it Dialogue is natural spoken Korean. Ambient sound only: washer winding down, wet fabric, clothespins, rustling clothes, soft laughter, breeze No subtitles, text, logos, or watermarks
第一行先确定成片是 15 秒 Home Video Vlog,第二行完成素材映射,动作链负责叙事,声音和负向约束只处理这个场景真正需要的风险,这就是一种表达结构与多种控制策略的组合方式
如何根据任务删掉不必要的控制项
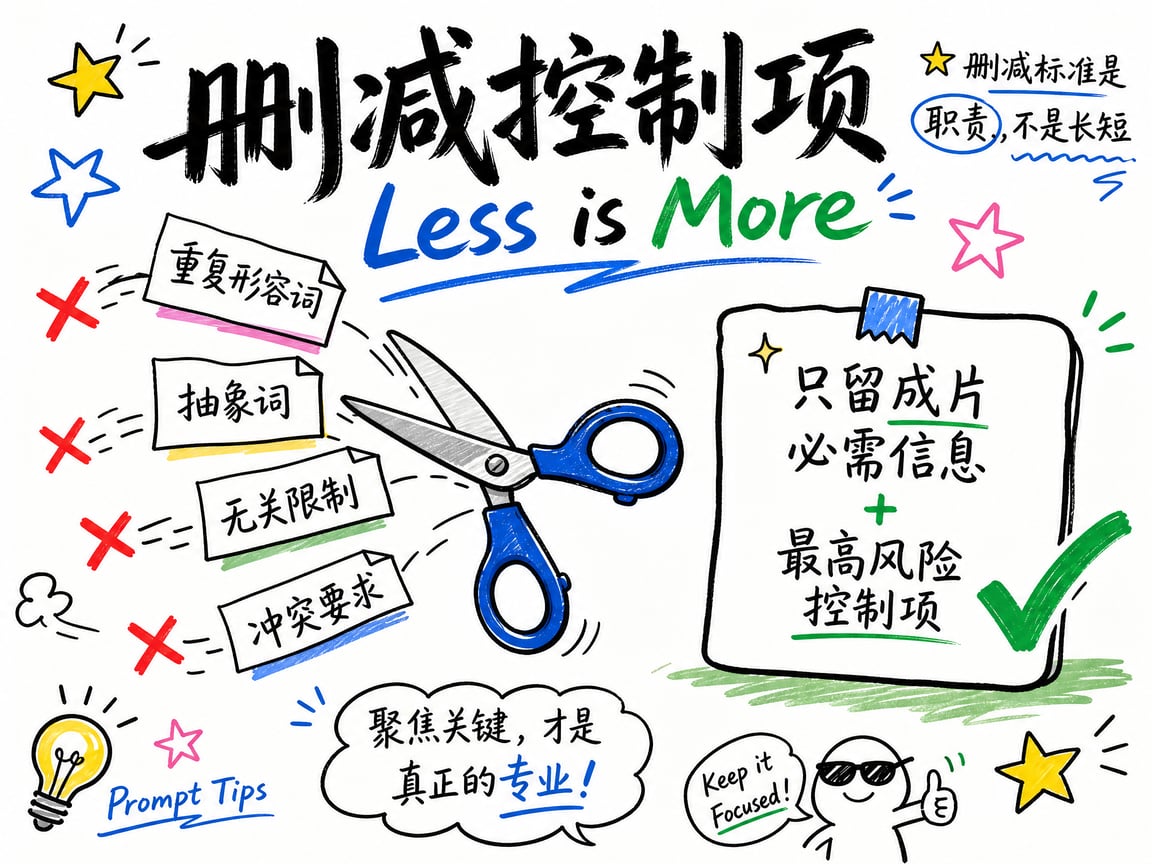
Prompt 不是信息越多越稳定,每一个要求都会与其他要求争夺模型的执行空间,删减时只需要问两个问题,这条信息是否直接影响成片目标,如果删掉它,是否会显著增加报废风险
应该保留 = 成片目标必需的信息 + 当前任务最高风险的控制项 应该删除 = 重复形容词 + 无法验证的抽象词 + 无关限制 + 互相冲突的要求
这个案例的完整 Prompt 只有一句,它没有人物参考、时间轴、摄影机、声音和负向约束,而是把所有视听决策交给模型
https://x.com/arikuschnir/status/2083209950231220403
Make a movie about connection and community
它能成立,是因为任务只要求模型围绕连接与社区完成一部影片,没有角色复刻、产品展示或规定动作需要保护,这个案例不能证明 Prompt 越短越好,但说明不影响成片目标的控制项没有必要硬加
如果同一个任务换成产品广告,产品结构、素材映射和 Logo 稳定性就会立刻变成必需项,删减的标准不是长短,而是这条要求是否承担了明确职责
如何检查动作是否能在规定时间内完成
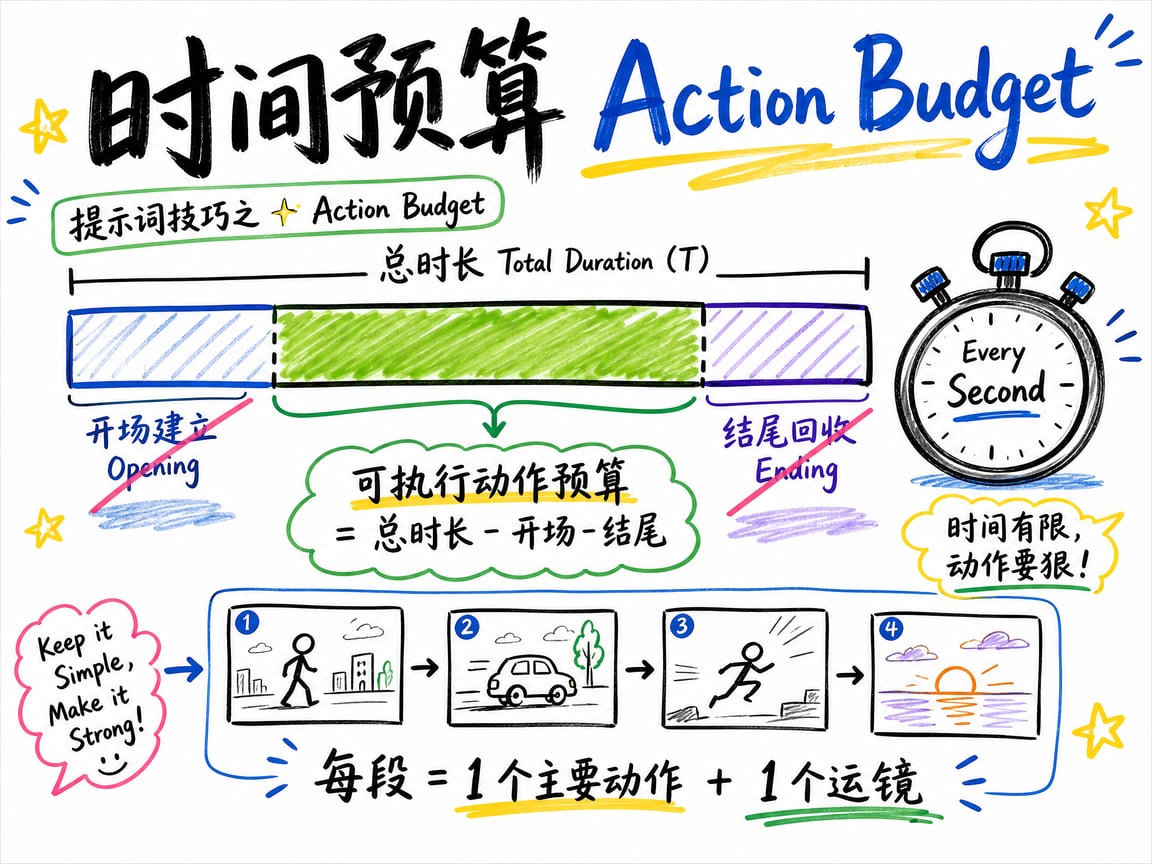
很多 Prompt 不是写得不够详细,而是在十几秒里安排了模型根本来不及完成的事件,检查时要把总时长先扣掉开场建立和结尾回收,再看中间每一段承担了多少新动作
可执行动作预算 = 总时长 - 开场建立时间 - 结尾回收时间 每个时间段 = 1 个主要动作目标 + 1 个主要运镜 + 必要的声音
这条 30 秒武侠动作喜剧先用 2 秒建立包子争夺,再把拔剑、空中争夺、客栈大乱、决胜、反转和收尾分配到连续时间段
https://x.com/johnagi168/status/2083430135152209926
Prompt 的时间骨架非常清楚:
[00:00-00:02] 钩子·同时出手 [00:02-00:06] 拔剑·桌面开打 [00:06-00:11] 空中争夺 [00:11-00:16] 客栈大乱 [00:16-00:21] 决胜一击 [00:21-00:26] 神反转 [00:26-00:30] 傻眼收尾
每一段都有唯一的叙事任务,包子又作为同一个视觉锚点贯穿全程,模型不需要同时理解多条互不相关的动作线
检查自己的 Prompt 时,可以把每个新地点、新人物、新道具和新动作都视为一次执行成本,如果一段三秒内容同时要求换场、说话、拿起产品、展示细节和完成运镜,就应该拆段或删除次要动作
如何为最后 2 至 4 秒预留结尾
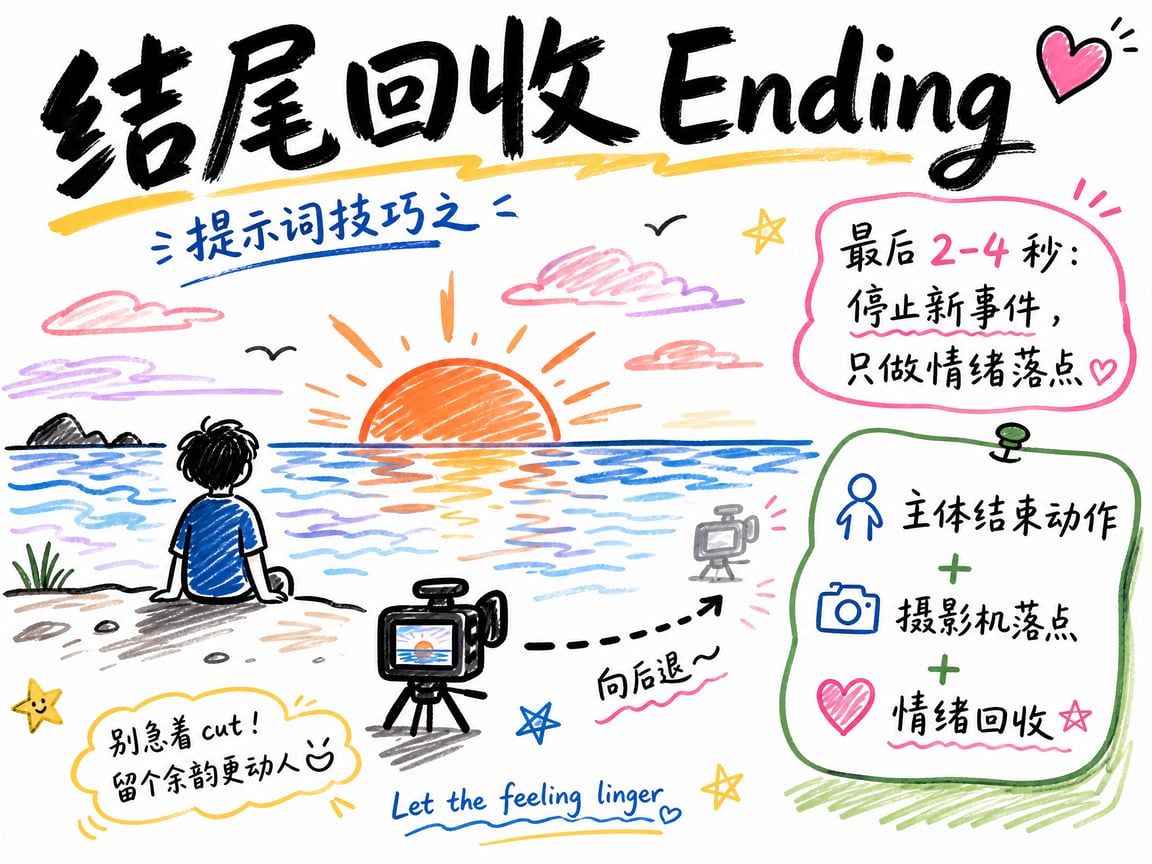
结尾不是把故事写完以后剩下多少秒就用多少秒,而是从一开始就主动保留一段不再增加新事件的时间,让主体完成最后动作,让摄影机停下来,也让观众知道视频已经结束
结尾回收 = 停止增加新事件 + 主体结束动作 + 摄影机最终落点 + 情绪或声音回收
旅行 Vlog 的最后三秒没有继续增加地点和人物,只让主角坐在海边看日落,同时让摄影机缓慢后退
https://x.com/bubblebrain/status/2083659648108990925
Prompt 对结尾的安排是:
27-30s: Ending moment. Golden hour sunset. She sits near the ocean, holding a drink, watching the sunset. The camera slowly moves backward, revealing the beach, waves, and the peaceful evening
主体从行动变成静止,摄影机从靠近变成后退,画面从人物扩展到海滩和日落,三秒只完成一个情绪落点,因此视频不会在上一段活动中突然被截断
三套可以直接复制的实战公式
看了这么多,还是不会写怎么办? 没关系,我帮大家准备了三套最高频场景,可以直接使用的公式
任务链 UGC
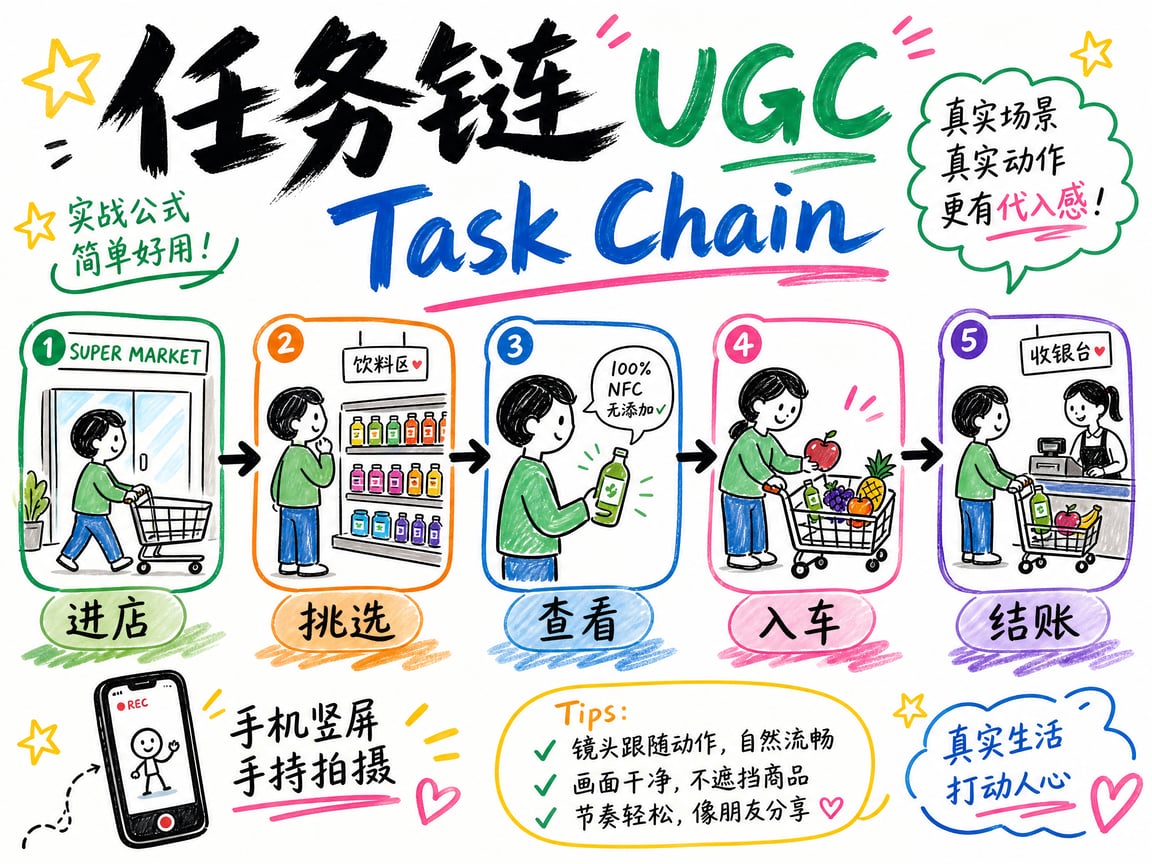
超自然UGC带货内容,可以复用的不仅仅手机画质,还有让人物真的完成一件生活任务,每个镜头都交代上一步的结果,并自然触发下一步
真实拍摄身份 + 一个可完成的生活任务 + 4 至 6 个连续动作节点 + 每个节点的手部或物体反馈 + 手机拍摄缺陷 + 现场环境声 + 完成任务后的自然收尾
这条超市购物 UGC 没有只让人物拿着商品说话,而是把进店、挑选、查看、试喝、放进购物车和走向结账连成了一次完整购物过程
https://x.com/AIwithSynthia/status/2084264050717045019
Prompt 先确定拍摄身份和任务:
A realistic UGC-style lifestyle grocery shopping vlog filmed vertically on a smartphone with natural handheld movement and subtle camera shake
随后用具体动作推动任务:
She walks toward the refrigerated drinks section, scans the shelves, and picks up a green cold-pressed juice bottle, turning it slowly so the label faces the camera Close-up of her hand selecting fresh oranges, gently inspecting one before placing it into the cart Finish with her walking toward the checkout while smiling at the camera, pushing the cart under warm golden lighting
扫描货架之后才拿起饮料,检查水果之后才放进购物车,最后走向收银台,效果像创作者真的完成了一次购物,而不是把人物、商品和超市随机剪在一起
套用时先写清人物要完成的任务,再按真实顺序拆动作,只保留那些会改变人物、商品或环境状态的节点
产品宣传
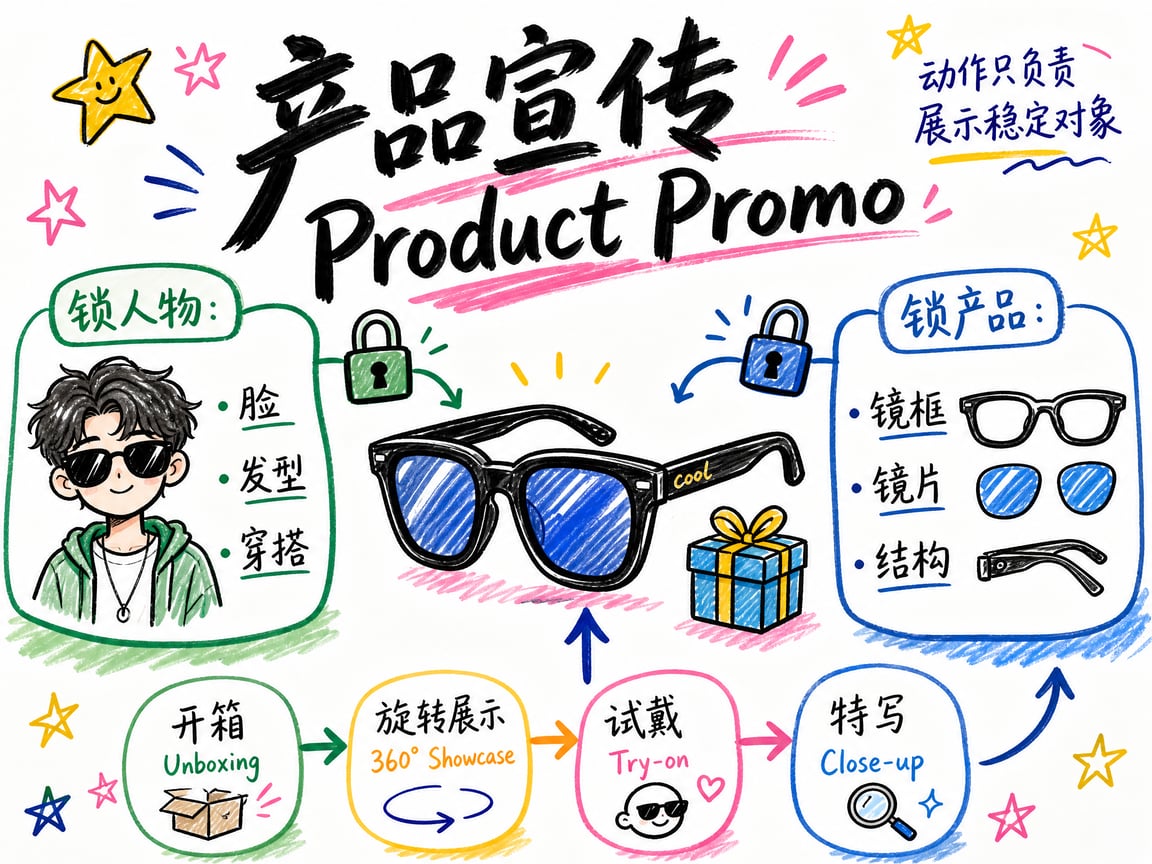
这套写法的重点不是上传更多参考图,而是先分配每张素材的职责,再把人物和产品中不能变化的属性分别锁定,动作只负责展示这些稳定对象
人物素材职责 + 产品或服装素材职责 + 各自必须锁定的属性 + 允许自然变化的属性 + 围绕产品价值的动作链 + 最终展示状态 + 身份漂移与产品变形约束
这条奢侈品太阳镜 UGC 同时使用人物、太阳镜、零售包装和皮质收纳盒,人物负责完成开箱、展示、试戴和评价,产品则必须在不同景别中保持结构一致
https://x.com/AIwithkhan/status/2084608509837275231
Prompt 先分别锁定人物与产品:
Use the uploaded reference image as the exact character reference. Preserve her facial identity, hairstyle, eye color, makeup, skin tone, body proportions, and outfit consistently throughout the video Use the uploaded sunglasses, retail box, and leather carrying case as locked product references. Maintain perfect product consistency, including the frame shape, lenses, hinges, colors, materials, and proportions
随后所有动作都围绕产品展开:
She picks up the box, opens it naturally, reveals the leather case, then slowly removes the sunglasses She rotates the sunglasses slowly in front of the camera, showing the frame, hinges, and lenses The camera slowly pushes in on the sunglasses before fading out
人物身份和产品结构是两套独立的稳定规则,开箱、旋转、试戴和最终特写则构成产品展示链,这样模型不会只顾人物表演,却在镜头变化时改掉镜框、镜片或包装
私人日记 Vlog
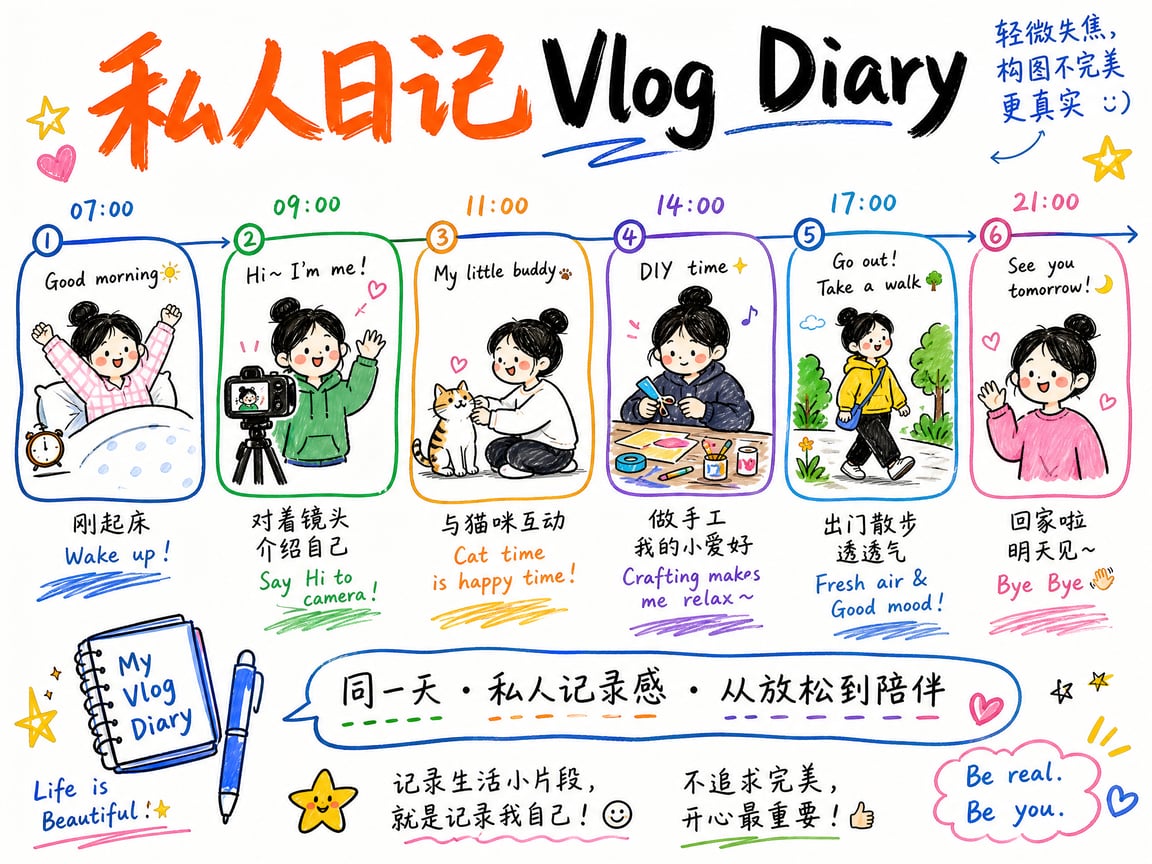
seedance2.5 还有一个没什么人说的点,那就是超真实感,让你分辨不出来这是ai生产还是真人拍摄。
研究了大家的vlog风格的prompt以后,发现这些反复出现的共同点不是旅行地点或 CCD 滤镜,而是先建立人物与观众的私人记录关系,再用同一天里的生活节点持续加深这种关系
固定人物 + 私人记录关系 + 3 至 5 个同一天生活节点 + 每段一个自然动作与随口表达 + 自拍或随手摆放的机位 + 轻微失焦与构图不完美 + 跨场景身份连续 + 温和情绪收尾
这条偶像私人 Vlog 把人物起床、介绍自己、与猫互动、做日常爱好、出门散步和回家告别串成一天,所有节点都服务于让观众更熟悉这个人
https://x.com/BubbleBrain/status/2084013378461478952
Prompt 一开始先排除广告感,确定人物与观众的关系:
Not a commercial, not a music video, but a genuine personal diary captured with a small camera or smartphone The mood is warm, intimate, soft, and slightly nostalgic
接下来才安排一天中的生活节点:
0-8s: Morning bedroom introduction 18-30s: Introducing her cat Bubble 30-45s: Her everyday hobbies 45-55s: A small outside moment 55-60s: Ending the vlog
这些段落不是五个独立场景,人物的状态从刚起床逐渐放松,观众也从认识她、看到她的猫和爱好,走到陪她结束一天,效果更像一篇可以继续连载的人物日记
选择三套公式时只看视频靠什么成立,需要让人物可信地完成一件事就选择任务链 UGC,需要稳定展示人物与产品就选择产品宣传,需要建立持续陪伴感就选择私人日记 Vlog
五种最容易烧钱的 Prompt 写法
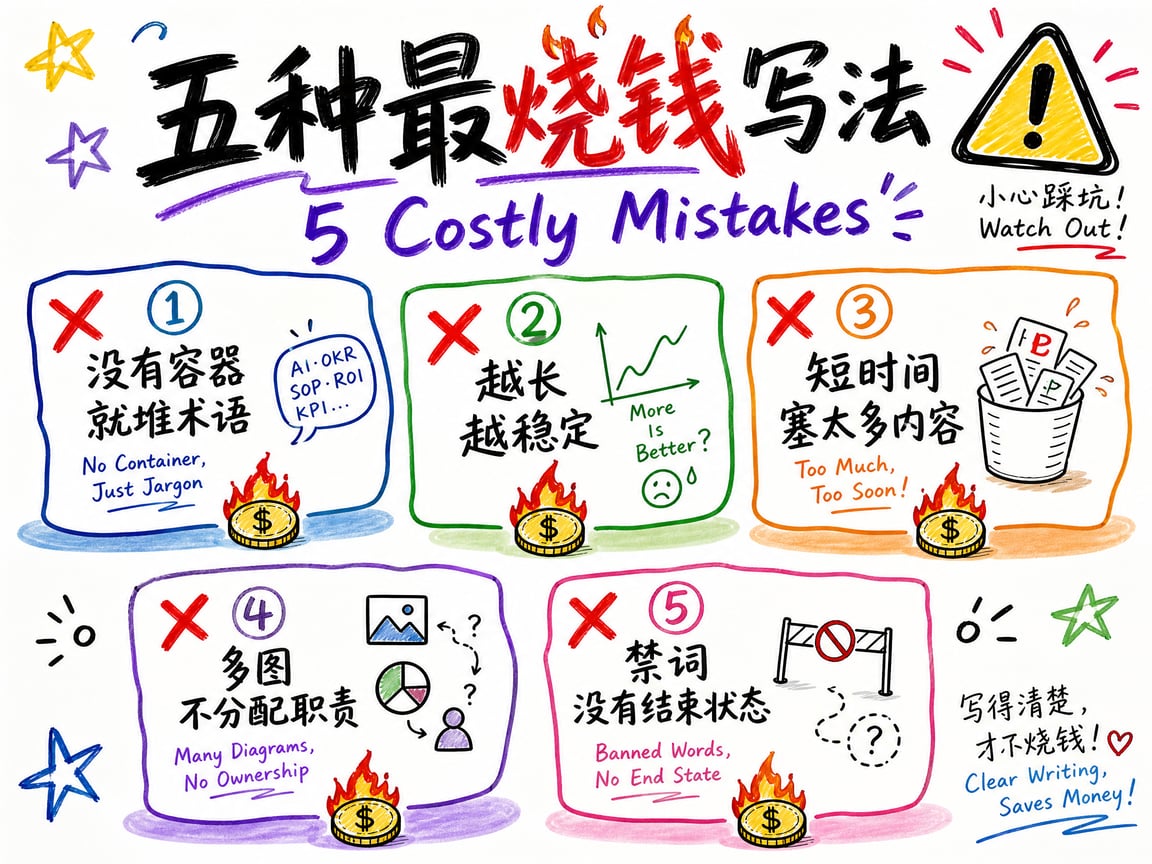
没有内容容器就开始堆摄影术语,只写电影感、浅景深和复杂运镜,模型仍然不知道这是 Vlog、广告还是动作片;先确定观众一眼能认出的内容容器,再让摄影术语为它服务
把 Prompt 越长误认为执行越稳定,重复的形容词反而会淹没真正重要的动作和结果;每一段只保留会改变画面、声音或下一镜状态的信息
在短时间内塞入太多人物、地点和动作,模型很容易漏动作、换身份或直接跳过过程;删到一条主线,并让每个时间段只完成一个主要事件
上传多张参考图却不分配各自职责,人物、服装、产品和背景会互相污染;写清每张图负责什么、继承什么,以及哪些内容不能继承
写了很长的禁止清单却没有明确结束状态,只能减少出错,却不能告诉模型镜头最后要停在哪里;先写清人物位置、手中物体、动作结果和最终构图,再补最关键的三至五条限制
结尾碎碎念
视频越贵,越应该在点击生成前把这些问题解决;先收藏这份指南,下次写 Prompt 时直接回来套公式。希望人人都能生成自己满意的视频
SOURCE NOTE
由林悦己在 X 首发的 Seedance 2.5 Prompt 指南整理